総パラメータ142Bの巨大モデルなのに、推論で実際に動くのは14Bだけ。この非対称な設計を持つLLMが、Dots AI(studio-dots-ai)の「dots.llm1」です。前回の記事では、同社のOCRモデルdots.mocrが図表をSVGコードに変える動きを追いました。今回は原点に戻って、公式のGitHubリポジトリと技術報告を素材に、dots.llm1自体の設計と公開のされ方を掘り下げます[1][2]。
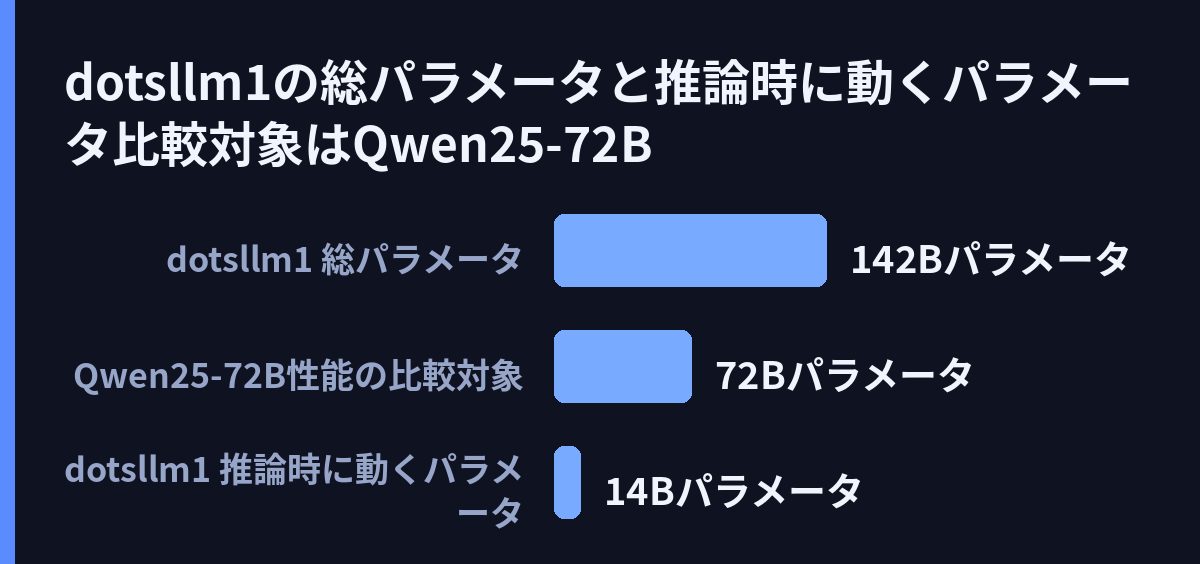
dots.llm1は2025年6月6日に公開された大規模MoEモデルです[1]。MoEは、入力に応じて多数の「エキスパート」と呼ばれる専門ネットワークの一部だけを動かす仕組みです。dots.llm1では、128個のエキスパートの中から6個を選んで計算し、さらに全トークンで共通に使う2個の共有エキスパートを加えます[1]。推論時の計算量を14Bに絞りつつ、知識の総量は142Bで確保する狙いと読めます[1]。学習は事前学習とSFT(指示チューニング)の2段階です[1]。
性能面の主張も具体的です。合成データを使わない高品質コーパスで事前学習した結果、Qwen2.5-72Bに匹敵する性能に達したと説明されています[1]。Qwen2.5-72Bは、全パラメータを毎回動かす従来型(dense)の72Bモデルです。dots.llm1が推論時に動かすのは14Bで、72Bの5分の1以下です。ここがこのモデルの売りです。データ作りにも工夫があって、3段階の処理に分けた独自パイプラインで、大規模で質が高く多様なコーパスを作ったとのことです[1]。
設計の細部も整っています。層数は62、アテンションヘッドは32で、アテンション層にはQK-Normという正規化の仕組みが組み込まれています[1]。特徴的なのは、学習の途中経過まで公開している点です。事前学習の全過程をカバーする中間チェックポイントがオープンソース化され、大規模モデルの学習ダイナミクス(学習が進む中で何が起きるか)を後から追える資料になっています[1]。ベースモデルと指示チューニング済みモデルの両方が公開され、ライセンスはMITです[1]。コンテキスト長は32,768トークン、対応言語は英語と中国語です[1]。
公開の規模も大きめです。リポジトリにはHugging Faceやデモ、WeChat(微信)やrednoteへのリンクが並び[1]、デモも用意されているため、手元にGPUがなくても動きを確かめられます[1]。技術報告はarXivに投稿されて27名の著者が名を連ねています[2]。報告自体はCC BY-NC-NDのライセンスで、モデル本体のMITとは分かれています[2]。
しかし、ローカルで動かす側から見ると、材料はまだ足りません。GPUの枚数やVRAMの内訳、CPU側メモリとの分担といった具体構成も、量子化(重みを圧縮してメモリを節約する仕組み)の適用例も、実測TPSも、素材からは確認できませんでした。以前の記事の実測メモでも、dots.llm1の技術報告からはベンチマークの具体的なスコアもTPSも確認できなかったと書いた通りです。142B級MoEを自宅環境で動かした報告も、この素材群からは見つけられませんでした。公式の主張がどれほどのものか、実機での検証はこれからといった段階です。
ローカルLLM推論をめぐっては、量子化から推論の最適化までを扱う記事[3]や、llama.cppとGGUF(量子化モデルの定番ファイル形式)を解説する記事[3]、量子化の形式ごとの違いを比べる記事[3][3]が出ています。2026年の流れとしては、OllamaやvLLM、SGLangを取り上げる解説もあります[3]。ただしどれもdots.llm1固有の試行ではありません。MoEは動く部分が14Bでも、選ばれなかったエキスパートを含む総142B分の重みを保持する必要があるため、ローカル実行のハードルは総パラメータで決まりやすいと思われます。対応言語に日本語が入っていない点も、日本語ユーザーには制約になります[1]。
dots.llm1の主眼は、性能の高さそのものより「合成データに頼らず、学習の過程ごと公開して作った」という作り方にあるようです。実測データが出そろえば、14Bだけ動かす設計が速度とメモリの面でどこまで実利を発揮するかが見えてきます。次に追うべきは、量子化済みモデルや実測TPSを伴うローカル実行報告の登場です。
引用ソース
- Web記事 記事全文: GitHub – studio-dots-ai/dots.llm1: The official repository of the dots … — https://github.com/studio-dots-ai/dots.llm1
🤗 Hugging Face | 📑 Paper
🖥️ Demo | 💬 WeChat (微信) | 📕 rednote | 𝕏 X
Visit our Hugging Face (click links above), search checkpoints with names starting with dots.llm1 or visit the dots1 collection - Web記事 記事全文: dots.llm1 Technical Report – arXiv.org — https://arxiv.org/pdf/2506.05767v1
%PDF-1.5
%����
1 0 obj
<< /Metadata 3 0 R /Names 4 0 R /OpenAction 5 0 R /PageMode /UseOutlines /Pages 6 0 R /Type /Catalog >>
endobj
2 0 obj
<< /Author (Bi Huo; Bin Tu; Cheng Qin; Da Zheng; Debing Zhang; Dongjie Zhang; - Web記事 Web検索: Local LLM Inference Optimization — From Quantization to Breaking the … — https://ttlab.hopto.org/blog/mlops/2026-06-12-local-llm-inference-optimization-2026?lang=en
Local LLM Inference Optimization — From Quantization to Breaking the …
- Web記事 Web検索: Local LLM Inference : llama.cpp, GGUF, Quantizations and GGML Explained — https://read.theaimerge.com/p/an-ai-engineers-guide-to-running
Local LLM Inference : llama.cpp, GGUF, Quantizations and GGML Explained
- Web記事 Web検索: Local LLM Quantization Explained: GGUF, GPTQ, AWQ, and Bitsandbytes … — https://runaihome.com/blog/local-llm-quantization-explained/
Local LLM Quantization Explained: GGUF, GPTQ, AWQ, and Bitsandbytes …
- Web記事 Web検索: Local LLM Inference 2026 — Ollama, vLLM, SGLang, GGUF Quantization … — https://singularitymoments.com/local-llm-inference-2026/
Local LLM Inference 2026 — Ollama, vLLM, SGLang, GGUF Quantization …
- Web記事 Web検索: LLM Quantization for Local Inference: Formats and Trade-offs — https://techbuzzonline.com/llm-quantization-local-inference/
LLM Quantization for Local Inference: Formats and Trade-offs
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS