GufoはStrix Halo向けオープンソース推論エンジンです。Qwen3.8 Flash-Nextでprefill約1,801 tok/s、decode最大116.93 tok/sが報告され、2台構成のTP2も試されています。速度と品質の両立がうかがえます。
GufoはStrix Halo向けオープンソース推論エンジンです。Qwen3.8 Flash-Nextでprefill約1,801 tok/s、decode最大116.93 tok/sが報告され、2台構成のTP2も試されています。速度と品質の両立がうかがえます。
RTX 3090は24GBのVRAMと帯域で、2026年もローカルAI推論の中心です。14Bで52.1 tok/s、2枚で8エージェント250Kコンテキストなど具体的な報告があります。Flashモデルや画像生成の構成と限界がわかります。
StrataでDeepSeek V4.1 Flashをローカル実行する際、エージェント起動のprefill待ちが約100秒になる問題が注目されました。RedditではKV spliceなどの修正で20倍の高速化が報告され、生成速度だけでなく起動待ちも課題です。
tandem.cppがQwen3.8-Flash-NextをRTX 4090と64GB RAMで97.3 tok/sで動作させ、llama.cpp比で3.3倍と報告されています。MoEのGPU/CPU分担が鍵で、Strataや量子化構成との差も見えます。
H100の現役性とBlackwellの実測差が話題です。2026年時点でH100は主力で、SXM5とPCIeの差、FP8推論、B200がH200比で混合精度1.56倍、省電力42%、キャッシュミス時遅延58%減という検証から、世代より構成が重要だと読み解きます。
ChatGPT、Claude、Geminiの比較は、単一の最強モデル選びから、用途と監視設計の比較へ移っています。OpenAIの仕様更新や4層監視、実務での同時比較が話題です。本記事では、AI選びの新しい軸を整理します。
Gemini SparkがTasksに改名された後も、課金条件や対応端末が揺れています。Chromeのログイン情報を使う自動化は便利ですが、安全策は万全とは限りません。AIエージェントの名前と運用、注意点を追います。
Sam Altman氏は、2026年のIPO見送りに続き、AI業界の減速と安全枠組みについて詳しく語りました。AnthropicやMusk氏との足並み、外部評価者の提案、Always-Onエージェント発表などが中心です。
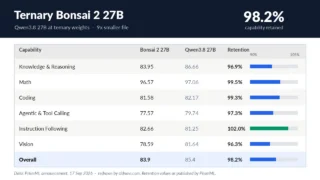
AIモデルのTernary Bonsai 2は27B級を5.9GBに圧縮し、ローカル推論で話題です。ik_llama.cppや専用ビルドでCUDA/CPUが動作し、8GBカードで65〜73 tok/sの報告もあります。制約や設定の落とし穴もわかります。
H100はLLMと推論を最大30倍高速化し、GPT-3 175B学習を4倍速くするとされます。Grace Hopperは10倍を掲げますが、BlackwellのMLPerf席巻には具体的な数値がありません。データセンターの動向を追います。
2026.11.02
Strix Halo専用Gufoが示すローカル推論の速度
2026.11.02
RTX 3090は24GBのVRAMでローカルAIの土台か
2026.11.02
続・Strata:エージェント起動の100秒待ちを短縮
RECENT COMMENTS