OCRモデルの採点者は、なんとGemini 3 Flashです。rednote-hilabの文書解析AI「Dots」シリーズの追跡も、今回は評価の内側に入ります。前回、評価手法と性能ベンチマークを別々にまとめた解説ページが整備されたと伝えました。今回はその中身です。性能の数字を鵜呑みにする前に、その数字の作られ方を知っておきたいところです。同じ3Bクラスで最高水準(SOTA)をうたうdots.mocr[2]の数字が、どんな採点と手順から出るのかを確認します。
評価の中心は、文書解析ベンチマークのOmniDocBenchと、Eloスコアと呼ぶ相対評価です[1][2]。評価系は複数のデータセットと手法を備え、文書の解析、OCRの正確さ、図形の構造化生成まで幅広く測ります[1]。dots.ocrはもともと多言語文書のレイアウト解析を掲げるモデルです[3]。EloスコアではGemini 3 Flashを審査員に立て、モデルの出力を正解データと突き合わせます[1][2]。審査員には、細かい書式の違いは無視するよう指示されています。見るのは本文・表・数式の内容が正確かどうかだけです[1][2]。審査員への指示文を作るスクリプトまで公開されています[1]。
再現の手順も具体的です。まず重みをHuggingFaceかModelScopeからダウンロードします[1]。次に、独自のモデルコードを登録したvLLMサーバーを起動します[1]。vLLMは大規模言語モデルの推論を高速に動かすためのオープンソース基盤です。解析本体はDotsOCRParserというクラスが担い、PDFや画像を読み込んでMarkdownやJSONへ変換します[2]。画像はスレッドプール(複数の処理を同時に走らせる仕組み)で並列処理されます[1]。評価環境のセッティングさえ整えれば、だれでも同じ土俵で測り直せるわけです。
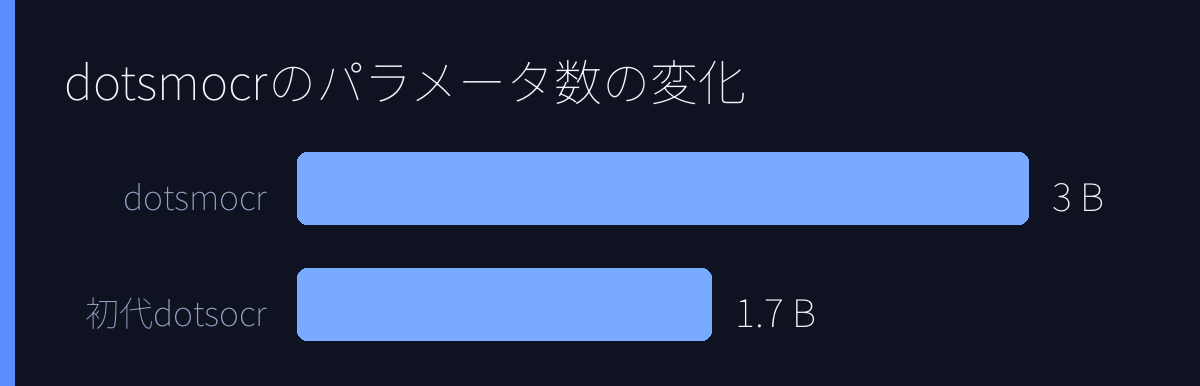
測定対象の厚みも見て取れます。ベンチマークには学術論文・表・複雑なレイアウトが含まれ[2]、10万ページ超の複雑文書で評価されています[2]。シーン内の文字を読むタスクも評価項目です[2]。評価は量的な指標と、競合モデルとの比較分析の両方をカバーします[2]。dots.mocrはdots.ocr-1.5と呼ばれた版の後継です[2]。以前取り上げたdots.mocr追跡記事の実測メモでは、初代の1.7Bから3Bへ約1.8倍の増強とありました。さらにdots.mocr-svgという派生版もあります。こちらは図表などの視覚構造をコードへ変換する用途に最適化されています[2]。
一方で、再現の現場には落とし穴もあります。まず、重みを置くディレクトリ名にピリオドを含めてはいけません。これはモデルライブラリTransformersとの統合に伴う一時的な制約です[1]。保存先はダウンロードスクリプトに決め打ちされています[1]。見落としやすい制約と言えます。また、OmniDocBenchの採点にはヘッダーとフッターを取り除いたMarkdownが必要です。評価スクリプトが解析結果からそれらを抽出し、それから採点に回す作りになっています[1]。素の出力をそのまま採点しているわけではない点は、数字を読むときの留意点です。
もうひとつ気になるのは、Eloの審査員が書式の違いを無視する設計であることです[1]。内容の正確さを優先する合理的な方式です。ただし、レイアウトの整形の質そのものはスコアに反映されにくい面があります。文書解析の実務では見た目の整いも重要なだけに、手元で試した結果とスコアにずれが生じる余地はありそうです。表や図版の見栄えが重要な仕事では、スコアのほかに目での確認も欠かせないでしょう。審査員を外部の大規模モデルに委ねる方式では、審査員の癖が結果に影響しないかという論点も残ります。
コードはGitHubでdots.ocrとdots.llm1のリポジトリが公開され[3][4]、Hugging Faceにはdots.llm1のコレクションも置かれています[5]。論文はarXivで読めます[6]。性能の主張そのものより、その主張を検証する道具まで揃った点が今回の収穫です。学習・評価・公開と、段階を追って情報が出そろってきたシリーズです。ローカルで推論を回すユーザーにとって、数字の裏側が見えることはそのまま信頼につながります。次はこの手順を使った第三者の検証結果が出てくる段階に入ると思われます。
引用ソース
- Web記事 記事全文: Evaluation and Benchmarking | rednote-hilab/dots.ocr | DeepWiki — https://deepwiki.com/rednote-hilab/dots.ocr/7.3-evaluation-and-benchmarking
This page provides a practical guide to reproducing benchmark results for dots.ocr using the OmniDocBench evaluation framework and the Elo score methodology. The system achieves state-of-the-art performance on multiple b
- Web記事 記事全文: Performance Benchmarks | rednote-hilab/dots.ocr | DeepWiki — https://deepwiki.com/rednote-hilab/dots.ocr/1.2-performance-benchmarks
This document presents comprehensive performance evaluation results for the dots.ocr and dots.mocr systems across multiple standardized benchmarks. It covers quantitative metrics, comparative analysis against competing m
- Web記事 Web検索: GitHub – studio-dots-ai/dots.ocr: Multilingual Document Layout Parsing … — https://github.com/studio-dots-ai/dots.ocr
GitHub – studio-dots-ai/dots.ocr: Multilingual Document Layout Parsing …
- Web記事 Web検索: GitHub – studio-dots-ai/dots.llm1: The official repository of the dots … — https://github.com/studio-dots-ai/dots.llm1
GitHub – studio-dots-ai/dots.llm1: The official repository of the dots …
- Web記事 Web検索: dots.llm1 – a rednote-hilab Collection – Hugging Face — https://huggingface.co/collections/rednote-hilab/dotsllm1-68246aaaaba3363374a8aa7c
dots.llm1 – a rednote-hilab Collection – Hugging Face
- Web記事 Web検索: dots.ocr: Multilingual Document Layout Parsing — https://arxiv.org/html/2512.02498v1
dots.ocr: Multilingual Document Layout Parsing
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS