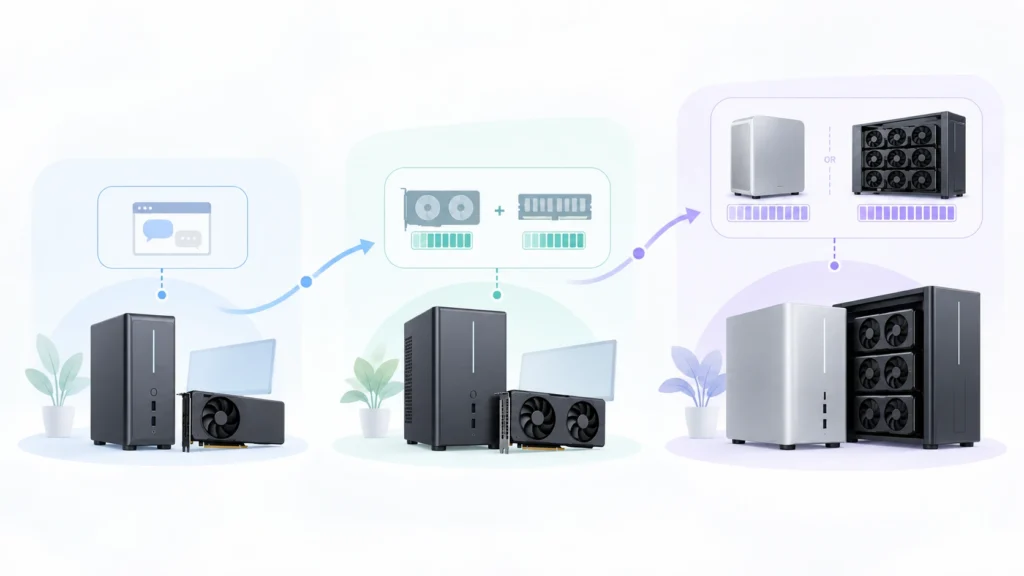
「ローカルLLMは貴族の遊びなのか?」という問いが、5ch ai板で再び話題になっています [8]。ローカルLLMは、自分のPCでAIモデルを動かす使い方のことです。前回は150WミニPCと総費用(TCO)を追いました。今回は、モデルごとに必要なメモリがまったく違う点に注目します。160GB級ミニPCや24〜32GB GPUという現実的な階層も見ていきます。
まずWeb記事では、モデルが違えば組むべきハードウェアも変わると整理されています [1]。日常使いやコーディング向けのQwen3.8-27Bは、24〜32GBの単体GPUが推奨です。中古RTX 3090やRX 7900 XTXなどなら、20万〜30万円台から現実的な選択肢があります [1]。高推論力と長文コンテキストを狙うQwen3.8-Flash-Nextは、モデルサイズが約90〜110GBあります。ただし埋め込みテーブル(語彙の対応表データ)をメインメモリ側へ逃がせる構造です。そのため24〜32GB GPUとメモリ増設、あるいは128GB統合メモリ完成機で実用速度が出せるようです [1]。
一方、ソフトウェア開発(SWE)特化のGLM-5.3-Flashは、4bit量子化でも約175〜196GBのメモリ使用が観測されています。量子化は、重みを圧縮してメモリを節約する仕組みです。192GBでも条件次第で動く余地はあります。ただしOSやKVキャッシュ、実行環境用の余白が小さくなります。KVキャッシュは会話履歴を保持する領域です [3]。継続運用なら256GB級が基準になりそうです [1]。生成速度の体感に関わるDecodeと、長い資料を読み込むPrefillも別物です。Decodeは次のtokenを1つずつ出す処理です。全パラメータを使う通常型のDenseモデルでは、この処理がメモリ帯域に制約されやすいとされています [1]。
5chでは、ローカルAI推論特化型ミニPCの試作・デモ機仕様も投稿されています [2]。持続最大消費電力は150W、対応モデル規模は3B〜120Bです。最大メモリは160GBで、CPUとGPUが1つのメモリを共有するユニファイドメモリ構造になります。最大メモリ帯域幅は1.22 TB/sとされます。中身のXRING O3は3nm・10コアで、GPU 16コアとNPU(AI処理専用回路)200 TOPSを備え、LPDDR6に対応します [2]。さらにXRING O100は、6nmのNPU層の上に2層のメモリチップ(DRAM)を垂直積層します。チップを直接接合するハイブリッドボンディングで、28,672本の有効データ接続線を持つと説明されています [2]。
GPU選びの入口は、もっと手頃な層もあります。Web記事では、新品で始めるなら16GBを出発点にするのが無難とされています [3]。8GBでも小型モデルは試せますが、12B以上へ進むと容量不足を感じやすいようです [3]。1位にはGeForce RTX 5060 Ti 16GBが挙げられました。CUDA対応ソフトの解説例が多い点が評価されています [3]。必要なVRAM(GPU上のメモリ)は、量子化後のモデル重み、KVキャッシュ、実行環境、安全余裕の合計で考えます。48GB以上は個人向けよりワークステーション領域です [3]。加えてCUDAやROCmなど対応する実行環境の種類、電源容量、カードの長さと厚み、排熱も確認項目に挙がっています [3]。
ローカルLLMの「セット」はGPU一枚で決まりません。モデル、量子化、コンテキスト長(一度に読める文章量)、KVキャッシュ、実行環境の組み合わせで変わります。そのため入口・中級・上級の段差はくっきりしています [1][3]。複数GPU運用の落とし穴にも踏み込んでいますが、具体的な枚数や速度差のデータはありません [1]。
ただし「高性能化で誰でも買える」と単純化するのは危険です。素材には実測tok/sやエンジン別の比較数値が十分にありません。検索結果にはベンチマーク記事やスペックガイドのタイトルが見えます。ただ速度・電力・構成の差までは確認できていません [5][7]。160GBミニPCは120B級を想定しています。GLM-5.3-Flashの4bit量子化で約175〜196GBという数値を並べると、256GB級との差は小さくないようです [1][2]。スレッド内には本題と無関係な攻撃的投稿も混在しており、技術判断には使えません [4][6]。
結局、ローカルLLMは「全員向けの安価な遊び」でも「一部の貴族だけの遊び」でもないようです。入口は16GB GPUから設定できます。ただ長文推論や超大規模検証へ進むほど、メモリ容量と帯域幅の階層がはっきりします [1][3]。150Wで160GB・1.22 TB/sを狙う試作機は、貴族化への反撃に見えます。ただ256GB級を必要とするモデルとはまだ重なりません [1][2]。今後の追跡では、推論エンジンの実測tok/sと国内実売価格の差を、具体的な数字で確認したいところです。価格の目安は、GPU単体20万〜30万円台から128GB・256GB級まで幅があります [1]。これは推測ですが、階層は当面残ると思われます。
引用ソース
- Web記事 記事全文: ローカルLLM向けGPU・PCの選び方【2026年版】実測tok/sと必要メモリ比較 — https://chimatome.com/articles/local-llm-gpu-guide-2026/
ローカルLLMの導入を検討するとき、誰もが最初に直面するのが「結局どのGPUやPCを買えばいいのか」という問題です。
かつては「VRAMが一番大きいGeForceを買えばいい」というシンプルな話でした。しかし、モデルアーキテクチャの多様化とメモリ技術の進展が進んだ現在、その前提は崩れつつあります。
単一GPUにすべて収める構成、GPUとシステムRAMを併用するオフロード構成、128〜256GB級のユニファイドメモリ(統合メモリ)を活用す - 5ch 5ch AI板 投稿>>494 (ローカルLLMは貴族の遊びなのか?) — https://krsw.5ch.io/test/read.cgi/ai/1760713315/494
## ⚙ 基本システム構成 * 製品タイプ: ローカルAI推論特化型ミニPC(試作・デモ機) * 持続最大消費電力: 150W * 対応AIモデル規模: 30億(3B)〜 最大1200億(120B)パラメータのローカル実行 * 最大メモリ容量: 最大160GB(ユニファイドメモリ構造) * 最大メモリ帯域幅: 1.22 TB/s(1,220 GB/s、Near-Memory帯域) * ## 🧠 搭載プロセッサ(トリプル自社開発XRING
- Web記事 記事全文: ローカルLLM向けGPUおすすめランキング|VRAM別・モデル規模別に選ぶ【2026年8月版】 — https://shirorashi.com/article/local-llm-gpu-buying-guide-ranking-2026
ローカルLLM向けGPUおすすめランキング|VRAM別・モデル規模別に選ぶ【2026年8月版】
目次13項目
ローカルLLMを始めるためにGPUを選ぼうとすると、「同じ16GBならどれでも同じなのか」「RTX 5080のような高速GPUと、24GBの旧世代GPUはどちらが向いているのか」という疑問が出てきます。
結論からいうと、ローカルLLM用GPUは演算性能より先にVRAM容量を決め、次に実行ソフトの対応状況を確認するのが基本です。高 - 5ch 5ch AI板 投稿>>5 (ローカルLLMは貴族の遊びなのか?) — https://krsw.5ch.io/test/read.cgi/ai/1760713315/5
以前から言われてる「マジでユーモアセンスが終わってるただただクッッッソ寒いAI生成ショート」に、自分で「生誕祝い」のタイトル付けて39連投もして視聴者のタイムラインを埋め尽くす、オワコンの『いつものただの空気読めない独りよがりなアスペルガー過ぎる迷惑ムーブ』🥶 https://imgur.com/dbLApjj.jpeg sub:i.ibb.co/XxLRhtVF/image.jpg マジで「クラスの注目を集めたくて天才を自称するイタい
- Web記事 Web検索: ローカルLLMに必要なPCスペック|GPU・VRAM・メモリの選び方ガイド【2026年版】 | Harmonic Society — https://harmonic-society.co.jp/local-llm-pc-specs-gpu-guide/
ローカルLLMに必要なPCスペック|GPU・VRAM・メモリの選び方ガイド【2026年版】 | Harmonic Society
- 5ch 5ch AI板 投稿>>4 (ローカルLLMは貴族の遊びなのか?) — https://krsw.5ch.io/test/read.cgi/ai/1760713315/4
以前より、5chアウトロー板「YouTuber小山恵吾🗿」スレに「統失ホモチョンヒトモドキ🧑🏻🦱」と呼ばれる粘着ネトスト反日荒らしが出没。 会話の流れや言動、あまりの語彙の香ばしさや「Xのポエムとの共通点」等からスレ民に何度も中身がDaiGoだとバレる。 『メンタリスト』を自称するも、実は科学も心理学も専攻外の無資格・無実績の口から出任せの自分語りしてるだけの「ただの詐欺師」で、Z李に薬物乱用ホモを暴露された事もあるメンヘラキモ男の松
- Web記事 Web検索: Benchmarking Local LLMs in 2026: Speed, Quality, Resource Usage — https://dasroot.net/posts/2026/04/benchmarking-local-llms-speed-quality-resource-usage/
Benchmarking Local LLMs in 2026: Speed, Quality, Resource Usage
- 5ch 5ch AI板: ローカルLLMは貴族の遊びなのか? — https://krsw.5ch.io/test/read.cgi/ai/1760713315/
ローカルLLMは貴族の遊びなのか?
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。



RECENT COMMENTS