「£300のミニPCが、GPUなしのまま大規模モデルを動かした」——こんな報告がRedditのr/LocalLLaMAで話題になっています[1]。舞台はLenovoのSnapdragon搭載ミニPC。しかも鍵を握ったのは、投稿者が自作した推論エンジンです。GPUを積まない小さな筐体で、ローカル推論がどこまで伸ばせるのかを探る、ハッカー的なカルチャーならではの挑戦です。
機種はLenovo IdeaCentre Miniです。CPUはSnapdragon X X1-26-100で、8つのOryonコアとHexagon NPU(AI処理に特化した回路)を搭載します。メモリは32GBのLPDDR5で、モデルは標準の512GB NVMeからストリーミングで読み込みます[1]。購入価格は£299.99。eBayやAmazonでも400ポンド未満で入手できる価格帯です[1]。このセットアップの面白い点は、Adreno GPUを使わず、計算をCPUコアで賄っていることです。NPUもGPUも使わない構成のようです。さらに2台をUSB4ケーブル1本でつなぐ、合計£600の構成でも実験しています。
ソフトウェアの経緯も独特です。投稿者はまずllama.cppで試し、すぐにJanasというエンジンへ移行しました。そのうえでARM向けに移植し、NEONカーネル(ARMのCPUを高速化するコード)やWindows on ARMビルド、キャッシュバグ修正をPRとして還元しています。修正はすでにJanas側のリリースにも取り込まれました[1]。そして現在は、自作エンジンToRc(コードネーム、未公開)で測定しています。結果はQ4量子化(重みを圧縮してメモリを節約する仕組み)での数値です。A3BタイプのMoEモデルが、読み込み315トークン/秒・生成43トークン/秒を出しました。MoEは、全部のパラメータを毎回使わず一部だけを動かして計算を減らす構造のモデルです。Flash Nextでは読み込み46・生成20トークン/秒でした。
NPUの実力を整理するベンチマークもあります[2]。GitHubで公開されたのは、Snapdragon X Elite / X2 Eliteでの計測です。Windows 11 ARM64上で、ONNX Runtimeという実行環境からQNN経由(QualcommのNPUを呼び出す経路)を使い、Qwen 2.5 7B Instructをint4で動かしています。int4は4ビット幅に圧縮する量子化の型です。文脈長64から8192の範囲で比べた結果、NPUはprefill(プロンプトの読み込み)でCPUの2.4〜4.6倍速かったです。ただし生成はCPUが優位です。差は文脈長64で約1.6倍、8192では約1.25倍に縮まるものの、逆転はしませんでした。なおX2 Eliteでは、従来のX EliteよりCPU・NPUともに数値が伸びています[2]。
この結果を受けて、次の目標はハイブリッド実行です。NPUで長いプロンプトの読み込みを担い、生成はCPUへ切り替える構成を試す計画です。切り替えに使うKVキャッシュ(生成途中の計算結果を保持するデータ)は、形状と型がNPU側・CPU側で一致しており、受け渡しは機械的に実現可能と報告されています[2]。読み込みと生成で得意な側が違う以上、自然な発想と言えそうです。
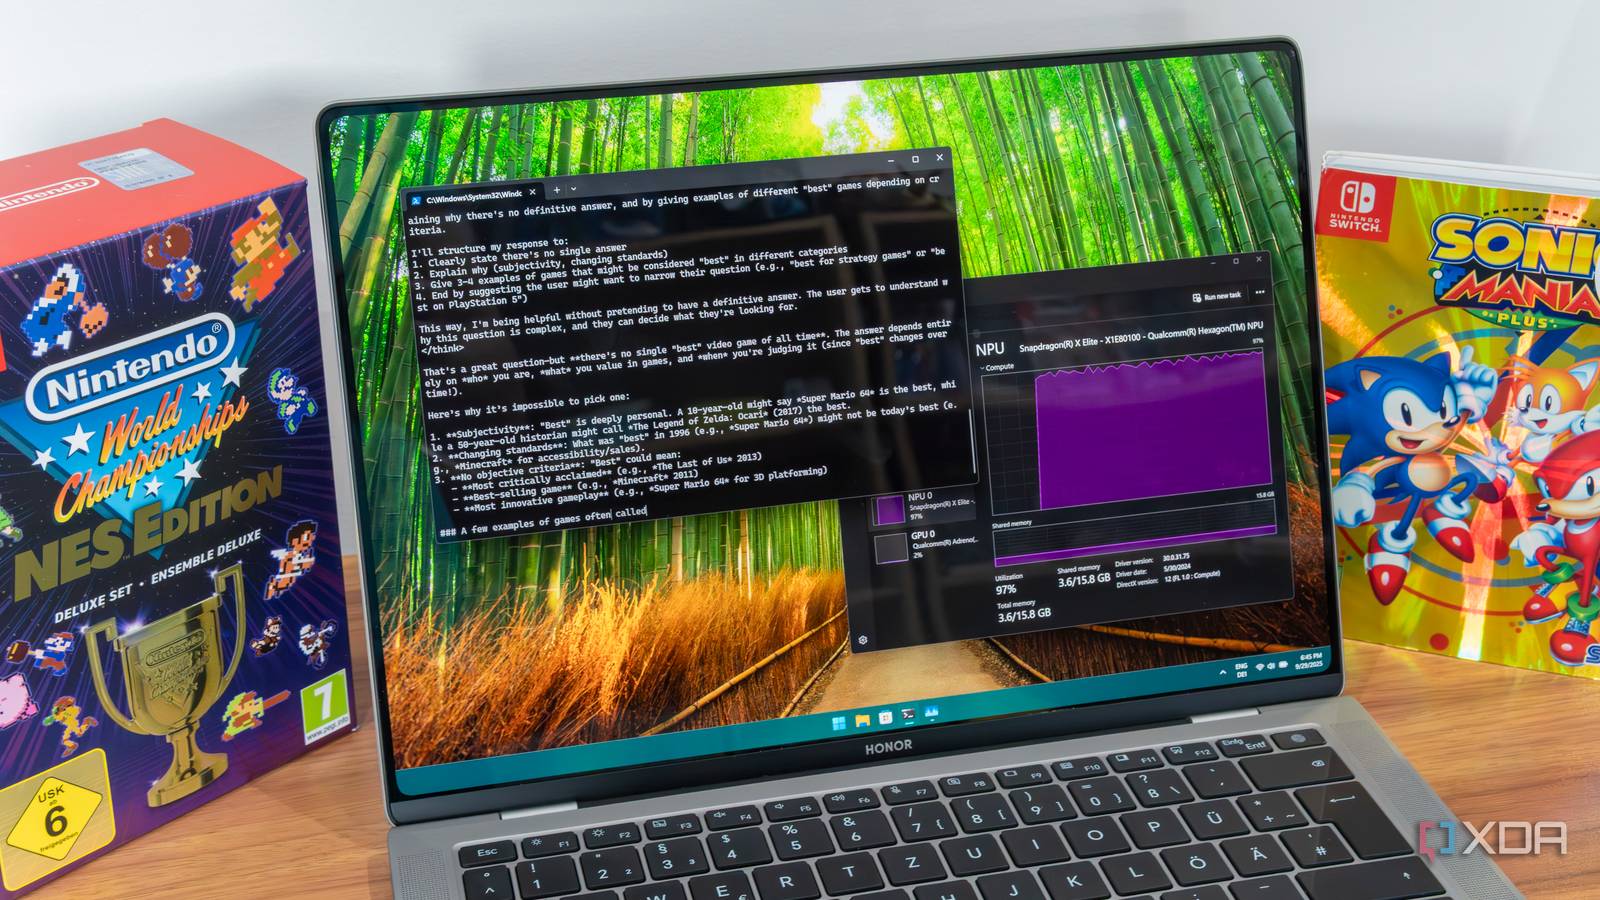
一方で、NPU単体にはまだ壁もあります。XDAのテストでは、Nexa SDK経由でNPU対応のLlama-3BやPhi4-mini、Qwen3-4Bなどを動かし、動作は「思ったより良い」と評価しました[3]。Nexa自社のOmniNeural-4Bは、ローカルで動く唯一のマルチモーダル(複数形式に対応)モデルという[3]。Qwen3-4Bには深い推論を行うthinkingモデルも用意されています。ただしNPU向けモデルは約4B(40億パラメータ)クラスが上限で、より大きなモデルには大容量RAMを持つハードウェアが必要とされています[3]。£300報告の高速化も、看板のNPUではなくCPUコアの働きです[1]。AI PCの主役がまだ交代していないのが実情のようです。
それでも示唆は大きいです。MoEモデルと量子化を組み合わせれば、GPUなしの安価なARMミニPCでも実用帯の速度が出せるからです。80B A3Bクラスをローカルで動かす条件を解説する記事も登場しており[4]、関心はさらに大規模側へ広がっています。£600で2台構成にできる点も、拡張のしやすさとして印象に残ります。読み込みはNPU、生成はCPUという分担が実装されれば、長い資料を読ませる用途での快適さも上がると思われます。省電力ミニPCがローカル推論の定番候補になっていく日も、そう遠くないかもしれません。
引用ソース
- Reddit Reddit r/LocalLLaMA: Q4 flash next for £300/600 👀 – snapdragon mini PC results update – 315/43 Tok/s A3b, 46/20 Tok/s Flash Next (read/gen) 💥 — https://www.reddit.com/r/LocalLLaMA/comments/1xcmioz/q4_flash_next_for_300600_snapdragon_mini_pc/
Q4 flash next for £300/600 👀 – snapdragon mini PC results update – 315/43 Tok/s A3b, 46/20 Tok/s Flash Next (read/gen) 💥
- Web記事 記事全文: Snapdragon X Elite / X2 Elite LLM Benchmarks – GitHub — https://github.com/dakehero/snapdragon-xelite-llm-example
Running and benchmarking int4 LLM inference on Qualcomm Snapdragon NPU via ONNX Runtime QNN Execution Provider on Windows ARM64.
Platform: Windows 11 ARM64 on Snapdragon X Elite / X2 Elite + Python 3.14. Not compatible w - Web記事 記事全文: I tested local LLMs on the Snapdragon X Elite's NPU, and they're … — https://www.xda-developers.com/these-llms-run-locally-snapdragon-x-elite-npu-surprisingly-good/
As LLMs have grown in popularity, the ability to run them locally has also become somewhat sought after. And it’s not always easy, as the raw power required for running a lot of language models isn’t something you can ty
- Web記事 Web検索: Qwen3 Coder Next 80B A3B: what it takes to run it locally — https://www.hardware-corner.net/qwen3-coder-next-hardware-requirements/
Qwen3 Coder Next 80B A3B: what it takes to run it locally
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。

RECENT COMMENTS