27Bモデルの設計が変わる――そんな情報が、推論エンジンvLLMの周辺から一瞬だけ姿を見せました。ローカルでAIを動かすハッカー気質の愛好者が集う掲示板r/LocalLLaMAで、vllm-xpu-kernelsというリポジトリのPR(変更提案)がQwen4-27Bの大きなアーキテクチャ変更を示し、その直後にページが404になったと報告されています[1]。
vLLMは大規模言語モデルをGPUで高速に動かす、定番のオープンソース推論エンジンです。新モデルの検証が真っ先に行われる場所でもあります。投稿者によると、消えたPRは層を流れる情報の通り道(残差ストリーム)を1本から4本の並列に増やす内容でした。27Bという限られたパラメータ数で情報の流れを良くし、性能を引き出す狙いがあるようです[1]。確証のない段階ですが、実質的な深さが伸びればマルチステップの推論やコーディングが大きく伸びる可能性に期待する声が出ています[1]。投稿者はflash版のMoEよりも27Bの方を注視しているとも述べています[1]。なお、Xの日本のトレンドには「GPT-6.1Terra」や「バベルのSoranji」[3]の語も上がっていますが、中身は確認できないため本稿では扱いません。
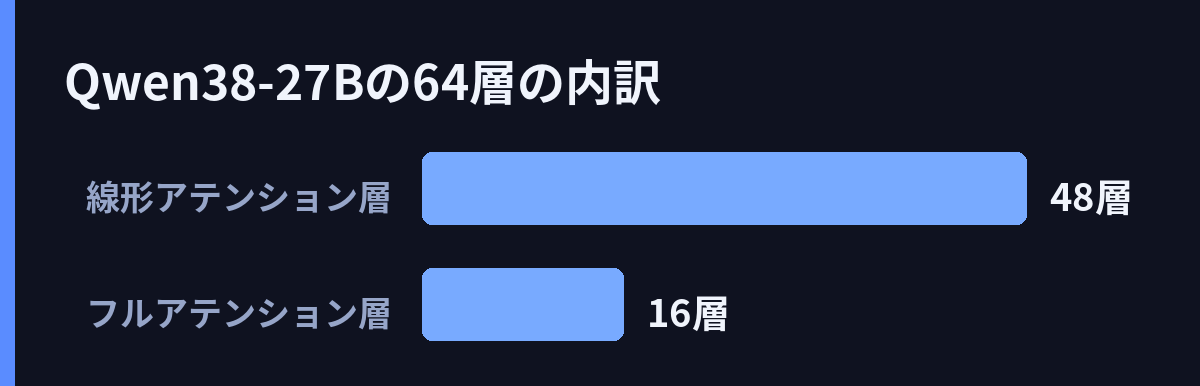
公式のvLLM Recipesには、Qwen3.8-27Bの動かし方が詳しく載っています[4]。このモデルは27Bのdense(全パラメータを毎回使う通常型)で、2.4TのMoEフラッグシップと同じハイブリッドアテンション基盤を持ちます[4]。注目は層構成です。64層のうち、全トークンを見るフルアテンションは16層だけ。残り48層は、過去情報を一定サイズの状態に圧縮して保持する線形アテンションが担います[4]。4層ごとに1層の割合でフルアテンションを挟む設計で、長い文脈でもメモリと計算を抑えられます[4]。また画像入力に対応するマルチモーダルモデルで、設定には画像処理用のvision_configが含まれます[4]。
動かし方も具体的です。文脈長は最大262144トークンまで設定でき、NVFP4やFP8、MXFP4といった量子化(重みを圧縮してメモリを節約する仕組み)済みモデルが用意されています[4]。KVキャッシュ(会話の履歴を保持するメモリ領域)をFP8で圧縮する指定も使えます[4]。GPU1枚で動かす構成から、1つのモデルを複数GPUに分割して載せるテンソル並列(TP)で4枚に載せる構成まで、コマンド例が示されています[4]。KVキャッシュを最大に確保する構成として、GB300トレイ1台でTP4とするFP8の例もあります[4]。生成を速めるMTP(次の複数トークンをまとめて予測する仕組み)は、3トークン分の指定で追加できます[4]。検証はvLLM 0.26.1rc1で行われ、NVFP4ではBlackwell世代GPUでエミュレーションではなく本物のCUTLASSカーネルが選ばれることも確認されています[4]。
しかし、最新機能に追いかける側の苦労も見えてきます。MultihopSpatialというベンチマークの評価コード解説では、32Bクラスの大規模評価にはPagedAttentionを備えたvLLMが推奨されています[2]。PagedAttentionは、KVキャッシュをページ単位で管理してメモリの無駄を減らす仕組みです。標準のTransformersを使うスクリプトは、デバッグ用の参照実装として残されています[2]。一方で落とし穴も報告されています。NVLink(GPU間を高速につなぐ専用配線)を持たないPCIeのみの環境では、テンソル並列のP2P通信が固まることがあるのです。P2PはGPU同士が直接メモリをやり取りする通信で、NCCL(GPU間通信のライブラリ)の初期化中に停止します。評価スクリプトは構成を自動検出し、P2Pを無効にする設定を入れて回避します[2]。
コミュニティの検証も広がっています。RTX 5090でQwen3.8-27Bを動かす手順書がGitHubに公開され[5]、4bit量子化のベンチマークでは「4bitでもエージェント用途には十分」との趣旨の報告が上がっています[5][5]。推論プロバイダー同士のFP8速度比較(Fireworks対Together)も行われています。さらに、ミドルサイズのdenseモデルでは、モデルを分割するテンソル並列より、同じモデルの複製で処理を振り分けるデータ並列の方がスケーリングに有利とする分析もあります[5]。ただしこれらの検証は、素材ではタイトルや概要程度の情報しか得られませんでした。速度やVRAMの具体的な比較数値は見つかりませんでしたので、ここでは数字を補わずに留めます。
ここまでを見ると、vLLMは新アーキテクチャの予兆が最初に現れる場所であり、公式レシピとコミュニティの試行が集まる検証の中心です。Qwen4-27Bの情報は削除済みで確証がなく、公式発表を待つ段階です。一方でQwen3.8-27Bには、ハイブリッドな層構成、複数の量子化、並列化の選択肢がそろっています。27Bクラスを実際に動かすための型が、見え始めてきたといえるでしょう。
引用ソース
- Reddit Reddit r/LocalLLaMA: Qwen4-27B’s 4-way HC shift? — https://www.reddit.com/r/LocalLLaMA/comments/1xftcj0/qwen427bs_4way_hc_shift/
Qwen4-27B’s 4-way HC shift?
- Web記事 記事全文: Open-Source Model Evaluation (Qwen vLLM and Transformers) — https://deepwiki.com/youngwanLEE/multihopspatial/2.1-open-source-model-evaluation-(qwen-vllm-and-transformers)
This page provides a technical deep dive into the evaluation infrastructure for open-source models within the MultihopSpatial benchmark. It focuses on the implementation details of benchmark_qwen_vllm.py and benchmark_qw
- X Xトレンド: バベルのSoranji — https://trends24.in/japan/
バベルのSoranji
- Web記事 記事全文: Qwen/Qwen3.8-27B | vLLM Recipes — https://recipes.vllm.ai/Qwen/Qwen3.8-27B
Qwen3.8-27B is the 27-billion-parameter dense member of the Qwen3.8 family, on the same hybrid-attention backbone as the 2.4T MoE flagship.
The layer mix is the interesting part. Only 16 of the 64 layers run full attenti - Web記事 Web検索: GitHub – tsarihan/qwen3.8-27b-rtx5090-playbook: Serving Qwen3.8-27B in … — https://github.com/tsarihan/qwen3.8-27b-rtx5090-playbook
GitHub – tsarihan/qwen3.8-27b-rtx5090-playbook: Serving Qwen3.8-27B in …
- Web記事 Web検索: Data-parallel scaling beats tensor-parallel for mid-size dense models … — https://hiddenstate.io/bottleneck/data-parallel-scaling-beats-tensor-parallel-for-mid-size-den
Data-parallel scaling beats tensor-parallel for mid-size dense models …
- Web記事 Web検索: Qwen3.8-27B-4bit Benchmarks: Speed, VRAM & Quality | llm-bench.io — https://llm-bench.io/models/qwen3-8-27b-4bit
Qwen3.8-27B-4bit Benchmarks: Speed, VRAM & Quality | llm-bench.io
- Web記事 Web検索: Qwen3.8 27B Quantization Benchmark: 4-Bit Is Enough for Agentic… — https://ralmodiel.github.io/ai-study-library/notes/03-llm-fundamentals/2026-08-30-qwen3-8-27b-quantization-benchmark-4-bit-is-enough-for.html
Qwen3.8 27B Quantization Benchmark: 4-Bit Is Enough for Agentic…
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS