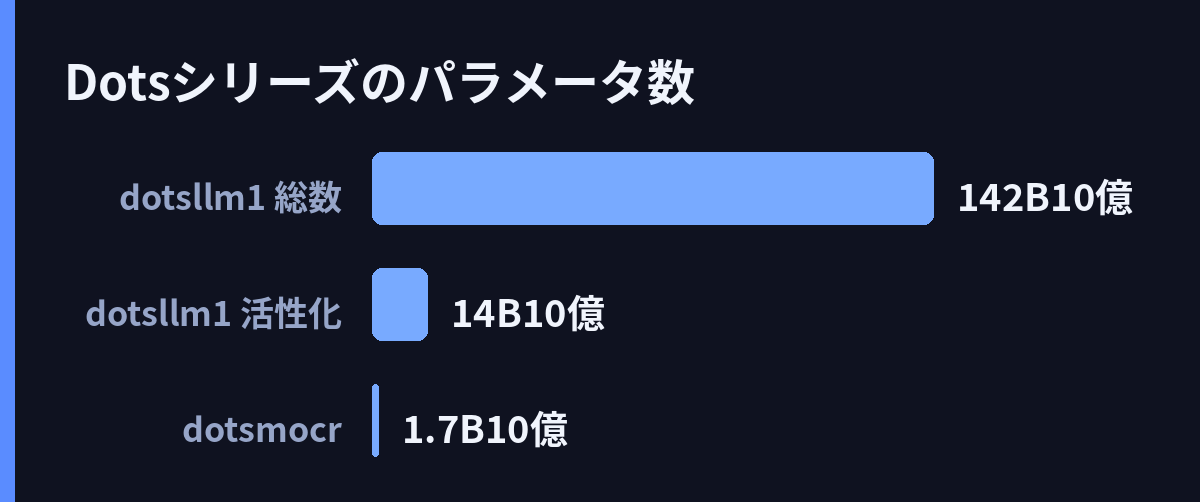
図表を画像として説明するのではなく、SVGコードに直接変換する。OCRモデルdots.mocrは、そんな独自の方向性を打ち出しています。もともとの名前はdots.ocrで、2026年3月19日に改名されました[2]。重みはHugging Faceでdots.mocrとdots.mocr-svgの2種類が公開されています[2]。前回の記事では、総数142B・活性化14BのMoEモデルdots.llm1(2025年6月6日公開、MITライセンス)の技術報告を追いました[1]。今回は同じDotsシリーズのOCR系モデルの進展と、ローカル推論をめぐる動きを整理します。
dots.ocrは2025年7月30日に公開された、1.7BのLLMをベースにした多言語文書解析モデルです[2]。ほぼすべての人間の文字体系を認識できることを特徴とし、同程度のサイズのモデルの中では、標準的な多言語文書解析でSOTA(最高水準)の性能を示してきました[2]。その後、2025年10月31日にはOCRタスクに特化した基盤VLM(画像とテキストをまとめて扱うモデル)のdots.ocr.baseも公開されています[2]。こちらはdots.ocrの土台となるモデルです。
改名後のdots.mocrの目玉は、視覚言語の統一処理です。チャートや図解、化学式、ロゴといった要素には、濃密な人間の知識が込められています。dots.mocrはこれらを種類ごとに別処理にせず、直接SVGコードへ変換することで統一的に解釈します[2]。SVGは画像を図形の命令として記述するテキスト形式です。コードにできれば、編集や再利用がしやすくなります。変換結果の評価には、UniSVGに収録されたISVGENという指標が使われています[2]。さらにWeb画面の解析や、写真の中の文字を見つける処理にも対応しました[2]。
ローカル推論をめぐる環境も動いています。1.7Bという小型さは、手持ちのGPUでも動かしやすいサイズです。デプロイと推論の方法をまとめた解説ページがすでに作られており[5]、vLLM(大規模モデル向けの推論エンジン)向けの派生リポジトリも現れています[3]。さらに有志が公開したGGUF形式(llama.cpp系のツールで使われる重み形式)の版もあり[4]、手元の環境で動かす選択肢が広がっているようです。GitHubの開発元はstudio-dots-aiという組織名で[1]、Hugging Faceではrednote-hilab名義でモデルが公開されています[4]。
しかし、性能の実態がつかみにくいのが現状です。READMEにはOmniDocBench(文書解析のベンチマーク)やolmocrという別プロジェクトの指標、Eloスコア(相対的な強さを比べる指標)の評価が並びます[2]。olmocr由来の指標には、独自の内部評価も組み合わせられています[2]。とはいえ素材からは、具体的な数値を読み取れませんでした。しかもOmniDocBench1.5の数式と表の指標は、検出やマッチングの方式に結果が左右されやすいとして、あえて省略されています[2]。
比較の条件も揃っていません。Gemini 3 ProやPaddleOCR-VL-1.5、GLM-OCRの結果はAPI経由で得られており、HunyuanOCRだけがローカル推論です[2]。Elo評価に使われたのはGemini 3 Flashで、結果はocrarenaでの評価とも一致しています[2]。pdf-parse-benchの結果は、Qwen3-VL-235B-A22B-Instructで再現されたものです[2]。以前取り上げたdots.llm1の技術報告の実測メモでも、ベンチマークの具体的なスコアもTPSも含まれていませんでした。今回の素材にも、dots.mocrの実測TPSや消費電力の数値は見つかりませんでした。
それでも方向性ははっきりしてきました。Dotsシリーズは、142BのMoEであるdots.llm1[1]から1.7Bのdots.mocr[2]まで、用途に応じたサイズをそろえつつあります。1.7Bなら手元のGPUでも回せるため、文書処理の流れに組み込みやすいと思われます。SVGコードとして出力できれば、解析結果をテキストのまま後段の処理につなげられるでしょう。改名により旧名の情報をたどりにくくなった面もあります。それでも、図表をコードに変える独自の強みを軸に、次に注目したいのは実測値の公開です。
引用ソース
- Web記事 記事全文: GitHub – studio-dots-ai/dots.llm1: The official repository of the dots … — https://github.com/studio-dots-ai/dots.llm1
🤗 Hugging Face | 📑 Paper
🖥️ Demo | 💬 WeChat (微信) | 📕 rednote | 𝕏 X
Visit our Hugging Face (click links above), search checkpoints with names starting with dots.llm1 or visit the dots1 collection - Web記事 記事全文: GitHub – studio-dots-ai/dots.ocr: Multilingual Document Layout Parsing … — https://github.com/studio-dots-ai/dots.ocr
dots.ocr Designed for universal accessibility, it possesses the capability to recognize virtually any human script. Beyond achieving state-of-the-art (SOTA) performance in standard multilingual document parsing among mod
- Web記事 Web検索: GitHub – kalufinnle/vllm.dots.ocr: Multilingual Document Layout Parsing … — https://github.com/kalufinnle/vllm.dots.ocr
GitHub – kalufinnle/vllm.dots.ocr: Multilingual Document Layout Parsing …
- Web記事 Web検索: README.md · prithivMLmods/dots.ocr-GGUF at main – Hugging Face — https://huggingface.co/prithivMLmods/dots.ocr-GGUF/blob/main/README.md
README.md · prithivMLmods/dots.ocr-GGUF at main – Hugging Face
- Web記事 Web検索: Deployment and Inference | rednote-hilab/dots.ocr | DeepWiki — https://deepwiki.com/rednote-hilab/dots.ocr/5-deployment-and-inference
Deployment and Inference | rednote-hilab/dots.ocr | DeepWiki
- Web記事 Web検索: README.md · rednote-hilab/dots.ocr at main – Hugging Face — https://huggingface.co/rednote-hilab/dots.ocr/blame/main/README.md
README.md · rednote-hilab/dots.ocr at main – Hugging Face
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS