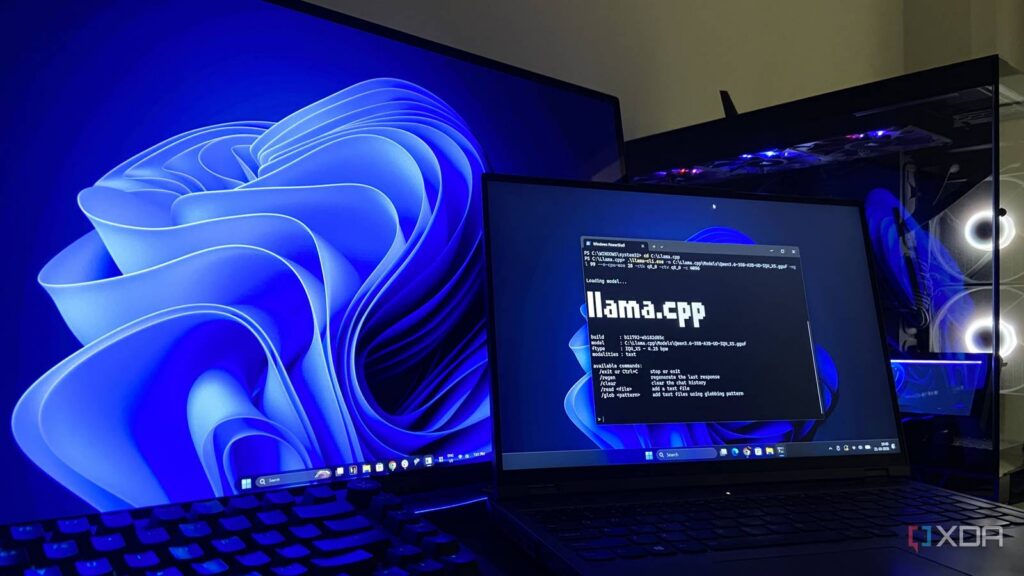
「VRAM 8GBのノートPCでは、35Bモデルは無理」——そう思い込んでいた壁を、設定の工夫だけで越えたという報告が相次いでいます。Hacker Newsには、llama.cppの上に層を重ねてスマホやノートPCで巨大なMoEモデルを動かす「BigMoeOnEdge」というプロジェクトが投稿されました[1]。MoE(Mixture-of-Experts、入力に応じて複数の専門家ネットワークのうち一部だけを動かす構造)なら、メモリの少ない機材でも大きなモデルを扱える可能性があります。
わかりやすいのが、XDAのライターによる実験です。著者は8GBのRTX 3070 Mobileを搭載したLenovo Legion 5を使いました。16GBのRTX 4070 Ti Superで動かしているモデルの一部は、このノートPCでは「最初から対象外」と決めつけていたと明かしています[2]。PCの動作はVRAMの容量に左右されがちで、ゲームも動画編集も例外ではない——そう述べた上で、著者はローカルAI推論には回避策があるとしています[2]。環境をOllamaからllama.cppへ移し替えて各機能を試す中で、VRAMの少ないシステムを最適化できることに気づいたといいます[2]。
デスクトップのRTX 4070 Ti Superでは、Qwen3.6-35B-A3Bがテストした中で最速でした。量子化はIQ4_XSという型(重みを圧縮してメモリを節約する仕組み)で、コンテキストは32Kです。17.7GBのモデルファイルが16GBのVRAMに収まるはずがありません。しかしMoEでは、35Bのうち推論で動くのは約3Bで、残りは待機しています。待機のエキスパート層をシステムRAMへ移し、常時動く部分だけGPUに置けば、数字上の壁を越えられます[2]。
具体的な指定は2段階です。まず全層をGPUへ載せ、その上でエキスパート部分だけを前からN層分RAMへ戻します。この指定が–n-cpu-moeというフラグです[2]。こうした手法の解説も増えています。aliteqはVRAMより大きいローカルAIモデルを動かすオフロードガイドを公開しました[4]。Hugging Faceのブログには、GPUアクセラレーションと組み合わせてMoEのCPU推論を速くするガイドが投稿されています[5]。大規模MoEモデルの推論性能を最適化する手順をまとめたGistもあり[6][7]、llama.cppのMoEアーキテクチャを解説するDeepWikiのページも作られています[8]。
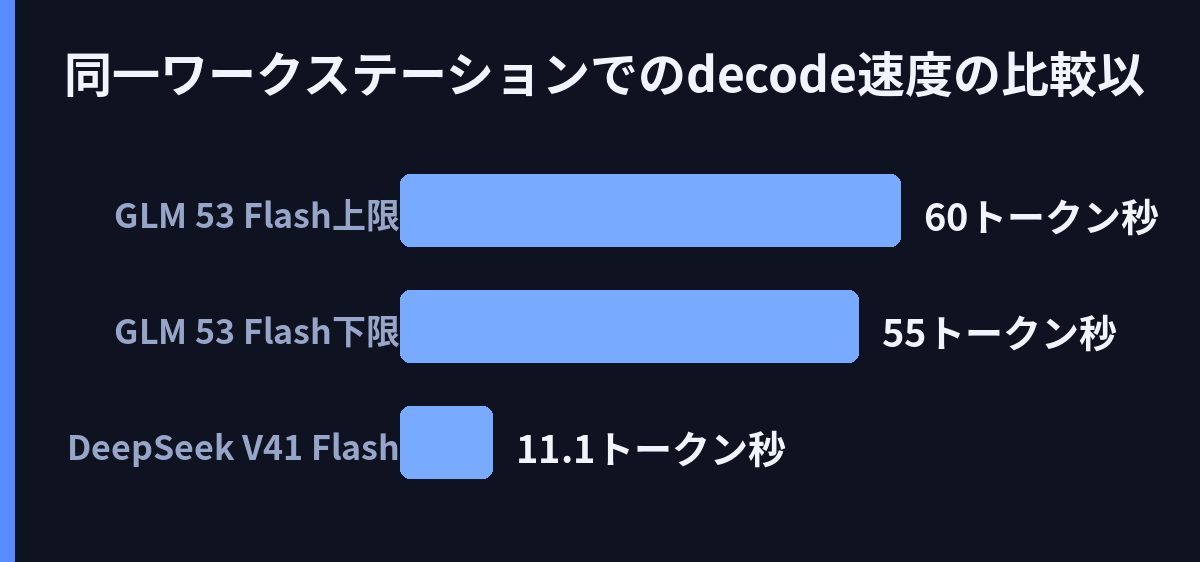
以前取り上げたのは、llama.cppのMoE層でスマホや省スペース機に巨大モデルを載せる試みです。RTX 3060を2枚、Xeon E5-2696 v4、RAM 256GBのワークステーションで実測が行われました。decode(トークンを1つずつ生成する段階)の速度は、DeepSeek V4.1 Flashで約11.1トークン/秒でした。GLM 5.3 Flashでは約55〜60トークン/秒です。prefill(プロンプト全体を一括処理する段階)は約1,100〜1,500トークン/秒を記録しています。prefillの速度は、長いプロンプトやコードベースの取り込みの速さを左右します。また、llama.cpp-moe-streaming-coreというリポジトリが公開されています。そのREADMEは、依存ライブラリなしのC/C++実装やApple silicon向け最適化といったllama.cpp本来の説明を掲げています[3]。llama.cppを土台に拡張を重ねる試みが増えていることがうかがえます。
しかし、まだ道半ばです。Hacker Newsの投稿は現時点で1ポイント・コメント0件で、注目はこれからです[1]。どの機材でどの速度を出せたかの実測値も、投稿からは確認できませんでした[1]。XDAの記事も、8GBノートでの動作を「妥当な速度」と表現するにとどまり、具体的な速度の数値は載っていません[2]。RAMに置いた層の扱い次第で速度が変わるため、層の配分などの調整が不可欠のようです。最適化手順を解説するガイドが複数出ていることからも、設定が自明でないことはわかります[5][6]。
MoEの「使う部分だけ動く」性質が、VRAM容量という固定の壁をRAMとの分担で崩しつつあります。専用レイヤー[1]と実践ガイド[4][5]が揃ってきました。エッジデバイスでの大規模モデル実行は、特殊な実験から選択肢の一つになりつつあるようです。スマホでの実測報告が増えるかどうかが、次の注目点になりそうです。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B … — https://www.xda-developers.com/i-stopped-thinking-my-8gb-gpu-was-too-small-after-learning-to-offload-moe-llm-layers-to-ram/
A lot of what you can do with your PC seems to be limited by the VRAM its GPU has. It decides what resolution your games run at, how large a video project you can edit without the timeline stuttering intermittently, and
- Web記事 記事全文: llama.cpp-moe-streaming-core/README.md at main – GitHub — https://github.com/bigA151/llama.cpp-moe-streaming-core/blob/main/README.md
LLM inference in C/C++
– Hugging Face cache migration: models downloaded with -hf are now stored in the standard Hugging Face cache directory, enabling sharing with other HF tools.
– guide : using the new WebUI of llama. - Web記事 Web検索: Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide … — https://aliteq.com/llama-cpp-moe-offloading-run-bigger-models-less-vram
Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide …
- Web記事 Web検索: Performant local mixture-of-experts CPU inference with GPU acceleration … — https://huggingface.co/blog/Doctor-Shotgun/llamacpp-moe-offload-guide
Performant local mixture-of-experts CPU inference with GPU acceleration …
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0/65fa7ddf731559eec9e34e9a1d21933e4e9b5bee
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: Mixture-of-Experts (MoE) Architectures | alesha-pro/llama.cpp | DeepWiki — https://deepwiki.com/alesha-pro/llama.cpp/5.2-mixture-of-experts-(moe)-architectures
Mixture-of-Experts (MoE) Architectures | alesha-pro/llama.cpp | DeepWiki
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。


RECENT COMMENTS