古いGPU 2枚で27Bのモデルを毎秒60トークン。以前から注目してきたQwen3.8-27Bの60tps報告に、今回ついにセットアップの詳細が判明しました。Hacker Newsに投稿されたのは「2x Tesla P100、q6_k量子化、約60tps」という短い報告です[1]。tpsは1秒間に生成できるトークン数のことです。この連載では以前、Qwen3.8-Flash-Nextのローカル実演や60tps報告のその後を追ってきました。今回は報告の中身と、ローカル推論を支える技術の動きを見ていきます。
きっかけはコメント欄でした。「どんなシステムで動かしているのか」という質問に対し、投稿者が環境を明かしています[3]。それによるとマシンはDell製で、OSはLinux Mintだったとのことです。Tesla P100はデータセンター向けの旧世代GPUです。以前取り上げた27Bの追跡では、古いV100 2枚の構成で60tpsが報告されていました。今回の投稿ではTesla P100 2枚との表記で、構成の輪郭が少しずつはっきりしてきた形です。なおq6_kは量子化(重みを圧縮してメモリを節約する仕組み)の型名のひとつです。
こうした個人の試行を下支えするのが、Qwen本家の速度データです。公式ドキュメントのSpeed Benchmarkでは、Qwen3シリーズの速度とメモリ使用量が公開されています[4][5]。対象はbfloat16(16ビットの浮動小数点形式)のモデルです。これに加え、FP8・GPTQ・AWQといった量子化モデルの数値も並んでいます。条件はバッチサイズ1で2048トークンを生成するというものです。入力長は1トークンから129,024トークンまで6段階に変えて測定します[4]。長い文書を扱うときに速度がどう変わるかまで追えるデータです。測定には可能な限り少ない枚数のGPUが使われます[4]。また推論エンジンのSGLangはGPUメモリを先に確保してしまうため、メモリ使用量は報告対象外です[4]。
ローカル動作の幅を広げるもう一つの動きが、量子化技術の進歩です。Hugging Faceでは、Qwen3-32BのGGUF形式(量子化済みモデルを扱うファイル形式)を作ったユーザーが、1〜2ビットという超低ビット向けの新しい量子化手法を公開しました[2]。手法はDynamicGateと名付けられています。特徴は層ごとに精度を使い分ける点です。モデルの最初と最後の25%の層は精度を高く保ち、中間の50%は圧縮率を優先します。埋め込みと出力の層は高精度で保護し、誤差の伝播を38%減らしたと説明されています[2]。

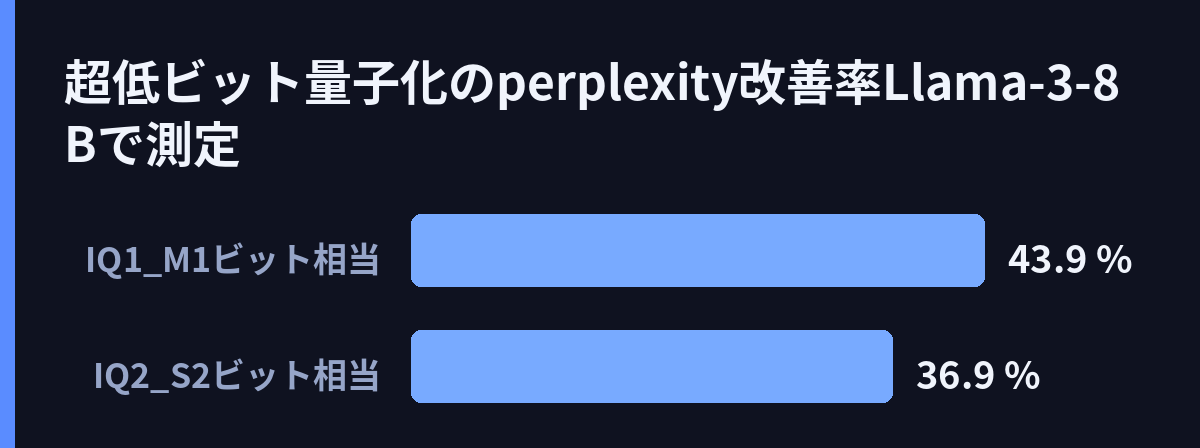
効果を示す数値はLlama-3-8B-Instructでのテスト値です。1ビット相当の量子化オプションIQ1_Mでは、perplexity(モデルの予測の迷いを示す数値で、低いほど精度が高い)が27.46から15.41へと43.9%改善しました[2]。2ビット相当のIQ2_Sでも36.9%の改善を、追加サイズわずか0.2GBで達成しています[2]。推論速度の差は5%未満に抑えられているとのことです[2]。GPUのVRAMに収めたい場面や、メモリが限られる環境、CPUやエッジデバイスでの利用が想定されています[2]。
しかし、万能の技術ではありません。この手法はモデルのサイズが0.1〜0.3GB増えること、そして「1〜2ビットの誤差を許容できる場面」向けと明記されています[2]。公式ベンチの注記にも課題が並びます。ライブラリのTransformersでのFP8推論はまだ最適化が途上で、SGLangでのGPTQ-INT4も改善が必要とされています[4]。また、Qwen3.8-27Bに絞ったベンチマーク資料も増えています。速度とVRAM、品質を測った比較サイト[5]、ローカル研究向けのハードウェアガイド[5]、Dual 3090構成の測定を公開するリポジトリ、ローカル推論のベンチマーク集、48GBのデュアルGPU構成で何が動くかを検証した記事[5]などです。ただし今回の検索結果からは、それぞれの具体的な数値までは確認できませんでした。
60tps報告のセットアップが判明したことで、「何を使ってどう動いたのか」が読み取れるようになりました。量子化の進歩と公式の速度データが揃えば、手持ちのハードウェアで何が動くかの見通しも立てやすくなります。古いカードの再活用から、AIをローカルで動かす裾野はまだ広がり続けているようです。
引用ソース
- Hacker News Hacker News: 2x Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps — https://github.com/Kmic-68/llama.cpp
2x Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps
- Web記事 記事全文: Mungert/Qwen3-32B-GGUF · Hugging Face — https://huggingface.co/Mungert/Qwen3-32B-GGUF
This model was generated using llama.cpp at commit 19e899c.
Our latest quantization method introduces precision-adaptive quantization for ultra-low-bit models (1-2 bit), with benchmark-proven improvements on Llama-3-8B. - HNコメント HNコメント: Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps — https://news.ycombinator.com/item?id=50146283
Interesting. What system were running the cards on?
- Web記事 記事全文: Speed Benchmark – Qwen — https://qwen.readthedocs.io/en/latest/getting_started/speed_benchmark.html
Speed Benchmark
We report the speed performance of bfloat16 models and quantized models (including FP8, GPTQ, AWQ) of the Qwen3 series.
Specifically, we report the inference speed (tokens/s) as well as memory footprint ( - Web記事 Web検索: Qwen3/docs/source/getting_started/speed_benchmark.md at main · QwenLM … — https://github.com/QwenLM/Qwen3/blob/main/docs/source/getting_started/speed_benchmark.md
Qwen3/docs/source/getting_started/speed_benchmark.md at main · QwenLM …
- Web記事 Web検索: Local LLM Benchmark on a 48 GB Dual-GPU Rig: What Actually Runs in 2026 — https://koishiai.com/en/articles/local-llm-benchmark-48gb-dual-gpu
Local LLM Benchmark on a 48 GB Dual-GPU Rig: What Actually Runs in 2026
- Web記事 Web検索: qwen/qwen3.8-27b Benchmarks: Speed, VRAM & Quality | llm-bench.io — https://llm-bench.io/models/qwen3-8-27b
qwen/qwen3.8-27b Benchmarks: Speed, VRAM & Quality | llm-bench.io
- Web記事 Web検索: Qwen3.8-27B for Local Research: Accuracy and Hardware Guide — https://intuitionlabs.ai/articles/qwen3-8-27b-local-research-assistant
Qwen3.8-27B for Local Research: Accuracy and Hardware Guide
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS