VRAM 8GBのノートPCで35Bモデルが動いた——先日お伝えしたllama.cppのMoEオフロード(重みをGPUの外へ置く技)に、その後の動きが出てきました。今度は「RAMに置く」から一歩進み、必要なエキスパートをディスクから直接流し込む方式が試され始めています[2]。実装はすでに複数あり、スマホを狙う試みも再び姿を見せました[1]。
MoE(混合エキスパート)は、トークンごとに多数の専門家ネットワークのうち一部だけを動かす仕組みです。ローカルでAIモデルを動かす魅力は、ここにあります。たとえばQwen3-Coderの30Bモデルは、同時に動くのは3Bだけです[2]。DeepSeekクラスの大型モデルも、同じ発想で動いています[2]。ところがllama.cppでは、動かないエキスパートも含め、全重みをどこかに置いておく必要があります。動かす前から全部を用意しなければならないのです。16GBや24GBのマシンでは、この「置き場所」が最大の壁になります[2]。
現時点で使えるのが、前半の層のエキスパート重みをVRAMではなくシステムRAMに置くオプション(–n-cpu-moe)です[2]。attention(注目すべき一部だけを見て計算を減らす仕組み)と、トークンごとに動く部分の計算はGPUに残ります。エキスパート重みの一部だけをRAMへ逃がすことで、モデル全体が読み込めない事態を避けます[2]。数を増やすほどVRAMは節約でき、代わりにトークンごとのCPU仕事が増えます。解説記事はこれを「ノブであって最適化ではない」と言い切ります。速度への代償はトークン/秒に直接現れるため、正しい値は「モデルがメモリ不足で落ちないぎりぎり」であり、それ以下は速度の無駄だというのです[2]。この方式で、30B級のMoEモデルが16GBのカードで実用になるとされます[2]。
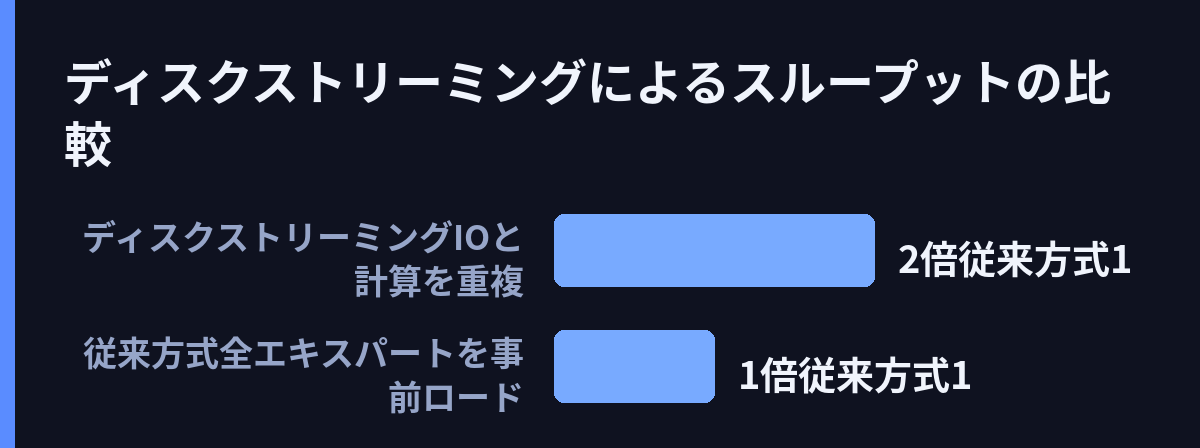
今回の新展開は、ディスクからのストリーミングです。あらかじめRAMに読み込まず、必要になったエキスパートだけをその都度ディスクから取ってきます[2]。すべてを事前読み込みする必要がなくなる、という発想です。カギはタイミングのずらしにあります。トークンがどのエキスパートに振られるかを決める「ルーター」の計算は、現在の層のattentionより先に終わります。この計算の隙間が、先読みのための窓になります。現在の層の計算が進んでいる間に、次の層で必要なエキスパートをディスクから取得できるのです。ディスクからの読み込み(I/O)と計算を重ねることで、すべてを事前に読み込む方式比でおよそ2倍のスループット向上を報告した実装もあります[2]。この方向では、すでに5つ以上の独立した実装が存在するといいます[2]。
実装も具体的に見え始めました。llama.cppベースの軽量フレームワーク「llama.moe」(実行名はzilong)は、動的なエキスパートオフロードを備えています。ビルドにはCUDA(NVIDIA GPU向けの開発環境)が必要で、使い方はllama-serverと同じ。コマンドを置き換えるだけで動くといいます[3]。スマホとラップトップで巨大MoEをストリーミングするレイヤー「BigMoeOnEdge」も、Hacker Newsに「Show HN」として投稿されました[1]。周辺では、GPUの助けを借りてMoEをCPU推論で回すガイド[4]や、少ないVRAMでより大きなモデルを動かすガイド[5]、大規模MoEモデルの推論性能を最適化する手順のまとめ[6]も公開されています。ノウハウが一気に広がっているようです。
しかし、道のりは平坦ではありません。RAMオフロードは速度とVRAMの余裕を直接交換する設定で、扱いが繊細です[2]。ディスクストリーミングも、本流に取り込まれた機能ではなく、機能要望と複数の試作が並ぶ段階です[2]。Hacker Newsの投稿も、現時点で1ポイント・コメント0件にとどまったままです[1]。話題の大きさに比べ、注目はまだ限定的なようです。乱立する実装のどれが実戦で使えるかは、これからの検証待ちと思われます。
MoEの「使う分だけ計算する」という性質は、重みの置き場所まで自由にしました。GPU・RAM・ディスク、そしてスマホのストレージまで、層ごとに配置を選べる段階に入ったようです。実装が整理され、比較の実測が揃えば、VRAMの壁はさらに下がるでしょう。エッジデバイスでの大モデル実行が、特殊な技から普通の選択肢へ変わっていくかもしれません。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: llama.cpp's MoE Expert Offload: –n-cpu-moe and Streaming, Explained — https://www.shawnmayzes.com/ai-engineering/llama-cpp-moe-expert-offload-explained/
llama.cpp’s MoE Expert Offload: –n-cpu-moe and Streaming, Explained
– 8 min read
If you’re running a mixture-of-experts model locally – Qwen3-Coder, DeepSeek-class models – the whole appeal is that only a fraction of th - Web記事 記事全文: GitHub – jklincn/llama.moe: Optimized inference of MoE models based on … — https://github.com/jklincn/llama.moe
A lightweight inference framework for Mixture-of-Experts (MoE) models, built on top of llama.cpp with dynamic expert offloading.
sudo apt update
sudo apt install build-essential cmake ccache libcurl4-openssl-dev ninja-bu - Web記事 Web検索: Performant local mixture-of-experts CPU inference with GPU acceleration … — https://huggingface.co/blog/Doctor-Shotgun/llamacpp-moe-offload-guide
Performant local mixture-of-experts CPU inference with GPU acceleration …
- Web記事 Web検索: Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide … — https://aliteq.com/llama-cpp-moe-offloading-run-bigger-models-less-vram
Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide …
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS