AIをローカルで動かすには、Python環境の整備が欠かせない——そう思い込んでいませんか。海外掲示板Hacker Newsに、「依存ライブラリゼロ、1つのJARファイルで動くローカル推論」という投稿が話題となりました[1]。JARとは、Javaのプログラムやライブラリを1ファイルにまとめた形式のことです。
中身を説明したのは、プロジェクト作者自身です[3]。Quixotic AIという取り組みです。AI推論に必要な機能セットを、JVM(Javaアプリを動かす土台)向けに作り込みました。スタック全体が2.6MBのfat JAR(依存ライブラリも詰め込んだ単一ファイル)に収まります。追加の依存は不要とされます[3]。CPU上ではllama.cpp(ローカル推論の定番エンジン)に匹敵する性能で、APIもシンプルに設計したといいます[3]。各コンポーネントは単体でも使えます。Gemma 4、Qwen 3.5+、LFM 2.5など、最新のオープンモデルへの対応も進めました[3]。
モデルの受け皿として注目されるのがModelJarsです[2]。フロントエンド資産をJARで配る既存の仕組み「WebJars」の発想を借りた、コミュニティ管理の規約です。JARにメタデータを同梱します。記録するのは、モデルの置き場所、チェックサム、ライセンス、対応バックエンドです。量子化(重みを圧縮してメモリを節約する仕組み)のバリエーションの違いも含まれます[2]。大きな重みは外部に置くのが基本です。小さなモデルはJARへ同梱でき、その場合はサイズとSHA-256の照合で検証されます[2]。
性能の主張を「記録」する仕組みも持ちます。JARには性能や適合性のメタデータも含まれます[2]。公開時のチェック項目は、検証済みのモデルファイル、固定したランタイム、一致するホストとワークロードです。相対性能の基準も満たす必要があります[2]。RAG(文書を検索して回答に使う仕組み)向けのモデルにも配慮があります。実際に試したコンテキスト長(一度に扱える文章量)を記録するのです。読み込み時はカタログ上の最大値ではなく、その実測値を使います[2]。性能の見通しを利用者側で確認しやすくする狙いのようです。モデルの同一性は、カタログの単一ファイルで管理します[2]。
別の試みもあります。JInferはJava 17以上で動く推論エンジンで、オフライン動作を売りにします[4]。モデル共有サービスHuggingFaceからモデルを取得し、キャッシュできます[4]。実行にはONNX Runtime(多様なモデルを動かせる実行エンジン)をバックエンドに使います。生成の揺らぎを調えるサンプリングのオプションや、トークンを順次出すストリーミングにも対応します。CLI(コマンドライン)とライブラリの両方で動き、モデルのダウンロードから実行、一覧、削除までコマンドで行えます[4]。実際、MacでGemma 4をQxotic Jinfer、llama.cpp、AppleのMLXで比較したブログ記事も出ています[5]。
しかし、注目度には温度差があります。この投稿は2ポイント、コメント1件にとどまりました[1]。気になるのは表現の揺れです。見出しはllama.cpp「より速い」と打ち、作者コメントはCPU上で「匹敵する」と述べています[1][3]。比較記事[5]はあるものの、その実測数値は今回の素材からは確認できませんでした。性能の裏付けは、当面は作者側の報告が中心になります。また、2.6MBなのはスタック部分のみで、モデルの重みは別途入手する形です[2]。「JAR 1つで完結」という印象と実態の差は、押さえておきたい点です。
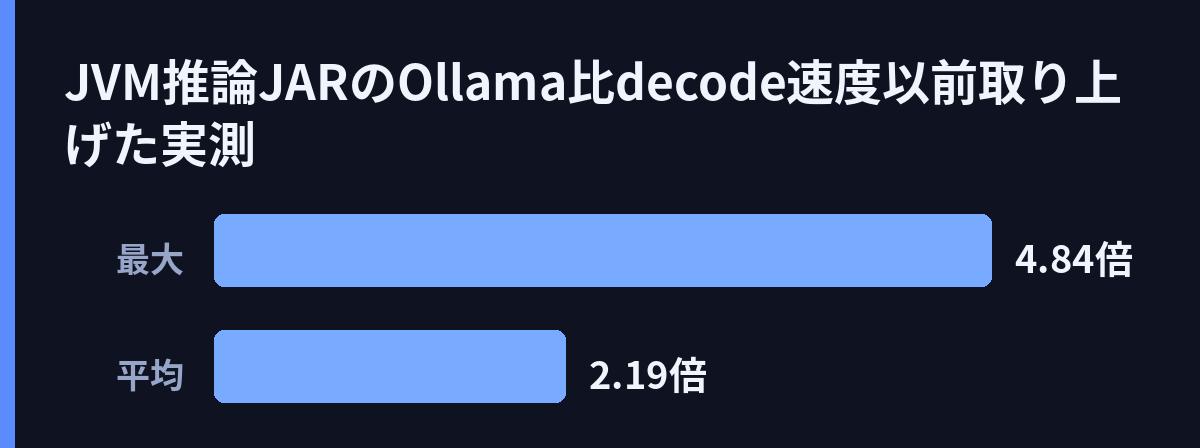
競合環境も厳しくなっています。GPUサーバー向けの推論エンジンvLLMとllama.cppを比べる記事が、2026年に入っても複数出ています[6][7]。ローカルLLMの選択肢は、50以上に整理される状況です[8]。ではJVM勢の実力はどうか。以前取り上げた2.6MB JARの実測では、定番ツールOllamaとの比較で速さが報告されていました。decode(トークンを1つずつ生成する段階)が平均2.19倍、モデルによっては最大4.84倍です。ただし相手はOllamaです。llama.cppやvLLMとの比較情報はまだ薄いようです。
それでも、この流れには意味があります。Java資産を持つ企業なら、推論を既存のJVM運用にそのまま乗せられるからです。依存ゼロの実行環境と、モデル配布の規約がそろえば、現場での導入障壁は下がるでしょう。今後の鍵は、第三者による実測が積み上がるかどうかです。2.6MBの挑戦が定着するか、注目したいところです。
引用ソース
- Hacker News Hacker News: Local inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://qxotic.ai/
Local inferencing in one JVM JAR, dependency free, faster than llama.cpp
- Web記事 記事全文: GitHub – ModelJars/modeljars: Community-maintained JVM marker JAR … — https://github.com/ModelJars/modeljars
ModelJars is a community-owned marker-JAR convention for local and remote model artifacts. It borrows the useful WebJars idea of using normal JVM dependency coordinates and classpath metadata. Large model weights remain
- HNコメント HNコメント: cal inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://news.ycombinator.com/item?id=50223693
Quixotic AI is a serious attempt to bring an end-to-end AI stack to the JVM. Performance is already competitive with llama.cpp (on CPUs), the APIs are crafted to be simple and easy to use. Every component in the stack ca
- Web記事 記事全文: CodyEdwin/JInfer: Java LLM Inference Engine – GitHub — https://github.com/CodyEdwin/JInfer
Java LLM Inference Engine – A high-performance, offline-capable inference engine for running Large Language Models in Java applications.
– Local LLM Inference – Run models locally without external API dependencies
– Hugg - Web記事 Web検索: Running Gemma 4 locally on Mac: Benchmarking Qxotic Jinfer, llama.cpp … — https://glaforge.dev/posts/2026/07/25/running-gemma-4-locally-on-mac-benchmarking-qxotic-jinfer-llama-cpp-mlx-and-connecting-java-25-with-langchain4j/
Running Gemma 4 locally on Mac: Benchmarking Qxotic Jinfer, llama.cpp …
- Web記事 Web検索: vLLM vs llama.cpp (2026): What Official Docs and Public Benchmarks … — https://markaicode.com/benchmarks/vllm-vs-llamacpp-performance/
vLLM vs llama.cpp (2026): What Official Docs and Public Benchmarks …
- Web記事 Web検索: vLLM vs Llama.cpp: Inference Speed, VRAM & Benchmark Comparison (2026) — https://ia4pymes.tech/en/blog/vllm-vs-llamacpp-llm-inference-engine-smes
vLLM vs Llama.cpp: Inference Speed, VRAM & Benchmark Comparison (2026)
- Web記事 Web検索: 50+ Open-Source Options for Running LLMs Locally – Vince Lam — https://vince-lam.github.io/posts/local-llm-options/
50+ Open-Source Options for Running LLMs Locally – Vince Lam
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS