llama.cppの切替高速化は、モデルの読み直しよりKV cacheの再利用へ移っています。2秒以内のスリープやキャッシュ再利用が話題ですが、–cache-ramの誤解やキャッシュ圧縮の速度低下が落とし穴です。構成とキャッシュ設計の重要性がわかります。
llama.cppの切替高速化は、モデルの読み直しよりKV cacheの再利用へ移っています。2秒以内のスリープやキャッシュ再利用が話題ですが、–cache-ramの誤解やキャッシュ圧縮の速度低下が落とし穴です。構成とキャッシュ設計の重要性がわかります。
ローカルAIのllama.cppで、モデル切替や再起動後に推論が遅くなる原因がKVキャッシュの再計算にあると話題です。スリープで2秒以内の切替、セッションの保存・復元が注目されています。キャッシュ再利用の仕組みと注意点、ベンチマークの使い方もわかります。
Qwen3.8-27Bの量子化で、8bit KVキャッシュはほぼ品質を落とさずメモリを半分にできるという実測が話題です。4bit重みはタスクによって持ちこたえ、1bitは崩れるという報告もあります。AI推論の速度とVRAMの落としどころを続報で整理します。
Xing4.0-29B-A4BのMoEモデルがGGUFで注目されています。総パラメータ29Bのうち4Bだけ動く設計と、中間量子化のサイズ・精度の差が要点です。ローカル推論で量子化を選ぶ視点を追います。
llama.cppチームのMac/Windows向けアプリが話題です。1MBでOpenAI互換APIや自動設定を提供し、Vulkan最適化やベンチマークも続いています。AIバブルの話題の中で、ローカル推論の実用性が見えてきます。
AIの推論エンジンは、ローカル実行の試行錯誤とH100ベンチマークが同時に進む状況です。TensorRT-LLMはvLLMより15〜25%速い一方、vLLMは400以上のモデル対応で運用が楽です。構成と数値から選び方の軸がわかります。
tandem.cppがQwen3.8-Flash-NextをRTX 4090と64GB RAMで97.3 tok/sで動作させ、llama.cpp比で3.3倍と報告されています。MoEのGPU/CPU分担が鍵で、Strataや量子化構成との差も見えます。
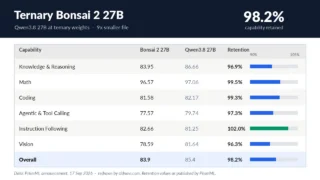
AIモデルのTernary Bonsai 2は27B級を5.9GBに圧縮し、ローカル推論で話題です。ik_llama.cppや専用ビルドでCUDA/CPUが動作し、8GBカードで65〜73 tok/sの報告もあります。制約や設定の落とし穴もわかります。
Quixotic AIが、依存なしの2.6MBのJARでローカルLLM推論を可能にしたと報告しました。CPUではllama.cppと競合する性能を掲げ、JVM単一構成の現実性を示します。一方、実測比較の不足やベンチ環境の整備が課題です。
JVM 向けに 2.6 MB の JAR だけでローカル推論を試す試みが Hacker News に投稿されました。作者は CPU で llama.cpp と競合する性能や Gemma 4 対応を主張しますが、具体的な比較数値は素材にありません。ローカル推論ベンチの文脈で、どこまで独立検証が必要かが見えます。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS