8GBのGPUで35Bモデルが動く、という話は以前にも出ました。今回は、その中心にあるllama.cppが、ローカルAIの基準としてはっきりしてきています。Hacker Newsでは、JVMの単一JARで推論できる試みや、スマホとノートPCで巨大MoEを流す拡張が話題になりました[1][4]。以前は「動くかどうか」が焦点でした。今は「どこに何を置くか」が焦点です。Flash級に軽く、速いAIの実現が、llama.cppの周辺で進んでいるようです。
中心にあるのは、MoEという仕組みです。MoEは、全部の神経回路を一度に使わず、入力に応じて一部の専門家だけ動かす構造です[2]。35Bのモデルでも、推論で実際に動くのは約3Bだけだとされます[2]。残りのエキスパートをシステムRAMに置き、GPUには常時使う層を載せます。llama.cppでは、GPUに全層を載せる指定と、エキスパートをシステムRAMに逃がす指定を組み合わせます[2]。記事の実測では、17.7GBのQwen3.6-35B-A3BをIQ4_XS量子化し、32Kコンテキストで試しました[2]。量子化は、重みを圧縮してメモリを節約する仕組みです。この置き分けにより、VRAMに収まらないファイルでも動かせる可能性があります[2]。デスクトップのRTX 4070 Ti Super 16GB GPUでは速い結果が出た一方、8GB GPUのノートPC(Lenovo Legion 5のRTX 3070 Mobile)でも、RAM分担なら現実的な速度に近づいたと報告されています[2]。
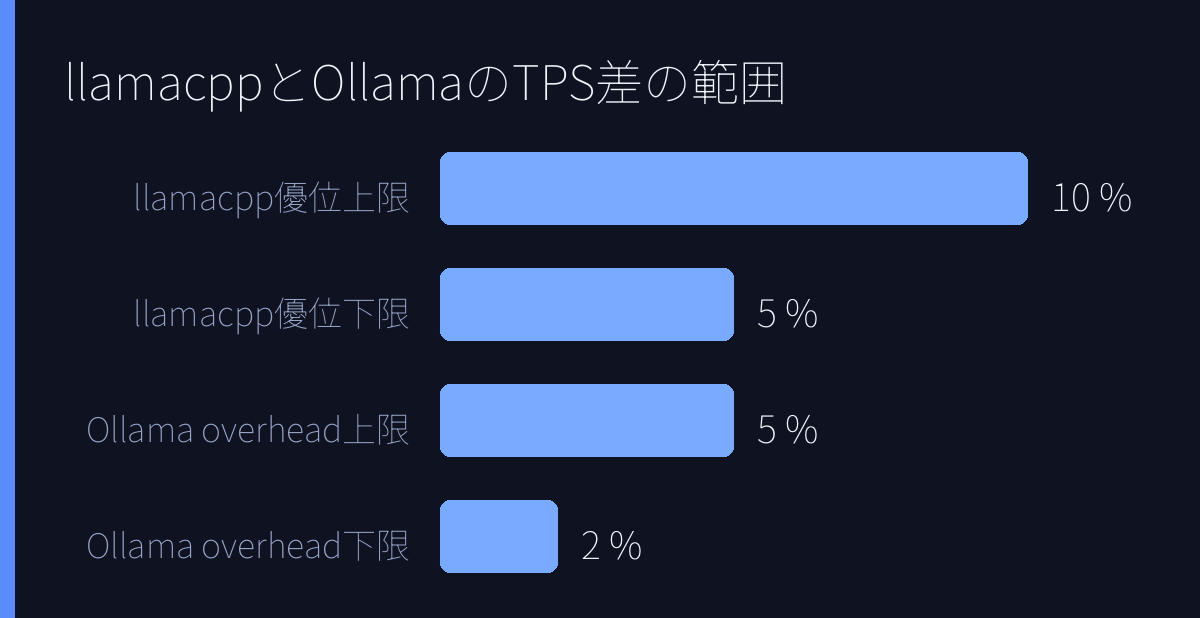
llama.cppの強みは、生性能です。C/C++の実装で、実行時の余分な処理やメモリコピーが少ないとされます[5]。TPSは、毎秒いくつのトークンを生成できるかを示す指標です。Ollamaと比べると、単一ユーザーのTPSで有利とされます。RTX 4090の比較では、同じ量子化モデルで5〜10%高いTPSが出たとあります[5]。Ollamaは管理サーバーやREST APIで使いやすく、HTTPと管理層の遅延を伴います[5]。その分2〜5%のオーバーヘッドを受け入れます[5]。自動モデルダウンロードや複数モデル提供、CLIによるモデル管理も備えます[5]。メモリオーバーヘッドも重要な差です[5]。つまり、開発の速さを取るならOllama、最大性能を取るならllama.cppという整理です[5]。差は同時実行で広がります。llama.cppのサーバーは連続バッチを使い、複数の要求をまとめてGPUで処理できます[5]。連続バッチは、複数の要求を1つのGPU処理にまとめる仕組みです。Ollamaは逐次か限定的なバッチで、混雑時に待ちが出やすいとされます[5]。
一方、JVM側にも動きがあります。Quixotic AIは、依存なしの2.6MBの単一JARでローカル推論を狙う試みです[1][3]。fat jarは、依存関係を1つにまとめた実行ファイルです[3]。作者は、CPU推論でllama.cppと競える性能とし、APIはシンプルで、各部品を単独でも使えると説明しています[3]。対応モデルには、Gemma 4やQwen 3.5+、LFM 2.5などが挙げられています[3]。Hacker Newsでは、JVMの投稿は2ポイント、MoEストリーミングの投稿は1ポイントと、まだ注目度は小さいです[1][4]。それでも、Java環境に載せられる軽さは魅力です。スマホやノートPC向けには、llama.cppの上にMoEストリーミングを載せる拡張も出ています[4]。巨大なMoEをディスクやメモリから流し込み、限られたVRAMで動かす方向です。
ただし、万能ではありません。MoEのRAM分担は、GPUのVRAMだけでなくシステムRAMの容量と速度に依存します[2]。llama.cppは性能を取れる反面、モデルファイルやビルドオプションの扱いを自分で決める必要があります[5]。Ollamaは設定が楽ですが、最大性能は出にくいという整理です[5]。2026年の検索結果には、MoE最適化ガイドやOllama、vLLM、llama.cppの比較、Gemma 4のKVキャッシュ修正やNPUベンチマークも並びます[6][7][8]。vLLMは、サーバー向けの推論エンジンです。KVキャッシュは、生成時の中間状態を保持する仕組みです。NPUは、AI処理向けの専用演算装置です。速度、品質、資源使用量のバランスを見る動きもあります。エンジン比較ガイドも出ています。ただし、今回の素材には同一条件の具体的な実測値は限られていました。
結局、llama.cppはローカルAIの基準点として、制御と性能の両方を示しています。MoEの置き場所を工夫すれば、小さなGPUでも選択肢が広がります。JVMの軽量実装や管理型サーバーとの比較が進み、用途ごとに最適なセットアップが見え始めています[1][3][5]。単一JARの推論、MoEのRAM分担、連続バッチ、NPU最適化。これらは別々の話に見えて、実は「どこで何を計算するか」という同じ問いに集まっています。ローカルAIは、モデルの大きさより、置き場所と実行系の設計で決まる場面が増えてきました。Hacker Newsの小さなスレッドは、その試走の記録です[1][4]。
引用ソース
- Hacker News Hacker News: Local inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://qxotic.ai/
Local inferencing in one JVM JAR, dependency free, faster than llama.cpp
- Web記事 記事全文: I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B … — https://www.xda-developers.com/i-stopped-thinking-my-8gb-gpu-was-too-small-after-learning-to-offload-moe-llm-layers-to-ram/
A lot of what you can do with your PC seems to be limited by the VRAM its GPU has. It decides what resolution your games run at, how large a video project you can edit without the timeline stuttering intermittently, and
- HNコメント HNコメント: cal inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://news.ycombinator.com/item?id=50223693
Quixotic AI is a serious attempt to bring an end-to-end AI stack to the JVM. Performance is already competitive with llama.cpp (on CPUs), the APIs are crafted to be simple and easy to use. Every component in the stack ca
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: llama.cpp vs Ollama: Local Inference Performance Guide — https://inferensys.com/differences/private-rag-vs-fully-local-ai-architectures/local-model-quantization-toolchains/llamacpp-vs-ollama-local-inference-performance
A data-driven comparison of raw throughput, memory overhead, and GPU offloading efficiency between llama.cpp’s native C++ runtime and Ollama’s managed server wrapper for production local inference.
llama.cpp vs Ollama: L - Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: Local Inference Benchmark (July 2026) — Ollama vs vLLM vs llama.cpp … — https://plugsky.com/local-inference-benchmark
Local Inference Benchmark (July 2026) — Ollama vs vLLM vs llama.cpp …
- Web記事 Web検索: Optimizing Gemma 4 Local Inference: llama.cpp KV Cache Fix and NPU … — https://explore.n1n.ai/blog/gemma-4-local-inference-llama-cpp-kv-cache-fix-npu-benchmarks-2026-04-05
Optimizing Gemma 4 Local Inference: llama.cpp KV Cache Fix and NPU …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS