長さだけでは足りません。context windowは、一度に扱えるテキストの範囲です。話題が変わりました。どこまで長く扱えるかから、溜まったトークン(文字や単語の単位)をどう掃除するかへ移っています。本当に効いているかをどう測るかも重要です。Hacker Newsでは、Rustで書かれたLLM(大規模言語モデル)の文脈ウィンドウ用ガベージコレクタが話題になりました。ガベージコレクタは、使われないデータを片付ける仕組みです [1]。Dr. Nels Lindahl氏も、長い会話で入力(プロンプト)と返答のトークンが積み上がる点を指摘しています。128kや200kの上限にぶつかりやすいと言います [4]。Xトレンドでは「Gemini4Carbon」が上がり、関連する話題も挙がっています [3]。
以前取り上げた100万トークン級のLing最新版では、560B全体からトークンごとに25Bだけを動かす設計でした。扱える長さは伸びました。それでも、長い資料や会話履歴をそのまま積み上げれば、コストと精度の問題は消えません。Lindahl氏は、トークンを間引く、捨てる、圧縮するといった処理が必要だと述べています [4]。AIコーディングでは、8192トークンの予算で147ファイルから4ファイルだけを選び、約3200トークンに抑える実例もありました。
こうした流れで重要になるのが評価です。GitHubのcontext-benchは、ユーザーとLLMの間に置く仕組みを測ります。文脈圧縮、RAG、メモリ、リランキングなどが対象です [2]。RAGは、検索して答えに使う仕組みです。システムが助けるのか、害になるのか、トークンに見合うのかを問います。自分で評価装置を作らなくて済むのが利点です。42以上の標準データセットを使い、LoCoMoというデータセットでは400〜700ターンの会話に対する質問に答えられるかを調べます。時間的な推論、複数ステップの検索、わざと間違えさせる罠も含まれます。
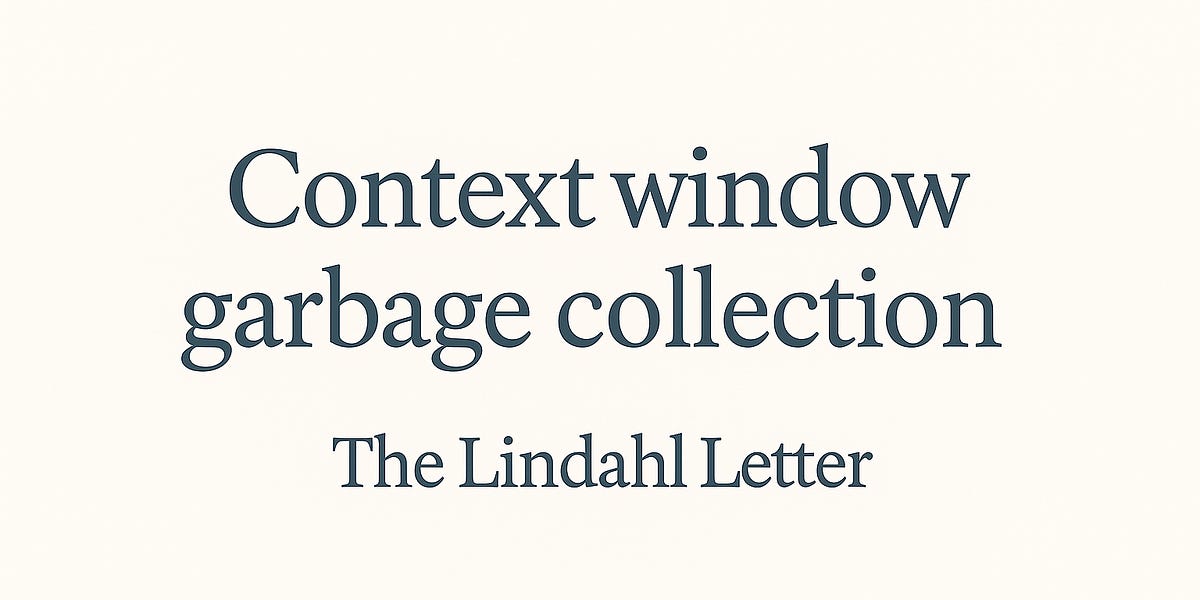
数値は厳しいです。LoCoMoの元論文で最良のベースラインだったGPT-3.5-turbo-16Kは、F1が37.8%でした。F1は、正解とどれだけ部分一致しているかを測る指標です。人間の上限は87.9%です。フルベンチマークでは10会話、1,986問を測ります。採点は2種類です。トークンレベルのF1と、LLM judgeです。LLM judgeは、別のモデルが答えの良し悪しを判定します。judgeにはClaude Sonnetを使っています。フル実行は3システムで約7時間かかる想定です [2]。
注目したいのは、評価の軸がずれることです。Mem0は会話から抽出する方式です。長い会話の詳細をかなり失うようです。419ターンの会話で抽出に約90分かかりました。公開値ではLLM judgeで66.9%です。一方、ローカルOSS(自分の環境で動くオープンソース)でClaude Sonnet judgeにすると27.6%でした [2]。MemMachineもjudgeでは91.7%でも、F1は約25%です。judgeは甘く、指標が違う数字は直接比較できません [2]。
評価の中で目立つのがRLMシステムです。sentence-transformers、LanceDB、DuckDBといったオープンソース部品だけを使っています。元論文の最良ベースラインにraw F1(素のF1)で並ぶと報告されています [2]。巨大な専用基盤がなくても、文脈の整理と検索の作り方で差が出る可能性があります。RULERは、公称の文脈長ではなく、実際にどこまで使えるかを測るための枠組みです [5]。kickllmの試みは、モデルが最大文脈でどれだけ性能を保つかを見ます [5]。
ただし、掃除そのものの実測はまだ薄いようです。Rust製ガベージコレクタは話題ですが、素材には具体的な削減率や速度の実測値は見つかりませんでした [1]。Hacker Newsの投稿は1ポイント、コメント0件で、まだ初期の話題です [1]。Lindahl氏も、持ち運びやすい知識の分割など、解決策は複数あり得ると述べています [4]。Gemini 4 Carbon関連では、benchmark reality、token economics、developer tradeoffs、Intelligence/Performance/Price、Benchmarks/Pricing/Speedが論点として挙がっています [5][5]。しかし素材には具体的なTPS(1秒あたりの生成速度)や価格の数値は見つかりませんでした。
結ぶと、context windowの主戦場は「長さ」から「片付けと検証」へ移っています。トークンを増やすより、何を残し、何を削るかを決める仕組みが要ります。評価も、F1とjudgeを混ぜずに比べる必要があります。Rust製GCやcontext-bench、Gemini 4 Carbon関連の話題は、その準備が進んでいることを示しています。次の段階では、掃除の仕組みと評価指標がセットで語られるようになりそうです。
引用ソース
- Hacker News Hacker News: A garbage collector for LLM context windows, written in Rust — https://news.ycombinator.com/item?id=50274683
A garbage collector for LLM context windows, written in Rust
- Web記事 記事全文: GitHub – npow/context-bench: Benchmark any system that transforms LLM … — https://github.com/npow/context-bench
Measure whether your LLM context system actually works — in one command.
You built something that sits between a user and an LLM: a context compressor, a RAG pipeline, a memory system, a reranker. Does it help? Does it h - X Xトレンド: Gemini4Carbon — https://trends24.in/japan/
Gemini4Carbon
- Web記事 記事全文: Context window garbage collection – by Dr. Nels Lindahl — https://www.nelsx.com/p/context-window-garbage-collection
Thank you for tuning in to week 204 of the Lindahl Letter publication. A new edition arrives every Friday. This week the topic under consideration for the Lindahl Letter is, “Context window garbage collection.”
Here we a - Web記事 Web検索: Gemini 4 Carbon: Benchmark Reality, Token Economics, and Developer … — https://dev.to/veduis/gemini-4-carbon-benchmark-reality-token-economics-and-developer-tradeoffs-50l9
Gemini 4 Carbon: Benchmark Reality, Token Economics, and Developer …
- Web記事 Web検索: LLM Context Window Benchmark — How Models Perform at Maximum Context — https://kickllm.com/research/llm-context-window-benchmark.html
LLM Context Window Benchmark — How Models Perform at Maximum Context
- Web記事 Web検索: Gemini 4 Carbon (High) Intelligence, Performance & Price Analysis — https://artificialanalysis.ai/models/gemini-4-carbon
Gemini 4 Carbon (High) Intelligence, Performance & Price Analysis
- Web記事 Web検索: RULER: What’s the Real Context Size of Your Long … – GitHub — https://github.com/NVIDIA/RULER
RULER: What’s the Real Context Size of Your Long … – GitHub
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS