Gemini Agent は、ローコードからコードファーストまで入口が増え、Flash 系モデルと評価 GA が運用に繋がりました。1 回のインタラクションで 10 万〜300 万トークンという重さと、サンドボックスの安全設定が現実です。最新資料から運用の勘所を追跡します。
Gemini Agent は、ローコードからコードファーストまで入口が増え、Flash 系モデルと評価 GA が運用に繋がりました。1 回のインタラクションで 10 万〜300 万トークンという重さと、サンドボックスの安全設定が現実です。最新資料から運用の勘所を追跡します。
GoogleがAIモデルGemini 4 Carbonを公開しました。独立評価でスコア59、価格は入力100万トークン2ドル、出力10ドルです。一般公開は未定で、限定提供と外部検証が今後の鍵になります。
ローカルAIの話題が、モデル提案から自作RAM、端末内LLMまで広がっています。Gemma 5へのループ型提案や4Bモデルの実行、DDR5改造、訓練計算量15%削減などが素材にありました。何が今試されているかが見えます。
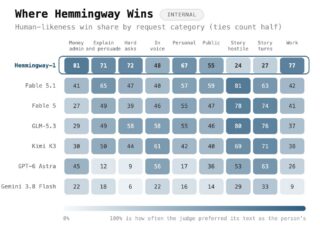
Hemmingway-1.5はQwen 27Bの文章特化モデルで、AI検知器を90%通過するとされています。人間は86%、前世代は7%で、書き味と検知回避が焦点です。ローカル実行や独自ベンチの注意点もわかります。
GitHub Copilotは、コード補完からエージェント中心の開発基盤へ刷新されました。Fusion MaxはOpus 5.5 Maxと2点以内の差で、コスト半分、時間40%短縮とされています。本記事では、その中身と制約を整理します。
OpenAIがGoogleのTPU購入を検討していると報じられました。Nvidia依存を減らす動きですが、金額や数量は未確認です。推論コストとaiチップ市場への影響、TPU調達とNvidia市場への波及を整理します。
Claude Opus 5.5がProgramBenchで18.5%を解きました。AnthropicのベンチではTerminal-Bench 4.0で66.4%を記録し、推論やエージェント性能も伸びています。aiニュースとして、速度・価格・比較の要点をまとめます。
Gemini Sparkの直接情報は乏しいが、Google AIの評価基盤が鍵です。適応型ルーブリックや本番ログ、計算指標でエージェントを測る入口が見えます。24/7運用では、hacker的な検証と指標設計が実務の分かれ目になります。素材から読み解きます。
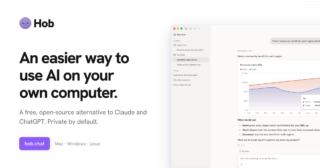
HobがGPT-OSSを載せたローカルAIとしてHacker Newsで話題です。172ポイントを集め、プライバシーとオフラインが軸です。ベンチマークの信頼が揺らぐ中、自分の環境で試す価値が問われています。

AIコーディングエージェントの評価が、小さな修正から丸ごと実装へ移っています。ProjDevBenchでは6エージェントの全体受容率は27.38%でした。評価の広がり、失敗の可視化、人の不在という課題がわかります。
2026.11.20
続・Gufo、拡張とRDMAでローカルAIを育てる
2026.11.19
ローカルLLM、快適さはモデルより帯域と量子化
2026.11.19
続・Meta Muse、無料AIエージェントとハッカー的な試行
RECENT COMMENTS