大きなモデルを動かすとき、壁になりやすいのはGPUメモリです。今回話題となったのは、vLLMがその壁をどう壊そうとしているかです。Redditでは、vLLMの開発版nightlyにPLE disk offloadのサポートが入ったと報告されました[1]。PLE disk offloadは、モデルの重みなどをディスクに逃がしてメモリ圧迫を和らげる仕組みと思われます。AGI Huntでも同じ話題が取り上げられていました[7]。
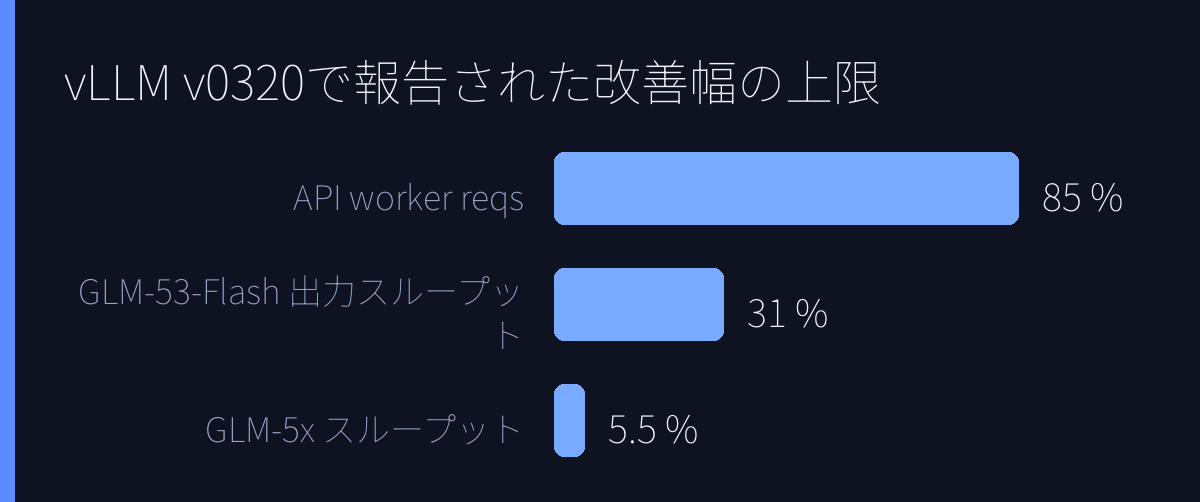
一方、正式リリースのv0.32.0では、KVキャッシュの低精度化が目立ちます。KVキャッシュは、推論で生成したトークンの中間状態をメモリに置いて、次の生成を速くする仕組みです。GitHubのリリースノートでは、GLM-5.xがSM100(NVIDIA GPUの世代を示す記号)でFP8(8bit浮動小数点)KVキャッシュを既定にし、ランクごとのKVメモリを半分にできたと書かれています[2]。その代わり、TTFT(最初のトークンが出るまでの待ち時間)が7〜11%増える代わりに、スループット(処理量)は2.3〜5.5%向上したとされています。
さらに、fp8_ds_mlaという設定をSM90(同じくGPU世代の記号)で使うと、GLM-5.3-Flash(flash系モデル)の出力スループットが最大31%上がったと報告されています[2]。AMD GPU向けのROCmでは、4bitのultraquant_4bit KVキャッシュがFP8の約2倍の密度になるとされています[2]。低精度の型名が並ぶと難しく見えますが、要点は「KVキャッシュを小さくして、同じGPUでより多くのトークンを扱えるようにする」ことです。
速度面では、API workerを増やす工夫も入っています。API worker(APIを処理するプロセス)の数を増やす設定にすると、接続を最も負荷の低いworkerに割り振り、43〜85%のreq/s(1秒あたりのリクエスト処理数)向上が報告されています[2]。起動を速くする仕組みも増えました。FlashInfer(推論用の高速化ライブラリ)のプリコンパイル済みカーネルをインストールする仕組みや、自動調整の記録を再起動後も温存する設定が追加されています[2]。
NVIDIAのドキュメントでは、vLLMがPagedAttentionとcontinuous batchingで高スループットとメモリ効率を狙うエンジンだと説明されています[3]。PagedAttentionはKVキャッシュをページ単位で管理し、continuous batchingは複数のリクエストをうまく混ぜてGPUを遊ばせない仕組みです。コンテナは毎月出ていて、推論環境の整備に使いやすい状態です[3]。
ただ、話題のすべてが完成しているわけではありません。GitHubには、Qwen3.8-Flashで補助GPU offloadingを支持するIssueがあります[4]。補助GPU offloadingは、主GPUだけでなく補助GPUへ処理を逃がす仕組みです。実装の成否や速度は、素材には具体的な数値が見つかりませんでした。ベンチマークの情報も断片的です。GitHubにはvllm_benchmarkというリポジトリがあり、高スループットとメモリ効率を測るためのものとして紹介されています[5]。DeepWikiにも性能比較のページがあります[6]。しかし、今回の素材にはGPU枚数、VRAM(GPUメモリ)、量子化(重みを圧縮してメモリを節約する仕組み)、RAM/PCIe分担(メモリと転送路の使い方)、実測TPS(1秒あたりのトークン数)や消費電力まで揃った構成はありませんでした。
ここからわかるのは、vLLMの話題が「新しいモデルを動かせるか」から「メモリと精度をどう設計するか」へ移っていることです。FP8や4bitのKVキャッシュ、PLE disk offload、補助GPU offloadは、いずれも推論セッションの設計に関わる工夫です。aiを安定して動かすための実務的な設定で、hacker向けの最適化という面もあります。AI運用のカルチャーにもなっています。結論としては、v0.32.0の注目点は、低精度KVキャッシュによるメモリ節約と、最大31%や43〜85%といった具体的な改善幅です。自分の環境で使うなら、まず素材にある数値を信じず、自分のGPUとモデルで試したほうがよさそうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: vLLM now has PLE disk offload support on nightly — https://www.reddit.com/r/LocalLLaMA/comments/1xjpbcg/vllm_now_has_ple_disk_offload_support_on_nightly/
vLLM now has PLE disk offload support on nightly
- Web記事 記事全文: Releases · vllm-project/vllm · GitHub — https://github.com/vllm-project/vllm/releases
Releases: vllm-project/vllm
Release list
v0.32.0
v0.32.0
Highlights
This release features 814 commits from 363 contributors (121 new)!
– Structured decisions and generic parsers: the new POST /v1/systemone endpoint answe - Web記事 記事全文: vLLM Release Notes – NVIDIA Docs — https://docs.nvidia.com/deeplearning/frameworks/vllm-release-notes/index.html
These release notes describe the key features, software enhancements, improvements, and known issues for this release of vLLM. vLLM is a high-performance serving engine for Large Language Models (LLMs) that provides stat
- Web記事 Web検索: [Feature]: Support auxiliary-GPU offloading for Qwen3.8-Flash … – GitHub — https://github.com/vllm-project/vllm/issues/53908
[Feature]: Support auxiliary-GPU offloading for Qwen3.8-Flash … – GitHub
- Web記事 Web検索: GitHub – laze44/vllm_benchmark: A high-throughput and memory-efficient … — https://github.com/laze44/vllm_benchmark
GitHub – laze44/vllm_benchmark: A high-throughput and memory-efficient …
- Web記事 Web検索: Performance Benchmarks & Hardware Comparisons | vllm-project/vllm … — https://deepwiki.com/vllm-project/vllm-project.github.io/11-performance-benchmarks-and-hardware-comparisons
Performance Benchmarks & Hardware Comparisons | vllm-project/vllm …
- Web記事 Web検索: vLLM nightly adds PLE disk offload, with… · AGI Hunt — https://agihunt.info/en/p/1a18e59fd1932913918f1da7f17
vLLM nightly adds PLE disk offload, with… · AGI Hunt
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS