📌 エグゼクティブサマリー
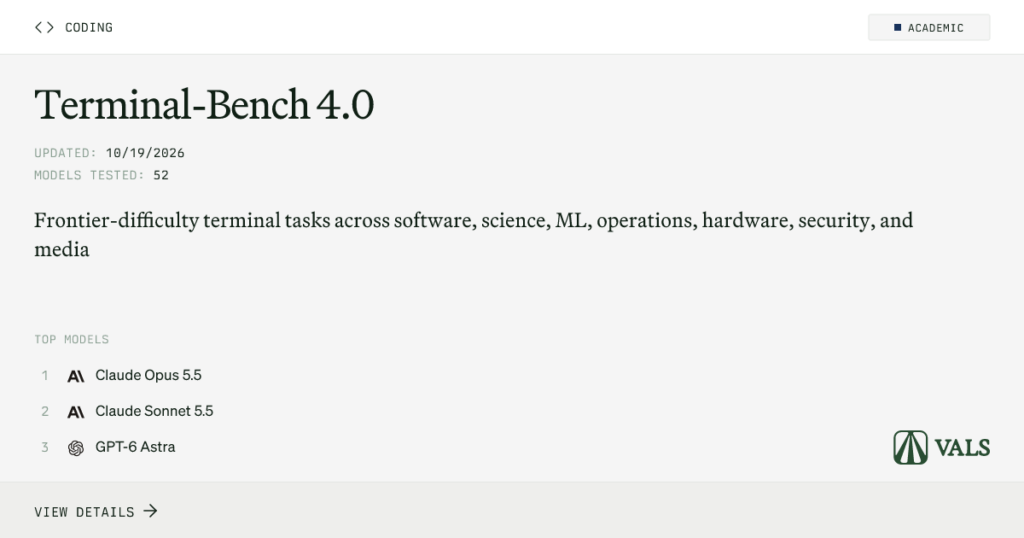
Terminal-Bench 4.0は66タスクで、Claude Opus 5.5が64.85%と首位です。RedditではKimi K3の成績差が問われ、評価の狙いと読み方が注目されています。本文ではタスク設計とリーダーボードの注意点を整理します。
aiエージェントの実力は、短いコード片では測れません。エージェントは、指示を受けて作業を進めるAIです。Terminal-Bench 4.0は、サンドボックス化したターミナルで長い仕事をこなす力を問うベンチマークです。Redditでは、Kimi K3がFrontier Code v1.1では良いのにTerminal Bench v4では悪い、という疑問が出ました。[1] flashのような速いデモではなく、数時間かかる作業を求めます。評価は、成果物で決まります。
まず、Terminal-Bench 4.0の作りが重要です。66タスクはコミュニティ提供で、メンテナーが審査しました。[3] 開発はTerminal-BenchコミュニティとHarborチームです。[3] タスクセットは2.1と重複しません。各タスクは動くサービス、証明、CADモデル、学習済みカーネル、フォレンジック報告など、成果物を求めます。専門家の中央値は4時間、短いもので1時間未満、長いものは60時間です。[3] Operationsの例として、workerを速くするタスクも紹介されています。[3] タスクはHarbor Hubで確認できます。[3]
分野も広くなりました。Softwareが18、Scienceが14、MLが11です。[3] Operationsが9、Hardwareが5、Securityが5、Mediaが4です。[3] Securityには暗号、アプリセキュリティ、フォレンジックが入ります。hacker的な仕事も、成果物ベースで問われる形です。これは、単なるコード補完のカルチャーとは少し違います。科学や医療、金融、設計まで含むため、得意分野の差が出やすいです。Mediaには音楽理論、音声文字起こし、レイアウト設計も入ります。[3]
リーダーボードでは、Claude Opus 5.5が64.85%で首位です。[2] Claude Sonnet 5.5は61.82%、GPT-6 Astraは58.18%です。[2] この表は2026年10月19日時点の公開スナップショットで、35モデルが並んでいます。[2] Agentic基準の8%として扱われます。[2] エージェント評価の重み付けの一部です。[2] ただし、モデル単体ではなく、モデルとエージェントの組み合わせを比較しています。[2] Claude CodeやCodex、Cursorなどが想定されています。[3] max reasoningなどの設定も並びます。[2] 推論は、AIが考えて答えを出す過程です。推論設定やエージェントの作りが、結果を大きく左右したようです。首位でも6割台なので、まだ難易度は高そうです。
評価の厳しさも変わりました。66タスクは、プロのコンピュータ作業を想定しています。[2] 4.0では、19タスクを修正し、8タスクを削除しました。[2] 削除対象は、飽和した、拒否されやすい、公開で解かれた、品質やプラットフォームの問題が残るタスクです。[2] 各タスクは5回試行し、エージェントのタイムアウトは8時間です。[2] このため、一度の成功より、安定して成果物を出す力が問われます。タイムアウトが長いため、短期のコード生成とは別物になりそうです。BenchLMは、この表を参照用に表示し、重み付けには直接使いません。[2] 正規化した結果は、外部のエージェント合意ゲートを通じて寄与する可能性がある、とされています。[2]
しかし、スコアをそのまま比べるのは危ういです。Artificial Analysisの表は、エージェントのハーネスと設定をAAが管理するため、別扱いされています。[2] ハーネスは、エージェントを動かす仕組みです。まだ独立した実行証拠としては認められていません。[2] Vals AIも独自のハーネスで、ドメイン別の内訳を出します。[3] Valsの表は、公式行を上書きしない別枠で保持されています。[2] 検索結果にも、BenchmarkList[4]、Artificial Analysis[5]、BenchLM、Snorkel AI[6]、Vals AI、BenchLMの総合ページ[6]が並びます。このため、順位表は複数存在します。同じ4.0でも、誰がどう動かしたかで数字が変わるようです。各行は、公開元が載せたハーネスと設定をそのまま保持しています。[2] 同じモデルでも、エージェントの実装で結果が変わりそうです。
Redditの疑問に戻ります。Kimi K3がFrontier Code v1.1で良く、Terminal Bench v4で悪いという報告は、ベンチの狙いの差を際立たせます。[1] Frontier Code v1.1はAgentic Software Engineeringを測るとされます。[1] Terminal Bench v4は、より広い分野の長い作業を、最終成果物で厳しく採点します。[3] Kimi K3の具体的な数値は、素材にはありませんでした。こうした差は、以前からあった問題と思われます。得意な作業と苦手な作業が分かれる可能性は十分あります。Kimi K3の弱点がどこかは、素材からは特定できません。
Terminal-Bench 4.0は、AIエージェントにflash的な速さではなく、長丁場の責任を求めます。64.85%という首位でも、まだ3割以上が残っています。[2] バージョンの更新でタスクも資源も変わるため、昔との単純比較は注意が必要です。[2] これからの評価は、モデル名より、エージェントのセットと推論設定まで含めて読む必要がありそうです。hacker的な仕事や科学計算まで含む以上、リーダーボードは一つの目安にすぎません。AIの実用化が進むほど、こうした長い評価の重要性は増していくと思われます。評価の読み合わせが、重要になりそうです。
引用ソース
- [1] Reddit Reddit r/LocalLLaMA: Terminal Bench v4 vs Frontier Code v1.1? — https://www.reddit.com/r/LocalLLaMA/comments/1xahu9x/terminal_bench_v4_vs_frontier_code_v11/
Terminal Bench v4 vs Frontier Code v1.1?
- [2] Web記事 記事全文: Terminal-Bench 4.0 Leaderboard & Scores — October 2026 — https://benchlm.ai/benchmarks/terminal-bench-4
Tasks completed on Terminal-Bench 4.0 — October 19, 2026 snapshot
We mirror the published tasks completed view for Terminal-Bench 4.0. Claude Opus 5.5 leads the public snapshot at 64.85%, followed by Claude Sonnet 5.5 (6 - [3] Web記事 記事全文: Terminal-Bench 4.0 Leaderboard and Methodology | Vals AI — https://www.vals.ai/benchmarks/terminal-bench-4
Background
Terminal-Bench is an open-source benchmark that measures how well an agent can complete long, realistic pieces of work in a sandboxed terminal. Version 4.0 is a fresh set of 66 community-contributed, maintaine - [4] Web記事 Web検索: Terminal-Bench 4.0 Benchmark Scores & AI Model Leaderboard | BenchmarkList — https://benchmarklist.com/benchmarks/terminal_bench_4/
Terminal-Bench 4.0 Benchmark Scores & AI Model Leaderboard | BenchmarkList
- [5] Web記事 Web検索: Terminal-Bench 4.0 Benchmark Leaderboard – Artificial Analysis — https://artificialanalysis.ai/evaluations/terminalbench-4-0
Terminal-Bench 4.0 Benchmark Leaderboard – Artificial Analysis
- [6] Web記事 Web検索: Terminal-Bench 4.0 Leaderboard: Agent Results | Snorkel AI — https://snorkel.ai/leaderboard/terminal-bench/
Terminal-Bench 4.0 Leaderboard: Agent Results | Snorkel AI
- [7] Web記事 Web検索: LLM Leaderboard & AI Model Benchmarks — October 2026 — https://benchlm.ai/
LLM Leaderboard & AI Model Benchmarks — October 2026
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS