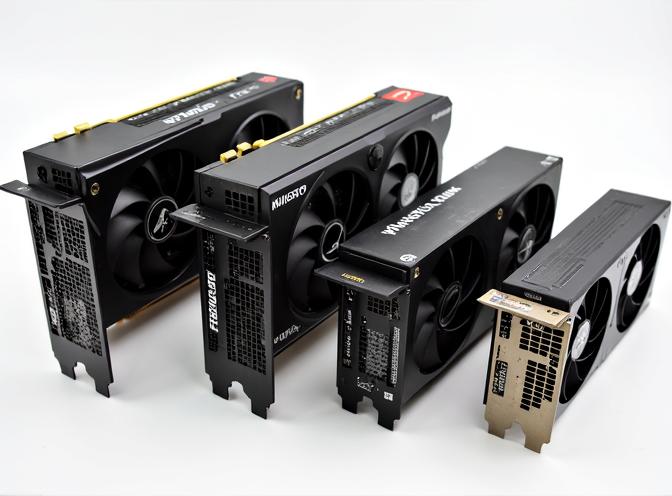
「速い」だけでは足りません。ローカル推論でNVIDIAが話題になるのは、RTX 50系が32Bモデルで最大213 tokens/secという数字を出せるからです [3]。その半面、70B超のモデルではVRAM(GPUに搭載される専用メモリ)不足が壁になります [3]。論点は計算性能の数字ではなく、メモリとソフトウェアの側に移っています。
Redditには、NVIDIAやAMD、Appleの製品が高価に感じられ、次はHuaweiやXiaomiなど中国ハードウェアが候補になる、という投稿がありました [1]。投稿者はbosgame m5 strixhaloを好調に使っています。検索結果にも、中国製AIチップがNVIDIAを置き換える競争 [4] や、CUDA(NVIDIA製GPU向けソフト基盤)なしのGPU [6]、CUDA代替 [5]、tokens/secベンチ [6] といった話題が並びます。
2026年時点で、AIハードウェアの状況は大きく変わっています。NVIDIA、AMD、Intelが、ローカルLLMとAI推論を動かせるGPUを求める開発者を取り合っています [2]。比較対象は、NVIDIA Blackwell(RTX 50系)、AMD Radeon AI Pro R9700、Intel Arc Pro B70です [2]。記事は、メーカーが強調するAI TOPSやテンソル性能より、VRAM容量、メモリ帯域、ソフトウェアエコシステムの成熟度を見るべきだと指摘します [2]。
VRAMは最初の制限になります。モデルがGPUに収まらないと、重みをシステムRAMに逃がすことになり、推論性能が大きく落ちます [2]。16GBから32GBへの増設は、生の計算性能を上げるより実用的な利点が大きいとされています [2]。32GBのGPUにモデル全体を載せる方が、速い16GBのGPUからシステムRAMへ逃がす構成より、実用上は上回ることが多いとされます [2]。選ぶ基準は、モデルサイズ、ソフトウェアスタック、予算の3点に整理できます [2]。
なぜメモリ帯域が効くのでしょうか。ローカルLLMの推論は、プロンプトを読むprefillと、出力を1語ずつ生成するdecodeに分かれます [3]。prefillは並列化しやすく、計算量に依存します。GPUならTFLOPS、NPUならTOPSという計算性能の指標が効きます [3]。NPUはAI処理に特化したチップです。decodeは、モデルの全パラメータ状態をメモリから計算コアへ運ぶため、メモリ帯域に縛られます [3]。帯域が低いと、計算能力が高くても待たされます [3]。この2段階を分けて考えないと、TOPSやTFLOPSの数字に振り回されます [3]。この違いは、体感速度に直結します [3]。
だからRTX 50系は、32Bまでのモデルで最大213 tokens/secと速い半面、70B以上ではVRAM不足が壁になります [3]。そこではApple M4 MaxやAMD Strix Haloが強みを発揮します [3]。両者はCPUとGPUが同じメモリを共有する統合メモリを持ちます。大きなモデルでもOOM(メモリ不足)クラッシュなしで動くと評価されています [3]。NPUは10W未満の背景タスクやエッジCopilot向けで、大規模生成推論の主役ではありません [3]。速いGPUと大きなメモリは、同じ役割を果たさないのです [2][3]。
実測で確かめる読者には、派手な性能宣伝より、実測のtokens/secとOOMの境界が重要です [3][6]。NVIDIAの速さは「どのモデルを、どのVRAMで、どのソフトウェアで動かすか」に強く依存します [2][3]。CUDAの話題は、モデルを動かせるかどうかの入口に関わります [5][6]。CUDAが必須か、中国製GPUがCUDAなしでローカル実行できるかは、タイトルからは読み取れません [5][6]。代替スタックの対応モデル数、速度、安定性、導入コストの数値も抜粋にはありません。
中国製チップの話題 [4] の背景には、価格と調達の事情があると見られます。ただし具体的な製品名、性能、価格、供給状況は素材にありません。R9700やArc Pro B70の実測TPS、VRAM帯域、消費電力の数値も見つかりませんでした [2]。それでも、論点は「NVIDIAが最強か」より「VRAMとメモリ帯域とCUDA代替が、NVIDIAの牙城をどこまで崩すか」です [2][3][5]。分岐は明確です。32Bまでの速さを重視するならRTX 50系、70B超を安定して載せたいならApple M4 MaxやAMD Strix Haloが有利です [3]。価格と調達先を気にするなら、1〜2年後の中国ハードウェアが視野に入ります [1]。読者は、自分のモデルサイズと予算を先に決める必要があります。ローカルAIの選定は、推論速度をハードウェアの世代ではなく、モデルサイズとメモリ構成で決める段階に入っています [2][3][6]。
引用ソース
- Reddit Reddit r/LocalLLaMA: chinese hardware — https://www.reddit.com/r/LocalLLaMA/comments/1xapon0/chinese_hardware/
chinese hardware
- Web記事 記事全文: GPUs for AI in 2026: NVIDIA, AMD, Intel Compared — https://www.glukhov.org/hardware/ai/gpu-comparison-ai-workloads-2026-nvidia-amd-intel/
The AI hardware landscape has shifted significantly in 2026, with NVIDIA, AMD, and Intel all competing for developers who need GPUs capable of running local large language models and AI inference workloads.
Choosing the - Web記事 記事全文: NPU vs GPU Local LLM Benchmarking (2026) – theaitechpulse.com — https://www.theaitechpulse.com/npu-vs-gpu-local-llm-benchmarking-2026
The Bottom Line: Generative LLM inference speed is strictly bound by memory bandwidth, not raw compute TOPS. Discrete GPUs (Nvidia RTX 50-series) deliver unmatched raw speed (up to 213 tokens/sec) for models up to 32B. U
- Web記事 Web検索: Chinese AI Chips: The Race to Replace Nvidia – Kurums | Business … — https://kurums.com/china-ai-chips-nvidia-alternatives/
Chinese AI Chips: The Race to Replace Nvidia – Kurums | Business …
- Web記事 Web検索: Do You Really Need CUDA For Local LLMs? – Here Are The Alternatives — https://techtactician.com/cuda-vs-alternatives-for-local-llms/
Do You Really Need CUDA For Local LLMs? – Here Are The Alternatives
- Web記事 Web検索: China Built a GPU Without CUDA. Can It Run AI Models Locally? — https://medium.com/data-science-collective/china-built-a-gpu-without-cuda-can-it-run-ai-models-locally-38ea9f49cdd2
China Built a GPU Without CUDA. Can It Run AI Models Locally?
- Web記事 Web検索: Local LLM Tokens-per-Second Benchmarks 2026 – Presenc AI — https://presenc.ai/research/local-llm-tokens-per-second-benchmarks-2026
Local LLM Tokens-per-Second Benchmarks 2026 – Presenc AI
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。



RECENT COMMENTS