BlackwellがMLPerf Training v5.1で全項目最速となり、B200のmicrobenchmarkではメモリ遅延が58%減りました。AIの推論セッションでは、データのやり取りと次バージョンのFP4の精度が焦点になります。
BlackwellがMLPerf Training v5.1で全項目最速となり、B200のmicrobenchmarkではメモリ遅延が58%減りました。AIの推論セッションでは、データのやり取りと次バージョンのFP4の精度が焦点になります。
NVIDIAのBlackwellを巡り、MLPerfで全項目最速と報告されました。さらに論文ではB200がH200比で学習スループットが1.85倍、エネルギー効率が32%向上したと実測されています。AIの推論と学習で、FP4と省エネの差が焦点です。
BlackwellがAI学習ベンチマークMLPerf Training v5.1で7モデル全項目の最速学習を掲げました。FP4/NVFP4とB200の実測から、学習速度と電力効率の差が見えます。推論を含む評価の中心が接続から学習へ動いています。
公式資料と製品解説を踏まえ、NVIDIAの話題はH100からBlackwellへ移り、推論と接続が中心です。H100は推論が最大30倍、BlackwellはH100比で推論が約5倍とされます。電力、価格、入手方法など運用条件の違いが読み取れます。
H100の現役性とBlackwellの実測差が話題です。2026年時点でH100は主力で、SXM5とPCIeの差、FP8推論、B200がH200比で混合精度1.56倍、省電力42%、キャッシュミス時遅延58%減という検証から、世代より構成が重要だと読み解きます。
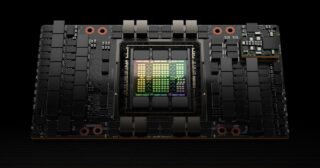
H100はLLMと推論を最大30倍高速化し、GPT-3 175B学習を4倍速くするとされます。Grace Hopperは10倍を掲げますが、BlackwellのMLPerf席巻には具体的な数値がありません。データセンターの動向を追います。
NVIDIAのRTXに隠れたAI推論の速度制限を、Linux向けモジュールが外した話題です。RTX 3090 TiではBF16が87.5から157.4 TFLOPSへ伸び、Dellの96GB GPU搭載機も価格面で注目されています。
OpenAIがGoogleのTPU購入を検討していると報じられました。Nvidia依存を減らす動きですが、金額や数量は未確認です。推論コストとaiチップ市場への影響、TPU調達とNvidia市場への波及を整理します。
eBayに9,600枚のA100と4,200個のEPYCを積んだ約6,000万ドルのクラスタが並びました。一方、NVIDIAは40言語対応の音声モデルを公開し、英語WER4.71%を報告しています。旧GPU市場と新モデルの両面からNVIDIAの今を追います。
NVIDIAが音声aiモデルNemotron 3.5 Transcribeを公開しました。最適化NIMでは1枚のGPUで毎秒2,238秒分の音声を処理できるとされます。公開版の速度差やローカル実行の注意点を読み解きます。
2026.11.07
続・NVIDIA:H100は現役の主役、形態と価格で分岐
2026.11.07
続・Hermes追跡(16):アーキテクチャと評価の現在
2026.11.07
続・GGUFはMoE実装の入口、Xing4.0の量子化で見る中間型
RECENT COMMENTS