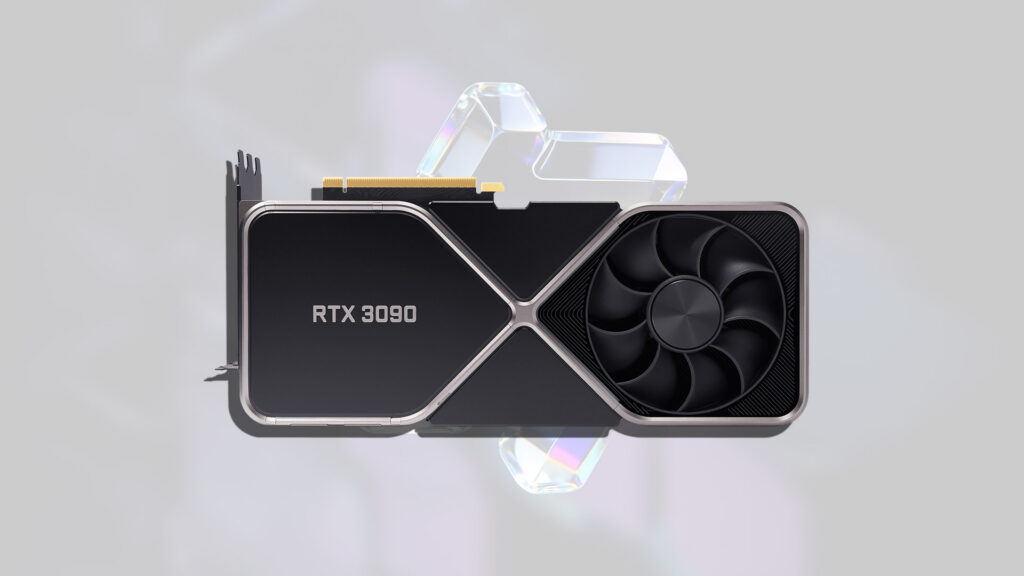
発売から5年以上たったRTX 3090が、ローカルAIの世界でまたにぎわっています。今度の話題は「何も買わずに速くなる無料ハック」です。Xで見つけた最適化をRedditのユーザーが1枚の3090で試し、結果を報告しました[1]。別の開発者は27Bモデルの生成速度を約4.6倍に引き上げており、海外メディアも報じています[2]。
無料ハックの検証結果を見てみましょう。うたい文句はプロンプト処理(PP)15%、テキスト生成(TG)5%の高速化で、追加費用はゼロです[1]。試したユーザーはQwen3.8 27Bで、最適化の前後をベンチマークしました。するとプロンプト処理のスループットは22〜30%向上。うたい文句を上回る結果です[1]。生成速度は1〜5%と控えめでしたが、テスト中にGPUエラーは出なかったといいます[1]。補足も見逃せません。この3090は計測中も230ワットに電力制限されており、制限を外せば伸びしろはさらに大きいようです[1]。
一方、もっと大きな数字を出した開発者もいます。Redditorの「u/iamMess」さんが、Qwen3.8-27Bの生成速度を82 tok/sから382 tok/sへ引き上げました。約4.6倍です[2][4]。出発点はボトルネックの分析でした。3090はメモリ帯域が936.2GB/sと速いのに、モデルの重みをメモリから読み出す待ち時間が長く、演算器が遊んでしまうといいます[2]。
そこで使ったのが推測的デコーディングです。速い下書き役(ドラフター)が先のトークンを複数予想し、本体モデルがそれを一括でチェックします。正しいものだけ残す仕組みで、最終判断は本体が行うため、出力は最適化前と変わりません[2]。速度は段階的に伸びました。まずモデル内蔵のマルチトークン予測(MTP)を調整して114 tok/sです。MTPはモデルが自分で次の数トークンを予想する機能です。さらに「DFlash2」というドラフターを追加します。こちらは7トークン先を提案します。会話内の既出テキストを再利用する「lookup」ドラフターと組み合わせ、138 tok/sに到達しました[2][4]。エンジンは1ステップで16トークンをチェックし、引用のような場面では約15個を受け入れるといいます[4]。
実測値の詳細も整理しておきましょう。25,000トークンの文書タスクでは382 tok/sを記録しました。一方、普通のチャットでは約133 tok/sです[4]。コンパクトなメモリ形式の採用で、一度に扱える文章量(コンテキスト)を138,696トークンまで広げた点も特徴です[4]。数学ベンチの精度は96.5%で維持されたと報告されています[2][4]。
ただし、4.6倍という数字には条件があります。大きく伸びるのは、モデルがすでに書いたテキストを繰り返す場面です[2]。通常会話なら133 tok/sと、伸び幅はずっと小さくなります[4]。コミュニティの反応も、手放しの称賛だけではありません。「3090を持っていないので確認できないが、他のGPUにも効果はあるのか」という声が上がりました[3]。投稿者は元投稿とは無関係だと断った上で、こう推測しています。かつてマイニング需要対策として施された制限を外すハックが存在し、今回の話はその生き残りなのではないか、と[3]。
周辺を見ても、3090向けの試行は続いています。llama.cppの新たな高速モードを試した記事[5]や、3090のローカルLLMベンチマークをまとめた記事[6]が登場しました。セッティング1つで10倍速くなったと題する検証記事[7]もありますが、素材には詳細がなく中身は確認できません。GitHubでは、1枚の3090でQwen3.8-Flash-Nextを動かすレシピ「FreeToken」も公開されています。量子化(重みを圧縮してメモリを節約する仕組み)の4ビット形式「NVFP4」を使う構成です[8]。こちらも素材に実測値は見つかりませんでした。
ハードはそのまま、ソフトの工夫だけで速度が変わります。無料ハックの22〜30%と推論エンジンの4.6倍では規模が違いますが、方向は同じです。古いGPUの価値をソフトが押し上げる流れは、当分続きそうです[1][2]。
RECENT COMMENTS