「自作の推論エンジンなんて、llama.cppをクローンすればいい」——。ローカルLLM好きの集まるReddit板r/LocalLLaMAに書き込まれたこのディスカッションが、反響を呼んでいます[1]。投稿者は、AIとの対話でコードを書き進める「バイブコーディング」で、推論エンジンを実際に作りました。動くものはできあがったのに、結論は「クローン推奨」でした。どこに落とし穴があったのか、今回の素材から読み解きます。
投稿者が作ったのは、Webブラウザの中で動くエンジンです。まずgguf形式(学習済みモデルの重みを保存するファイル形式)のモデルを読み込みます。このモデルは量子化されています。量子化とは、重みを圧縮してメモリを節約する仕組みです。今回は4ビットに圧縮するq4が使われました[1]。計算には、ブラウザのグラフィックス技術WebGL2が使われています[1]。GPU向けの計算は、その描画用言語GLSLで書かれていました[1]。専用アプリを入れずに、HTMLのページを開くだけで動く構成です。
ただし、投稿者いわく「トークナイザと語彙は終わりのないデバッグ地獄」だったといいます[1]。トークナイザは、文章をトークンと呼ばれる単位に分割する部分です。ここが崩れると、モデルが正しくても出力が壊れます。以前取り上げた「難所はトークナイザ」という指摘が、別の挑戦者からも繰り返された形です。結局、投稿者自身が「素直にllama.cppをクローンしたほうがいい」と締めくくりました[1]。
一方、解説記事の形での自作も続いています。「Build Your Own Inference Engine: From Scratch」では、約200行のPythonで動くエンジンを組み上げました[2]。小さな公開モデルを読み込み、プロンプトを受け取り、トークンを1つずつ順に送り出します[2]。処理は、トークナイザでの入力分割から始まります。次のprefill(プロンプト全体を一括処理する段階)では、KVキャッシュが作られます。KVキャッシュとは、一度計算した結果を保存し、同じ計算を繰り返さない仕組みです。最後のdecode(トークンを1つずつ生成する段階)を、終端トークンが出るまで繰り返します[2]。
筆者いわく、この200行こそが土台です。vLLM(大規模運用向けの定番エンジン)やTensorRT-LLMが各段階をどう最適化しているか、理解の助けになるといいます[2]。スクラッチで作る系の解説やガイドはWeb上にすでに複数あります[5]。学習目的の自作は、もはや定番の題目のようです。
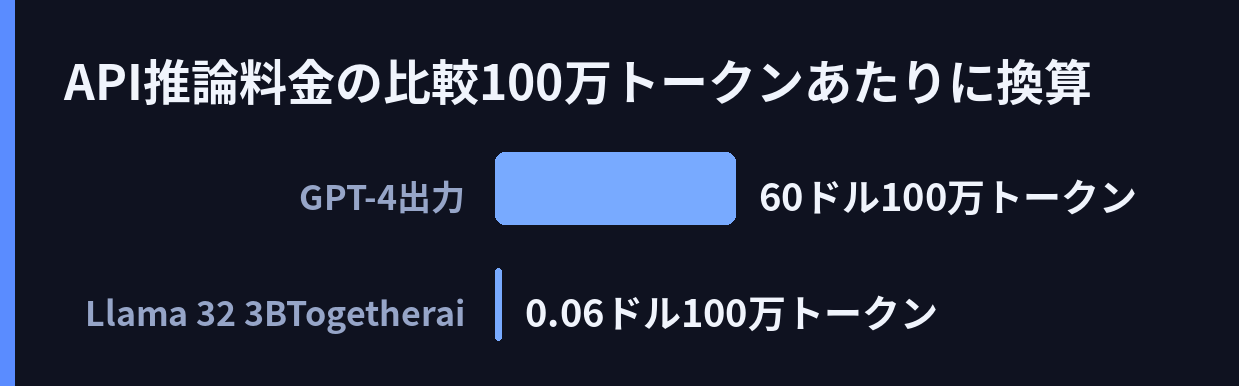
では、なぜ自作するのでしょうか。別の解説を書いたAIエンジニアは、アーキテクチャを目的に合わせて調整できることを理由に挙げています[3]。トランスフォーマー(生成AIの基盤となるネットワーク構造)への理解も深まるといいます[3]。料金の実例も参考になります。GPT-4のAPIは、出力1000トークンあたり0.06ドルです。100万トークン単位に直すと60ドルになります。一方、Together.aiのLlama 3.2 3Bは、100万トークンあたり0.06ドルでした[3]。同じ「0.06ドル」でも、単位が1000倍違います。性能の高いモデルほど料金も上がる、という例も示されています。GPT-4はMMLU(広範な知識を測るベンチマーク)スコア83で、GPT-3.5より高価です[3]。モデルの規模が違うため単純比較はできません。それでも、API利用の価格幅の大きさは、自作やセルフホストを検討する動機になるようです。
しかし、成功話ばかりではありません。「なぜ創業者たちは自作推論エンジンのバイブコーディングに失敗し続けるのか」と題した記事まで登場しています[5]。理由の一つは、便利さの裏にある問題です。Hugging Faceの生成関数ひとつ、APIの1行呼び出しも、内部を隠してくれます[2]。速度が出ない・長い入力でメモリが足りなくなる・複数ユーザーで待ちが発生する。こうした問題の原因は、エンジンの内部を見た人にしか分からないと解説記事は指摘します[2]。実戦寄りには、vLLMの上に独自の推論パイプラインを組み、大規模に運用するガイドもあります[4]。バイブコーディングの手法自体が、論文のサーベイで整理されるほどの話題です[5]。試行と失敗がセットで積み上がっているのが、今の段階のようです。
自作推論エンジンの収穫は、実用エンジンの置き換えではなく、理解にありそうです。200行のコードで、仕組みの全体像は掴めます[2]。その先には、トークナイザのデバッグ[1]と、速度やメモリのチューニングという壁が続きます。「クローン推奨」という結論は、壁の高さをそのまま示しているのかもしれません。
引用ソース
- Reddit Reddit r/LocalLLaMA: Vibecoding your own inference engine is easy they said — https://www.reddit.com/r/LocalLLaMA/comments/1xdh57e/vibecoding_your_own_inference_engine_is_easy_they/
Vibecoding your own inference engine is easy they said
- Web記事 記事全文: Build Your Own Inference Engine: From Scratch | martinuke0's Blog — https://martinuke0.github.io/posts/2026-09-01-build-your-own-inference-engine-from-scratch/
TL;DR — A working LLM inference engine is just four stages: tokenize the prompt, run a forward pass through transformer blocks while filling a KV cache, sample the next token, and repeat until the model emits an end-of-s
- Web記事 記事全文: Building an LLM Inference Engine 'From Scratch' — https://sushantvema.github.io/notes/llm_inference_engine
Let’s learn how to build a llm inference engine from scratch.
Philosophy
Abstraction forces you to reach the highest level of the basics. – Alan Soffer
Introduction
In the rapidly evolving field of Artificial Intelligenc - Web記事 Web検索: vLLM Advanced: Building Custom Inference Pipelines at Scale (2026 Guide) — https://inference.net/content/vllm-advanced-custom-inference-pipelines/
vLLM Advanced: Building Custom Inference Pipelines at Scale (2026 Guide)
- Web記事 Web検索: Why founders keep failing to vibecode their own LLM inference engine — https://startupfortune.com/why-founders-keep-failing-to-vibecode-their-own-llm-inference-engine/
Why founders keep failing to vibecode their own LLM inference engine
- Web記事 Web検索: A Survey of Vibe Coding with Large Language Models – arXiv.org — https://arxiv.org/pdf/2510.12399
A Survey of Vibe Coding with Large Language Models – arXiv.org
- Web記事 Web検索: Building LLMs from Scratch: A Working Engineer's Guide — https://martinuke0.github.io/posts/2026-09-07-building-llms-from-scratch-a-working-engineer/
Building LLMs from Scratch: A Working Engineer's Guide
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS