📌 エグゼクティブサマリー
AIエージェントの振る舞いをCIで自動検証するCATTが0.2.1に更新。模倣した振る舞いの根拠を4段階のラベルで明示する一方、合格しても公式アシスタントとの互換は保証しないと明言しています。エージェントをgVisorなどで隔離する動きもあわせて追いました。
「AIエージェントに任せた仕事は、本当に正しく動いているのか」。この不安に答える道具が、このところ相次いで登場しています。以前この連載で取り上げたCATTが、0.2.1に更新されました[1]。あわせて、エージェントを隔離環境で安全に動かす試みも進んでいます。今回は、その「その後」を追いました。
CATT(Consumer Agent Testing Tool)は、AIアシスタントが自分のサービスをどう使うかを、リリース前に試せるオープンソースのツールです[5]。テスト対象は、MCPサーバー、Webサイト、HTTP APIです。MCPは、AIアシスタントと外部サービスをつなぐ接続規格です。MuseやInstinctといった主流アシスタントの模倣相手を用意し、共通のコネクタテスト契約に沿って動かします[5][7]。カバー範囲は、ルーティング、メモリ、支払い、ブラウザ操作、スケジュール管理と幅広です[5]。こうしたテストをCI(コードの変更ごとに自動でテストを回す仕組み)に組み込めるのが特徴です[2]。
検証も具体的です。サービスが実際に何をしたかを確認し、テストで得た証拠を封印して保存し、ビルド間で結果を差分比較できます[5]。本物のアシスタントが接続してくる前に、統合の不具合をつぶすのが狙いです[5]。動かし方には、台本に沿うスクリプト実行と、モデルに推論させながら進める方式の2種類があります[5]。スクリプト実行ならモデルのアカウントも不要で、設定なしでローカル環境ですぐ動かせます[5]。
0.2.1の目玉は、透明性ラベルです[2]。模倣した振る舞いがどれほど確かかを、「documented(公式文書で確認済み)」「unofficial(非公式)」「assumed(推測)」「unknown(不明)」の4段階で示します[2]。アシスタントの中身はブラックボックスです。だからこそ、模倣の根拠を隠さず明示する発想なのです[2]。開発者はこのラベルを見て、テスト結果をどこまで信頼できるかを自分で判断できます。
Hacker Newsでの反応も、エージェント時代らしいものになりました。投稿は7ポイント、2コメントにとどまっていますが[1]、DaaSを開発中という開発者は「有用そうだが技術的にも見える。AIエージェントと相談しながら導入を検討する」と書いています[3]。投稿者も「あなたから、あるいはあなたのエージェントから、フィードバックをもらえるとうれしい」と返しています。道具を評価するのが、人とエージェントの共同作業になりつつあるようです。
ただし、ここには重要な留保があります。CATTはアシスタントの完全な複製ではなく、「テストホスト」として作られています。そして、テストに合格しても公式アシスタントとの互換性を保証するものではないと、明言しています[2]。模倣には限界がある、という正直な設計です。「テストを通ったから大丈夫」とは読めないわけです。
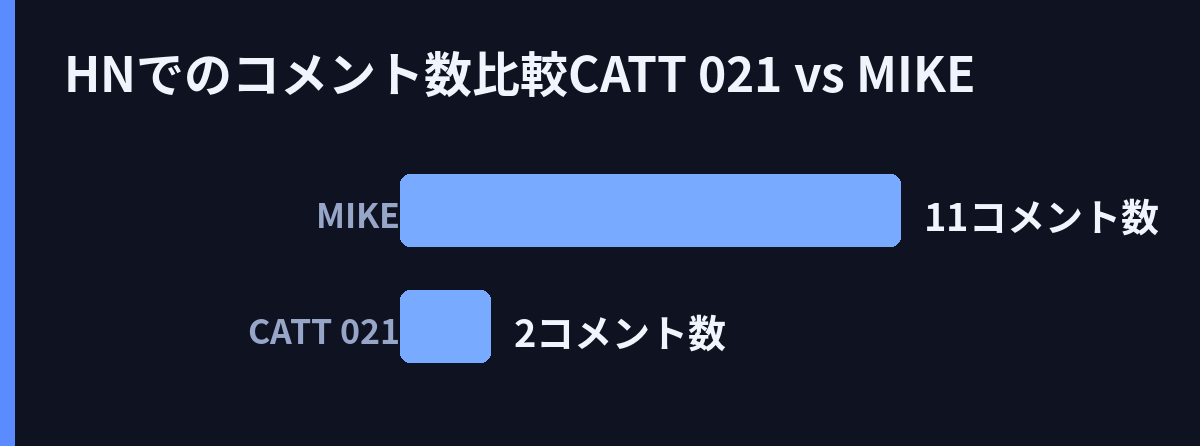
一方、エージェントの側を「囲う」動きも続いています。MIKEというプロジェクトは、gVisor(プログラムを隔離した檻の中で動かすサンドボックス技術の一つ)でエージェントを囲い、テックリードの役割を担わせる試みです[4]。こちらは3ポイントに対して11コメントと、評価の数を大きく上回る議論が集まっています[4]。エージェントの隔離技術は2026年に入って選択肢が広がり、Firecracker、gVisor、WASMの使い分けが解説されるようになりました[6][8]。以前取り上げた実践メモでは、Firecrackerは125ミリ秒で起動するとありました。軽さが武器の隔離技術です。
テストと隔離。エージェントが実サービスを操作する時代には、この二つがそろって初めて、安心して仕事を任せられます。CATTが不確かさを4段階で明示したように、道具の側が限界を正直に示す流れができてきました。次は「検証済みのエージェントを、どう安全に本番へ出すか」が問われそうです。
RECENT COMMENTS