125BのMoEを、1枚のRTX 5080で動かすという報告が再び目立ちます。Redditでは、Basaltの新しいPR(Strata fork、一部は未統合)でQwen3.8 Flash NextのIQ3_Sが、prefill(プロンプト全体を一括処理する段階)は5500TPS、decode(トークンを1つずつ生成する段階)のピークは275TPSという記録が出たとされています[1]。以前取り上げた5060Tiの量子化比較とは違い、今回は上位GPUでの実測が中心です。
このモデルはMoE、つまり専門家ネットワークを切り替えて動く125Bの大型モデルです。Strataはそれを、NVIDIA GPU 1枚(12〜24GB)と64GB RAMで動かすことをうたいます[2]。無料のオープンソースです[2]。Windows/Linux対応、ワンクリック導入とされ、RTX 5070 12GB、Ryzen 5 7600、64GB RAMでは60〜95TPS、RTX 3090 24GBなら100〜140TPSとされています[2]。
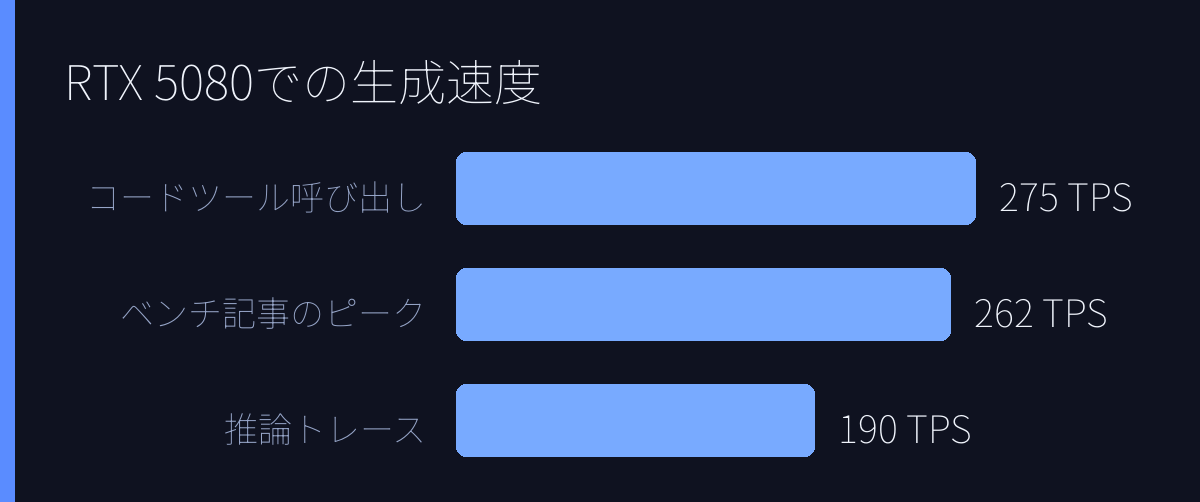
Redditの報告では、RTX 5080 16GB、PCIe Gen5 x16(高速な接続)、Core Ultra 9 285K、64GB DDR5-6400という構成です[1]。RAMは51GB使用とされ、opencodeのコーディング中にコードやツール呼び出しで275TPS、推論トレースで190TPSまで出たとされています[1]。IQ3_Sは重みを圧縮する量子化の一種で、実用的だと評価されています[1]。
別のベンチ記事では、同じRTX 5080で262Kコンテキスト、int8 KVという設定が測られています[4]。int8 KVは、会話の記憶を8bitに圧縮する設定です。prefillは平均5011TPS、ピーク5118TPSでした。decodeは平均153.0TPS、ピーク262TPSです[4]。

コンテキストを伸ばした測定も載っています。15Kから207Kまでの新規プロンプトでは、prefillは平均5475TPS、ピーク5662TPS、decodeは平均154.9TPS、ピーク186.6TPSとされています[4]。VRAMは15.7GB、RAMは54.1GBを使い、空きは5.1GB程度でした[4]。16GB VRAMぎりぎりで、RAMの余裕が重要だとわかります。
注目したいのは、プロンプトキャッシュ(過去に入力した内容を再利用する仕組み)の効き方です。エージェントのコーディングセッション(103リクエスト、最大130Kコンテキスト)では、プロンプトトークンの99.5%がキャッシュ由来で、最初のトークンが出るまでの中央値は0.2秒とされています[4]。prefillでは、10.7Kと8Kの新規トークンだけがキャッシュ外でした[4]。長い文書やコードを何度も読む作業では、prefillの速さよりもキャッシュの命中率が体感速度を大きく変えるようです。
ただし、速さの裏に制約もあります。Strataの構成では、モデルを分割したshard 1を起動時に読み、専門家部分をRAM、残りをGPUに置き、29GBの参照用テーブルはSSDに置くと説明されています[2]。shard 1に加え、OSや他のアプリ用に約10GBのRAMが必要とされています[2]。GPUを大きくすると速くなりますが、必要なRAMは減らないとされています[2]。つまりGPUが速くても、RAMが足りないと動かない場面があります。64GB RAMならIQ3_Sも入るとされますが、他のアプリを開くと苦しくなるようです[2]。48GB RAMでは、より圧縮した量子化が挙げられています[2]。消費電力の実測値は、素材には見つかりませんでした。UkisAIによるSwift 1.5は、推論の途中を短くする派生で、元のモデルとほぼ同じ速度とRAMとされています[2]。
GitHubでは、StrataやBasaltの派生が複数確認できます。BasaltはQwen3.8-Flash-Next向けのローカル推論エンジンとして紹介されています[5]。Niko1221やmach10xのStrataリポジトリも、コンシューマーGPUでの実行をうたっています[6][6]。2枚のGPUで125B MoEを動かした測定記事も検索結果に出ており、試行錯誤が広がっています[6]。公式リポジトリの検索結果も複数あり、名前が似ているため混乱しやすいです[2]。Xトレンドでは「Gemini4Carbon」が語として上がっています[3]。Strataの話題と直接つなげる材料はありませんが、大型モデルの話題が同時に動いている状況です。RTX 5080の275TPSは派手ですが、実用ではRAM、キャッシュ、量子化の選び方が分かれ目になりそうです[1][2][4]。
引用ソース
- Reddit Reddit r/LocalLLaMA: [Update Benchmark] Basalt’s new PRs (Strata fork) new record IQ3_S Qwen3.8 Flash Next on single RTX 5080 and 51 GB RAM with 5500 tok/s prompt processing and up to 275 tok/s peak generation (during opencode coding live session) — https://www.reddit.com/r/LocalLLaMA/comments/1xi9sfl/update_benchmark_basalts_new_prs_strata_fork_new/
[Update Benchmark] Basalt’s new PRs (Strata fork) new record IQ3_S Qwen3.8 Flash Next on single RTX 5080 and 51 GB RAM with 5500 tok/s prompt processing and up to 275 tok/s peak generation (during opencode coding live session)
- Web記事 記事全文: GitHub – kstevica/strata: Qwen3.8-Flash-Next (125B MoE) on a 8GB … — https://github.com/kstevica/strata
Run a 125-billion-parameter AI model on a normal gaming PC
one NVIDIA card (12-24 GB) + 64 GB of RAM · Windows or Linux · one click to install
A voxel pagoda garden, 1 shot prompt running on an RTX 5070 with Strata (IQ3_ - X Xトレンド: Gemini4Carbon — https://trends24.in/japan/
Gemini4Carbon
- Web記事 記事全文: [Benchmark] Strata/Basalt runs Qwen3.8 Flash Next IQ3_S with 16GB VRAM … — https://daily.rclabs.in/i/benchmark-strata-basalt-runs-qwen3-8-flash-next-iq3-s-with-16gb-vram-a-11fc44
From the sourceQwen3.8-Flash-Next IQ3_S on Basalt | RTX 5080 16 GB, Core Ultra 9 285K, 62 GB DDR5-6800 | 262K context, int8 KV Workload (prompts 5K+) PP avg (t/s) PP peak (t/s) TG avg (t/s) TG peak (t/s) VRAM RAM (engine
- Web記事 Web検索: GitHub – jesdga95/basalt: Local inference engine for Qwen3.8-Flash-Next … — https://github.com/jesdga95/basalt
GitHub – jesdga95/basalt: Local inference engine for Qwen3.8-Flash-Next …
- Web記事 Web検索: GitHub – Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware … — https://github.com/Niko1221/Strata
GitHub – Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware …
- Web記事 Web検索: GitHub – mach10x/strata: Qwen3.8-Flash-Next on any consumer hardware … — https://github.com/mach10x/strata
GitHub – mach10x/strata: Qwen3.8-Flash-Next on any consumer hardware …
- Web記事 Web検索: Qwen3.8-Flash-Next on Strata: a 125B MoE on Two Consumer GPUs, Measured — https://www.bigiron.cc/guides/qwen3-8-flash-next-on-strata-a-125b-moe-on-two-consumer-gpus-measured
Qwen3.8-Flash-Next on Strata: a 125B MoE on Two Consumer GPUs, Measured
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS