「自作の推論エンジンは簡単だと言われていたのに」。Redditのr/LocalLLaMAに、こんな皮肉のタイトルの投稿が話題になっています[1]。投稿者は、AIにコードを書かせて進める「Vibecoding」で、LLMの推論エンジン自作に挑戦しました。その奮闘記と、時を同じくして現れた学習教材の数々が、この分野の今を映しています[6]。
投稿の中身は技術的に濃いものです。投稿者はGGUF形式のモデルを使いました。GGUFは量子化(重みを圧縮してメモリを節約する仕組み)済みのモデルを保存する形式です。今回は重みを4ビットに圧縮する「q4」が選ばれています[1]。さらにpaged attention(メモリをページ単位で管理し、断片化を防ぐ仕組み)を組み込みました[1]。計算には、ブラウザのGPU描画機能WebGL2と、そのシェーダー言語GLSLが使われています[1]。モデルはHTMLファイルの中で動いています。ブラウザだけでLLMが走る実装です。
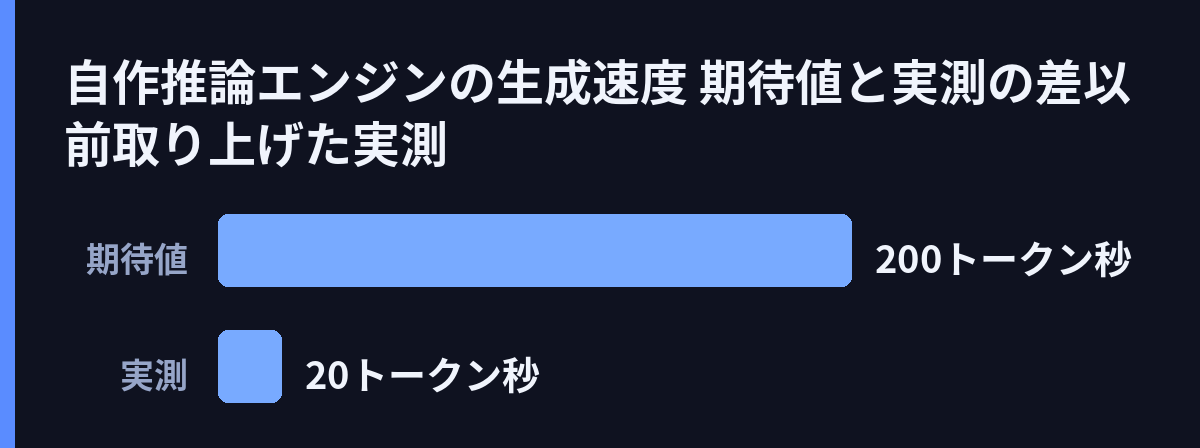
ただ、道のりは平たんではありませんでした。投稿者はトークナイザ(文章をトークンIDに分割する部分)と語彙の処理を「終わらないデバッグ地獄の一部だった」と振り返ります[1]。速度の壁も以前から指摘されています。以前取り上げた実測では、期待では200トークン/秒なのに20トークン/秒しか出ない場面が報告されていました。自作の「簡単さ」には、大きな但し書きが付きます。
一方で、この「自作」を支える教材が相次いで登場しています。注目は執筆中の書籍「Inference From Scratch」です[3]。PythonとPyTorchだけで、推論エンジンを一から作らせる内容です。対象は、推論システムの中身を知りたいMLエンジニアや、LLMをサービスとして動かす仕組みが普通のWebサービスと何が違うのか気になるシステムエンジニアです[3]。エンジンの心臓部を、すべて自分の手で書かせます[3]。トークンを1つずつ生成し続ける自己回帰ループも、スケジューラやバッチ処理も自作です[3]。KVキャッシュ(計算済みの途中結果を保存し、やり直しを省く仕組み)も自分で組みます[3]。speculative decoder(先読みで生成を速くする仕組み)まで範囲に含みます[3]。完成品は「簡易版のvLLM(有名な推論エンジン)」になるといいます[3]。
章立ても学習向きです。各章で最適化を1つ追加し、同じベンチマークで速度向上を測ってから、1行の差し替えでサーバーに組み込みます[3]。数値は同じハードウェア・同じモデル・同じプロンプトでの実測だと強調されています[3]。必要なのはPythonの基礎だけで、GPUプログラミングの経験は不要です[3]。第13章まで進むと、Flash attention(長い文章ほど膨らむメモリ使用量を、2乗ではなく1列分に抑えるアテンション実装)を扱えます[3]。paged attentionやprefix caching(同じ冒頭部分の計算を再利用する仕組み)も題材です[3]。INT4量子化でメモリ使用量を半分にする最適化も含まれます[3]。
もう一つの学習パス「Build an LLM From Scratch」は、モデル内部の理解に重心を置きます[2]。対象は、モデルを黒箱のまま扱うのに疲れたアプリ開発者や、画像認識など別分野からのMLエンジニアです[2]。実習は手を動かす構成で、タイプした文字がどうトークンに分割されるかを目で確認できます[2]。小さなテキストデータを使い、最頻出ペアを結合してBPE(頻出する文字ペアを順に結合して語彙を作る方式)を作る課題もあります[2]。トークンのコストや文脈上限、モデルがstrawberryの文字数を数えられない理由まで説明されます[2]。範囲の最後は、モデルを大きくするほど性能が予測可能に伸ぶスケーリング則から、予測器がアシスタントへ変わる好みの調整までです[2]。
周辺にも同様の動きが広がっています。ローカルでLLMを動かす2026年版の総合ガイド[4]、自作の過程を綴るブログ[5]、GitHubでは「スクラッチから本番まで」を掲げるリポジトリ[6]、モジュール式エンジンを組んだ学びの記録がMediumにも投稿されました[6]。教材は豊富になり、入口は大きく広がったと言えます。しかし、Reddit投稿者の結論は、この流れを裏切ります。「マジでllama.cppをcloneしたほうがいい」と述べています[1]。cloneはリポジトリを丸ごとコピーして使うこと。つまり、既存の推論エンジンをそのまま使えという助言です。
自作推論エンジンの話題は、失敗談から教材へと舞台を移したようです。ブラウザで動く実装も、章立てされた書籍も、「黒箱を開ける」ための道筋が整ってきたことを示しています。一方で、作る楽しさと使う実利は別物です。学びには自作、実務にはllama.cppという使い分けが、しばらく続くと思われます。
引用ソース
- Reddit Reddit r/LocalLLaMA: Vibecoding your own inference engine is easy they said — https://www.reddit.com/r/LocalLLaMA/comments/1xdh57e/vibecoding_your_own_inference_engine_is_easy_they/
Vibecoding your own inference engine is easy they said
- Web記事 記事全文: Build an LLM From Scratch — A Free Learning Path | Vibe Engines — https://vibeengines.com/learn/llm-from-scratch
How this path works
This path is for engineers who use language models every day and want to know what happens between the prompt and the next token: application developers tired of treating the model as a black box, ML - Web記事 記事全文: Introduction – Inference From Scratch — https://arunpatala.github.io/inference-from-scratch-book/intro.html
This book is a work in progress. Chapters are being released incrementally.
Most engineers who work with language models treat them as black boxes: send a prompt, get a response. This book opens every box.
You will build - Web記事 Web検索: Building and Running LLMs Locally from Scratch – Complete 2026 Guide — https://amitray.com/building-running-llms-locally-from-scratch/
Building and Running LLMs Locally from Scratch – Complete 2026 Guide
- Web記事 Web検索: Build Your Own Inference Engine: From Scratch | martinuke0’s Blog — https://martinuke0.github.io/posts/2026-09-01-build-your-own-inference-engine-from-scratch/
Build Your Own Inference Engine: From Scratch | martinuke0’s Blog
- Web記事 Web検索: VijayAIeng / llm-inference-from-scratch-to-production Public — https://github.com/VijayAIeng/llm-inference-from-scratch-to-production
VijayAIeng / llm-inference-from-scratch-to-production Public
- Web記事 Web検索: I Built a Modular LLM Inference Engine from Scratch – Medium — https://medium.com/@murali8k/i-built-a-modular-llm-inference-engine-from-scratch-heres-what-i-learned-ae0aae552945
I Built a Modular LLM Inference Engine from Scratch – Medium
- Web記事 Web検索: Vibecoding your own LLM inference engine: GGUF… · AGI Hunt — https://agihunt.info/en/p/1a169650a53683a8d7ee722712f
Vibecoding your own LLM inference engine: GGUF… · AGI Hunt
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS