16GBのGPUで235Bのモデルが動く——。この技をスマホやノートPCに持ち込む試みが、始まったばかりです。Hacker Newsに投稿された「BigMoeOnEdge」は、llama.cppの上に被せるレイヤーという形で、大きなMoEモデルをスマホやノートでストリーミングのように動かします[1]。MoEオフロードをめぐっては、このほかにも実装や解説が相次いで登場しています。
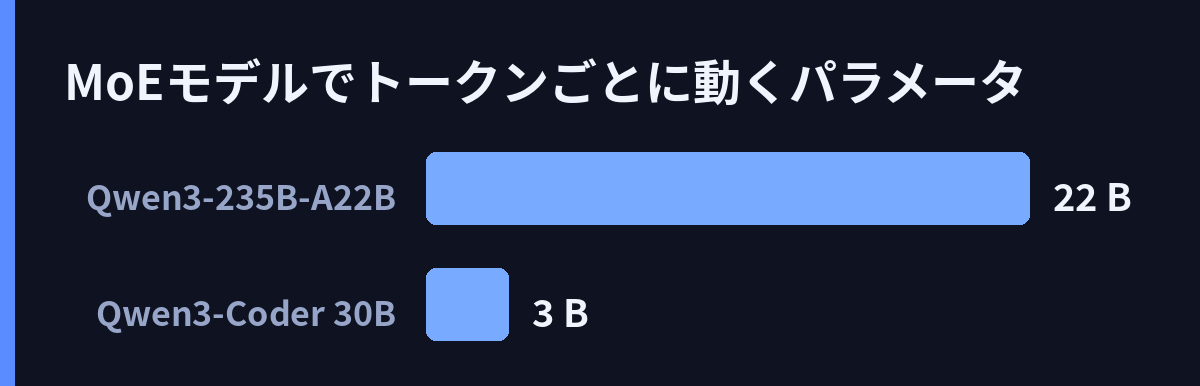
そもそもなぜ、巨大モデルが小さなマシンで動くのでしょう。鍵はMoE(Mixture-of-Experts、多数の「エキスパート」からトークンごとに必要な一部だけを選んで計算する仕組み)にあります。Qwen3-CoderやDeepSeekクラスのモデルをローカルで動かす魅力はここです。トークンごとに動くのは、パラメータのごく一部だけだからです。解説記事によると、Qwen3-Coderの30Bモデルは、動くのは一度に3Bだけです[2]。以前この連載で取り上げたQwen3-235B-A22Bも、総235Bのうち動くのは約22Bでした。ただし、動いていないエキスパートの重みも、どこかに置いておかねばなりません。llama.cppは、動くかどうかに関わらず全エキスパートを保持し続けるためです[2]。16GBや24GBのマシンでは、この「置き場所」が最大の壁になります[2]。
今日すでに使えるのが、エキスパート重みをGPUの外へ逃がすオプションです。–n-cpu-moeという指定は、先頭のN層ぶんのMoEエキスパート重みを、VRAM(GPUのメモリ)ではなくシステムメモリ(RAM)に置きます。Nを増やせばVRAMは節約でき、代わりにトークンごとのCPU仕事が増えます。Nを減らせば、より多くのエキスパートがGPUに残り、生成は速くなります。解説記事はこの指定を「最適化ではなく、速度と余裕を交換するつまみ」だと説明しています[2]。attention(注意計算)とトークンごとの計算はセットでGPUに残るため、30BクラスのMoEモデルでも16GBのカードで実用になるわけです[2]。
さらに進むと、RAMにすら事前に置かない方式に行き着きます。エキスパートをディスクから、必要になった瞬間に読み込む流し込み方式です。前回の記事で取り上げたこの方式には、執筆時点で少なくとも5つの独立した実装があるといいます[2]。仕組みの核心は、先読みの隙間です。ルーター(トークンに必要なエキスパートを決める部分)の計算は、今の層のattentionが終わる前に終わります。この隙間に次の層のエキスパートをディスクから読み込めば、I/Oと計算を重ねられます。前回お伝えした約2倍という処理速度の向上は、この重ね合わせによるものです[2]。
新しい実装も出ています。GitHubの「llama.moe」(zilong)は、llama.cppベースで動的なエキスパートオフロードを載せた軽量推論フレームワークです。ビルドにはCUDAが必要ですが、使い方はllama-serverと同じで、コマンドを置き換えるだけで済みます[3]。周辺の解説もそろってきました。VRAMの少ない環境で大きなモデルを動かすガイド[4]や、GPU加速つきでMoEをCPU推論させる手順をまとめたHugging Faceの記事[5]、大きなMoEモデルの推論性能を詰めるガイド[6]などです。全部をCPUに置く指定や、より細かく振り分ける指定との違いを比べた記事も出ています[6]。
ただし、手放しでは喜べない点もあります。まず、注目のBigMoeOnEdgeは、Hacker Newsで1ポイント・コメント0件です。まだ誰にも評価されておらず、スマホで実用速度が出るかは不明です[1]。また、オフロードは速度との直接の引き換えです。RAMに逃がす層を増やすほど、トークン/秒(1秒間に生成できる単語の断片数)はそのまま下がります。解説記事は「正しい値は、モデルがOOM(メモリ不足)にならずに済むぎりぎりの値であり、それより下ではない」とまで言い切ります[2]。それより下の値では、モデルの読み込み自体が失敗するからです。速さを求めるほど壁にぶつかる、単純な引き換えです。
MoEの「必要な一部だけ動く」性質は、巨大AIモデルを動かすハードウェアの敷居を確実に下げています。公式のオプション、ディスクからの流し込み、スマホやノートを狙うラッパー、動的オフロードのフレームワークと、アプローチは重なりながら分化してきました。あとは実機での速度です。どの方式がどんな速度を出すのか。実測の積み重ねが、次に選ぶべき道を決める段階に入ったようです。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: llama.cpp’s MoE Expert Offload: –n-cpu-moe and Streaming, Explained — https://www.shawnmayzes.com/ai-engineering/llama-cpp-moe-expert-offload-explained/
llama.cpp’s MoE Expert Offload: –n-cpu-moe and Streaming, Explained
– 8 min read
If you’re running a mixture-of-experts model locally – Qwen3-Coder, DeepSeek-class models – the whole appeal is that only a fraction of th - Web記事 記事全文: GitHub – jklincn/llama.moe: Optimized inference of MoE models based on … — https://github.com/jklincn/llama.moe
A lightweight inference framework for Mixture-of-Experts (MoE) models, built on top of llama.cpp with dynamic expert offloading.
sudo apt update
sudo apt install build-essential cmake ccache libcurl4-openssl-dev ninja-bu - Web記事 Web検索: Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide … — https://aliteq.com/llama-cpp-moe-offloading-run-bigger-models-less-vram
Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide …
- Web記事 Web検索: Performant local mixture-of-experts CPU inference with GPU acceleration … — https://huggingface.co/blog/Doctor-Shotgun/llamacpp-moe-offload-guide
Performant local mixture-of-experts CPU inference with GPU acceleration …
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: –n-cpu-moe in llama.cpp: what it does, vs –cpu-moe and -ot · Aliteq — https://aliteq.com/n-cpu-moe-llama-cpp-what-it-actually-does
–n-cpu-moe in llama.cpp: what it does, vs –cpu-moe and -ot · Aliteq
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS