スマホやノートPCで、巨大なMoEモデルをディスクから直接「流す」。そんな試みが、Hacker NewsにShow HN(自分の作品を紹介する投稿)として現れました[1]。紹介されたのはBigMoeOnEdgeという仕組みです。llama.cppの上に被せるレイヤーとして、電話とノートPCでの大規模MoEのストリーミング推論を可能にするといいます[1]。
なぜ「流す」必要があるのか。MoE(専門家の混合)モデルは、トークンごとに一部の専門家だけが動く構造で、ローカルで動かす魅力はここにあります。Qwen3-Coderの30Bモデルなら、同時に動くのは3Bだけです[2]。ところがllama.cppは、動いているかどうかに関係なく、全部の専門家の重みに置き場所が必要です。16GBや24GBのマシンでは、この「置き場所」が最大の壁だと、以前取り上げた解説も指摘しています[2]。以前取り上げた、8GBのGPUで35Bモデルを動かした実検証[4]も、同じ壁の向こうを目指した話でした。
現行の解決策が、GPUに置く層とCPU側メモリに置く層を分ける指定(–n-cpu-moe)です。指定した数だけ、最初の層から順に専門家の重みをシステムRAMへ移します。attention(前後のトークンの関係を処理する部分)や、トークンごとに動く計算はGPUに残る分担です[2]。数を増やせばGPUのメモリ(VRAM)は節約できる代わりに、トークンごとのCPU仕事が増えます。解説はこれを「最適化ではなくつまみ」と表現します。速度と収まりを、層ごとに交換する仕組みだからです[2]。30B級のMoEモデルが16GBのGPUカードで動くのは、この交換のおかげです。実務上は、モデルがメモリ不足で落ちなくなるぎりぎりの値を探ることになります[2]。
そこに新しく動きが出てきたのが、専門家をディスクから必要なときにだけ読むストリーミングです。そもそもRAMに事前読み込みしない、という発想の転換です。仕組みの鍵は時間差にあります。トークンに必要な専門家を決めるのは、ルーターと呼ばれる計算です。この計算は、現在の層のattentionが終わる前に完了します。この隙間が「先読みの窓」になります。今の層を計算している間に、次の層に必要な専門家をディスクから読み込めるのです。読み込みの待ち時間を、計算の陰に隠すイメージです[2]。
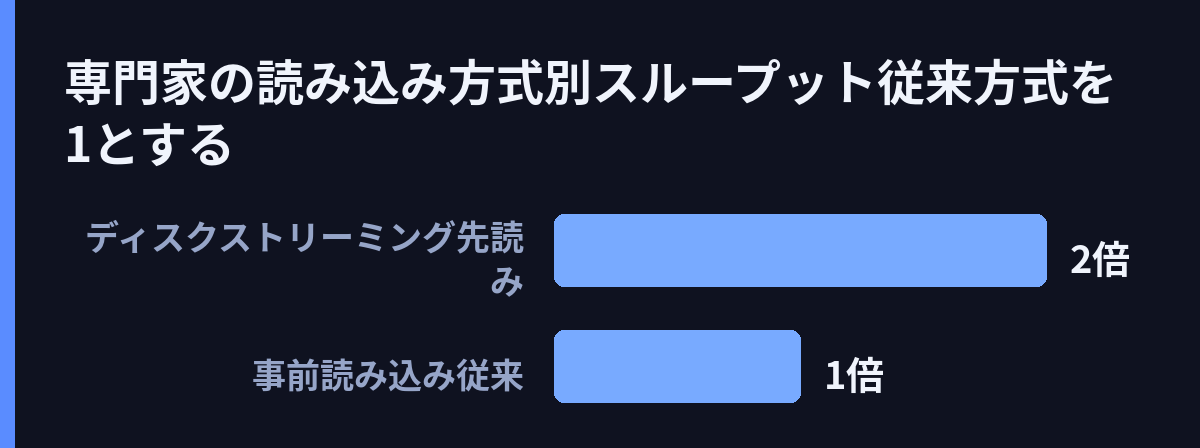
効果の報告もあります。あるプロジェクトの議論では、この読み書き(I/O)と計算の重ね合わせにより、全部を事前に読み込む方式より約2倍のスループット向上が挙げられています[2]。執筆時点で、独立した実装は少なくとも5つあります[2]。具体的な道具も出てきました。llama.moeプロジェクトは、llama.cppを土台に、専門家の重みを状況に応じて動かす仕組みを加えた軽量推論フレームワーク「zilong」を公開しています。CUDA環境を前提とし、llama.cppをビルドするスクリプトや導入手順を同梱します[3]。使い方はllama-serverと同じで、コマンドを置き換えるだけです[3]。BigMoeOnEdgeの側にも、MoEストリーミングを解説するドキュメントが置かれています[4]。周辺では、モバイル端末のLLM性能を実測した研究[4]や、大規模MoEの推論をチューニングするガイド[4]も見つかります。
しかし、熱はまだ限定的です。Hacker Newsの投稿は、ポイント1・コメント0件のままです[1]。約2倍という数値も、一つのプロジェクトの議論によるもので、統一されたベンチマークはまだありません[2]。実装ごとの比較や、ストリーミング方式の実測トークン/秒・消費電力も、今回の素材には見つかりませんでした。ストリーミングは本体への取り込みがまだ要望段階で、実装が5つ以上に分かれているのは、標準が決まっていない証拠でもあります[2]。また、RAMへ逃がす層が増えるほど、トークン/秒は直接落ちます[2]。
壁の所在は、VRAMの容量から「重みをどう賢く動かすか」へと変わってきています。先読みの窓によるストリーミングが実用になれば、スマホやノートでも巨大MoEが現実的な選択肢になります。今後の分かれ目は、並立する実装のどれがllama.cpp本体に取り込まれるか、そして約2倍の報告が他の環境でも再現するか、の2点になりそうです。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: llama.cpp’s MoE Expert Offload: –n-cpu-moe and Streaming, Explained — https://www.shawnmayzes.com/ai-engineering/llama-cpp-moe-expert-offload-explained/
llama.cpp’s MoE Expert Offload: –n-cpu-moe and Streaming, Explained
– 8 min read
If you’re running a mixture-of-experts model locally – Qwen3-Coder, DeepSeek-class models – the whole appeal is that only a fraction of th - Web記事 記事全文: GitHub – jklincn/llama.moe: Optimized inference of MoE models based on … — https://github.com/jklincn/llama.moe
A lightweight inference framework for Mixture-of-Experts (MoE) models, built on top of llama.cpp with dynamic expert offloading.
sudo apt update
sudo apt install build-essential cmake ccache libcurl4-openssl-dev ninja-bu - Web記事 Web検索: Understanding Large Language Models in Your Pockets: Performance Study … — https://arxiv.org/html/2410.03613v2
Understanding Large Language Models in Your Pockets: Performance Study …
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B … — https://www.xda-developers.com/i-stopped-thinking-my-8gb-gpu-was-too-small-after-learning-to-offload-moe-llm-layers-to-ram/
I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B …
- Web記事 Web検索: bigmoeonedge/docs/moe-streaming.md at main · denoflore … – GitHub — https://github.com/denoflore/bigmoeonedge/blob/main/docs/moe-streaming.md
bigmoeonedge/docs/moe-streaming.md at main · denoflore … – GitHub
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS