ai(AI)エージェントのHermesが、また話題になりました。リリースから7週間でGitHubスターが95,600を超えました。オープンソースのエージェント基盤として速い伸びを見せたようです[1]。前回は使うほど育つ設計に注目しました。今回の続報では、それを信頼できる形で本番に載せるかが焦点になっています。単に賢い返答を返すことと、運用で壊れないことは別物です。注目度は、単なる話題性ではなく、運用評価の必要性と結びついています。
Hermes Agentの中核は、三つの仕組みでできています。まずセッションメモリ、永続メモリ、スキルメモリの三層です。セッションメモリは今の会話の文脈を持ち、永続メモリは長期の事実や好みを入れます。スキルメモリは、過去のタスクで得た解法パターンを推論時に引き出します。似た作業を速くする仕組みです[1]。この三層は、記憶をただ溜めるだけでなく、再利用の単位を分けている点で面白いです。
永続メモリはSQLiteというデータベースとFTS5全文検索で保存されます。10,000件超の文書でも検索遅延が約10msという数字が示されています[1]。10msはflash(一瞬)に近い速さを想像させます。もっとも、この数字は検索の話であり、エージェント全体の応答速度を直接示すものではありません。素材には、同じ条件での全体の速度比較は見当たりませんでした。ただし、記憶の取り出しが速いことは、長い会話や多くの資料を扱うエージェントでは重要な前提になります。
スキルセットは三階層で扱えます。bundled、optional、communityです。bundledは標準で入ります。optionalは公式だが専門向けです。communityはHermes Skills Hubで得られます[1]。スキルは学習済みのソリューションの単位で、実行を通じて磨かれた再利用可能な解法パターンです。GEPAは実行トレースから失敗理由を分析します。ツール説明、システムプロンプト、スキル実装、コードを改善します[1]。この自己改善ループは、推論と行動の両方を育てる設計です。
GEPAの位置づけも注目されます。Genetic-Pareto Prompt Evolutionと名付けられた仕組みです。失敗した理由をトレースから読み取り、プロンプトや実装を自動的に更新します。素材では、ICLR 2026 Oralの論文で詳しく説明されているとあります[1]。論文名は「Reflective Prompt Evolution Can Outperform Reinforcement Learning」です。強化学習より反射的なプロンプト進化が上回る可能性を示した、という紹介です。自動で回る点が、手動調整との違いです。
40以上の内蔵ツールと、OpenRouterというモデル接続サービス経由で200以上のモデルにアクセスできる点も特徴です[1]。ツールには、Web検索、ターミナル、ファイル操作、ブラウザ自動化、画像分析、画像生成、音声合成、コード実行が入ります。さらに、サブエージェント委任、メモリ操作、タスク計画、cron(定期実行)予約、複数モデル推論も使えます。この広さは意図的です。脚本化された狭い動作ではなく、実世界のエージェント能力を評価するために必要だと説明されています[1]。
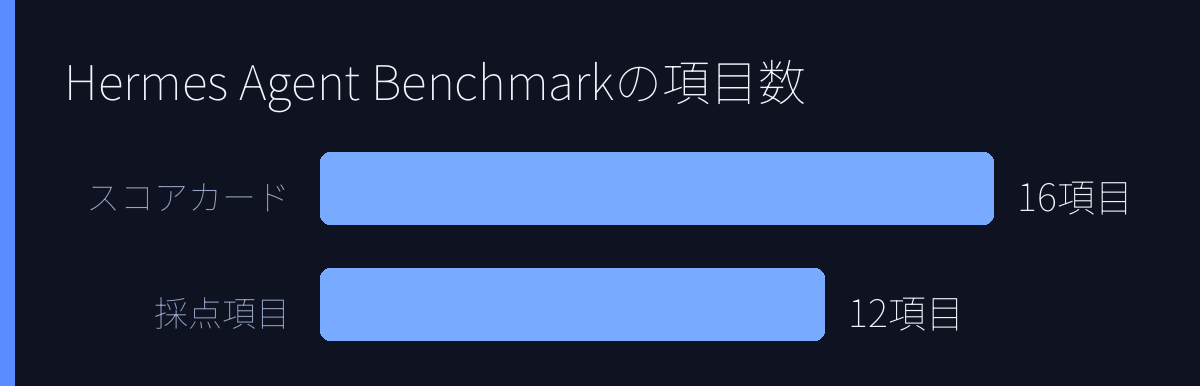
Hermes Agent Benchmarkは、正確さだけを見ません。hacker(攻撃者)を想定したような敵対的圧力の下で信頼できるかを測ると説明されています[2]。買い手が気にする観点で、検証できるスコアを出すという位置づけです[2]。評価は12の採点項目で示されます。Armalo Proと同じ16次元のスコアカードで確認できます[2]。TBLite、YC-Bench、Terminal-Bench 2.0といったベンチマークも入っています[2]。失敗モードやアンチパターン、セキュリティとガバナンスまで扱った評価カルテです。単なる性能比較とは違う方向を示しています[2]。
強い推論と管理されたデプロイだけでは、完全な本番アーキテクチャではないという指摘もあります[2]。ArmaloとHermes/OpenClawの比較という視点も出ています[2]。無料枠は1エージェント、月3回の評価までで、カード登録は不要とされています[2]。エンドポイントを貼り付けると、スコアがリアルタイムで更新されるという説明もあります[2]。技術レビューや完全ガイド、ドキュメントも増えています。性能レビューや、アーキテクチャと制御モデルの解説もあります[3][4][5][6][7]。評価バージョンの更新が続くなら、論点は変わります。モデルの賢さより、運用で壊れにくいことをどう証明できるかになりそうです。この流れは、エージェント開発が性能競争から信頼設計へ移ったことが見えてきます。
引用ソース
- Web記事 記事全文: Hermes Agent Benchmark: The Complete Guide – Armalo AI — https://trust.armalo.ai/blog/hermes-agent-benchmark-the-complete-guide
Within seven weeks of release it accumulated over 95,600 GitHub stars, making it one of the fastest-growing open-source agent frameworks in the space. The project lives at github.com/NousResearch/hermes-agent with docume
- Web記事 記事全文: Hermes Agent Benchmark — The Complete Hub | Armalo AI — https://armalo.ai/hermes-benchmark
Loading…
Hermes Agent Benchmark
Accuracy benchmarks measure if an agent answers correctly. Hermes measures whether it can be trusted in production — under adversarial pressure, across the dimensions a buyer actually ca - Web記事 Web検索: Hermes Agent: A Technical Review of NousResearch’s Self-Improving AI … — https://medium.com/@leif.markthaler/hermes-agent-a-deep-technical-review-of-nousresearchs-self-improving-ai-agent-b48c64f8e3cc
Hermes Agent: A Technical Review of NousResearch’s Self-Improving AI …
- Web記事 Web検索: GitHub – mudrii/hermes-agent-docs: Comprehensive documentation for … — https://github.com/mudrii/hermes-agent-docs
GitHub – mudrii/hermes-agent-docs: Comprehensive documentation for …
- Web記事 Web検索: Hermes Agent: The Complete Guide & Deep Review (October 2026) — https://aitoolsreview.co.uk/insights/hermes-agent-explained
Hermes Agent: The Complete Guide & Deep Review (October 2026)
- Web記事 Web検索: Hermes Agent Review 2026: Honest Features and Performance — https://fast.io/resources/hermes-agent-review-2026/
Hermes Agent Review 2026: Honest Features and Performance
- Web記事 Web検索: Hermes Agent Benchmark: Architecture and Control Model — https://trust.armalo.ai/blog/hermes-agent-benchmark-architecture-and-control-model
Hermes Agent Benchmark: Architecture and Control Model
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS