VRAM 8GBのノートPCで35Bモデルが動いた——以前取り上げたこの現象の「なぜ」がわかる解説記事が登場しました[2]。それと前後して、エキスパートをディスクから直接「流す」実装も複数現れています。スマホやノートPCを狙う試みがHacker Newsに投稿されたのも、記憶に新しいところです[1]。今回は、話題の中心にある仕組みと、その周辺の動きを追いました。
まずおさらいです。MoE(専門家の混合)は、トークンごとに一部の「エキスパート」だけを動かすモデル構造です。ローカルで動かす例として挙がるのが、Qwen3-CoderやDeepSeekクラスのモデルです[2]。トークンごとの計算は軽いのに、重みの総量は巨大です。このギャップが、ローカル動作の難しさの正体です[2]。解説記事によると、Qwen3-Coderの30Bモデルは同時に動くのがわずか3Bで、全体の1割程度。ところがllama.cppは、動かないエキスパートもどこかに置いておく必要があります。16GBや24GBのマシンでは、この「置き場所」が最大の壁になります[2]。
現時点で使えるのが、前半の層のエキスパート重みをVRAMではなくシステムRAMに置くオプション(–n-cpu-moe)です[2]。値を大きくするほどVRAMは節約でき、そのぶんトークンごとのCPU処理が増えます。解説記事はこれを「最適化ではなく、速度と余裕を交換するつまみ」と説明しています[2]。attention(文中のどの単語に注目するかを計算する処理)や、そのトークンで実際に動く計算はGPUに残ります。その結果、30BクラスのMoEモデルが16GBのカードでも動くようになった、というわけです[2]。
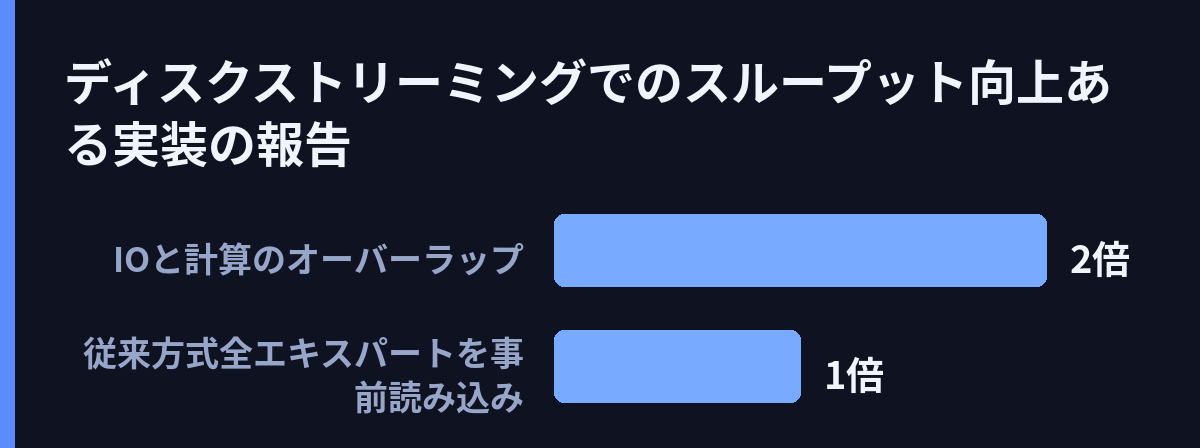
次の段階は「ストリーミング」です。エキスパートを事前にRAMへ読み込まず、必要になった瞬間にディスクから読む方式で、コミュニティの実装を含め少なくとも5つの独立した試みが動いています[2]。この仕組みがうまくできています。ルーター(どのエキスパートを使うか決める部分)の計算は、attentionより先に終わります。この時間差が「先回り読み込みの窓」になります。今の層を計算している間に、次の層で必要なエキスパートをディスクから読み込めるのです[2]。ある実装では、I/Oと計算を重ね合わせることで、スループットが約2倍になったと報告されています[2]。
いっぽう、RAMに置く方式にはメモリ搭載量という足かせもあります。以前取り上げた実測では、RTX 3060を2枚とRAM 256GBを備えたマシンで、DeepSeek V4.1 Flashが約11.1トークン/秒でした。ディスクからのストリーミングが実用になれば、大容量メモリへの依存は減るかもしれません。実装面では、llama.cppの上に動的なエキスパートオフロードを載せた軽量フレームワーク「llama.moe」も公開されています。使い方はllama-serverと同じで、コマンドをzilongに置き換えるだけです。セットアップ手順も公開されており、CUDA(NVIDIA GPUで動かすための基盤)でのビルドが前提です[3]。
周辺の整備も進んでいます。HuggingFaceには、GPUの補助を受けながらMoEをCPUで回す実践ガイドが公開されました[4]。VRAMの少ない環境で大きなローカルモデルを動かす手順をまとめたガイドも現れています[5]。研究寄りでは、HOBBITという論文もあります。混合精度(重みの精度を高い部分と低い部分で使い分ける手法)でエキスパートをオフロードし、MoE推論を高速化する試みです[6]。スマホやノートPCでLLMをローカル動作させる「オンデバイスAI」を、2026年の動向としてまとめた記事も出ています[7]。
しかし、いくつか留保も必要です。層をRAMに置く指定は、OOM(メモリ不足でモデルが読み込めず落ちること)を避けられるぎりぎりの値が正解で、速度への代償はトークン/秒に直接現れます[2]。ストリーミングは、まだllama.cpp本体に取り込まれた機能ではなく、5つの実装がどれも独自路線です[2]。約2倍という数値も、あるプロジェクトの議論からの報告で、詳細な条件はわかりません[2]。Hacker Newsのスマホ向け投稿も、1ポイント・コメント0件のままです。注目はまだこれからのようです[1]。
それでも方向性ははっきりしてきました。MoEの「必要な部分だけ計算する」性質を、VRAM→RAM→ディスクという順番でメモリを使い分ける流れです。これからの勝負は、モデルがVRAMに収まるかではなく、どれだけ速くディスクから流せるかのようです。5つの実装のどれがllama.cpp本体に取り込まれるかが、次の注目点になりそうです。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: llama.cpp's MoE Expert Offload: –n-cpu-moe and Streaming, Explained — https://www.shawnmayzes.com/ai-engineering/llama-cpp-moe-expert-offload-explained/
llama.cpp’s MoE Expert Offload: –n-cpu-moe and Streaming, Explained
– 8 min read
If you’re running a mixture-of-experts model locally – Qwen3-Coder, DeepSeek-class models – the whole appeal is that only a fraction of th - Web記事 記事全文: GitHub – jklincn/llama.moe: Optimized inference of MoE models based on … — https://github.com/jklincn/llama.moe
A lightweight inference framework for Mixture-of-Experts (MoE) models, built on top of llama.cpp with dynamic expert offloading.
sudo apt update
sudo apt install build-essential cmake ccache libcurl4-openssl-dev ninja-bu - Web記事 Web検索: Performant local mixture-of-experts CPU inference with GPU acceleration … — https://huggingface.co/blog/Doctor-Shotgun/llamacpp-moe-offload-guide
Performant local mixture-of-experts CPU inference with GPU acceleration …
- Web記事 Web検索: Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide … — https://aliteq.com/llama-cpp-moe-offloading-run-bigger-models-less-vram
Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide …
- Web記事 Web検索: HOBBIT: A Mixed Precision Expert Offloading System for Fast MoE Inference — https://arxiv.org/html/2411.01433v2
HOBBIT: A Mixed Precision Expert Offloading System for Fast MoE Inference
- Web記事 Web検索: On-Device AI in 2026: Running LLMs Locally on Your Phone, Laptop, and … — https://www.aimagicx.com/blog/on-device-ai-models-local-llm-guide-2026
On-Device AI in 2026: Running LLMs Locally on Your Phone, Laptop, and …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS