考えすぎると賢くなるわけではない、という話が出ました。Hugging Faceに「ConceptCountry/qwen-concept-27b」が公開され、Reddit r/LocalLLaMAでも話題になっています[1]。中国語メディアも「Hugging Face 上线 qwen-concept-27b 概念模型,基于…」と報じました(日本語訳:Hugging Face に qwen-concept-27b 概念モデルが公開、ベースは…)。
このモデルは、AlibabaのQwen3.8-27Bをベースにした実験版です[4]。Qwen3.8-27Bは27Bの密なモデル(パラメータをすべて使う形)で、Apache 2.0で公開され、適切な量子化(重みを圧縮してメモリを節約する仕組み)なら単一のハイエンドGPUで動くことを想定したモデルです[2]。qwen-concept-27bでは、内部の9か所のdown-projection(縮小用の重み)を書き換え、勾配更新や追加の学習データは使わず、モデル自身の活性化(計算の途中で出る信号)から編集内容を導き、9つの重み行列にまとめ直したと説明されています[4]。
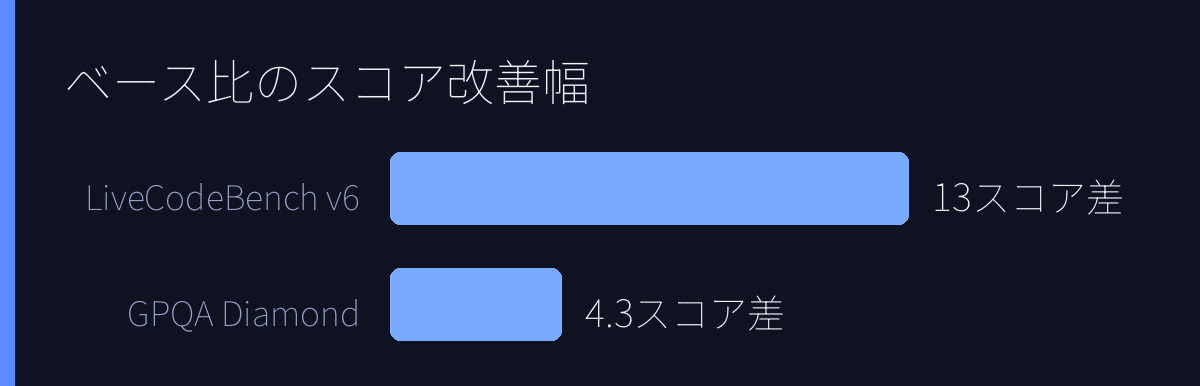
結果として、ベースモデル比でスコアが上がり、思考トークン(内部で使う推論用のトークン)は減ったと報告されています[4]。GPQA Diamond(推論ベンチマーク)は+4.3で推定幅は+1.8から+7.1、LiveCodeBench v6(コーディング課題のベンチマーク)は+13.0、思考トークンは27〜54%減っています[4]。「考える量が減っても、成績は落ちない」という方向性が示された形です[4]。
注目したいのは、編集そのものよりも対照実験です[4]。同じ層で同じ大きさ、方向だけ違うランダム編集を試すと、効果はほぼ出なかったとされています[4]。どのベンチマークでも推定幅が0をまたいでいるようです[4]。つまり「重みをいじったから上がった」ではなく、「特定の方向に動いたから意味が出た」可能性が強調されています[4]。
ローカル利用の観点では、まだ慎重な見方が必要です。現在のところ、qwen-concept-27b自体の必要VRAM(GPUメモリ)やTPS(1秒あたりの生成トークン数)の実測値は公開資料では確認できません。公開されている報告の数値は、bf16(数値形式)の重みをQ8_0で提供した際のものです[4]。Q8_0は重みを8bitに近似する量子化の一種です[4]。ベースのQwen3.8-27Bは単一のハイエンドGPU向けとされていますが、ノートPCやVRAM 8〜16GBのGPUで動くかは判断できません[2]。先月のダウンロードは58件です[4]。
制約もはっきり書かれています。このモデルは「experimental, under evaluation」とされ、まだ評価中です[4]。量子化版は配布の都合によるもので、個別に評価した成果物ではないと説明されています[4]。4bit変換でも効果が保たれるとは主張していません[4]。また、Qwen3.8-27B側の公式ベンチマークも開発元側の報告であり、第三者による評価は限られているとされています[2]。
周辺では、Qwen3.8-27Bのスペックや実行方法の記事も出ており[7]、画像からWeb開発するベンチマークでオープンモデル1位と報じられたり、2026年の注目モデルとしてまとめ記事に載ったりしています[7]。Qwen公式のモデル一覧には2.4Tモデルや関連論文が並びます[5]。検索結果やニュースサイトにも名前が見えます[6]。Xのトレンドでは「Soranji」も上がっていましたが、今回の話題との関係は公開資料からは確認できません[3]。

qwen-concept-27bの面白さは、27Bを大きくするのではなく、重みの「方向」を直すことで効率を上げられるかもしれない点です[4]。ただ、実運用には第三者評価と量子化ごとの再確認が要ります[4]。ローカルで試すなら、まず実験版として扱い、自分の環境での速度と品質を確かめるのが安全と考えられます[4]。
引用ソース
- Reddit Reddit r/LocalLLaMA: ConceptCountry/qwen-concept-27b · Hugging Face — https://www.reddit.com/r/LocalLLaMA/comments/1xrxwg1/conceptcountryqwenconcept27b_hugging_face/
ConceptCountry/qwen-concept-27b · Hugging Face
- Web記事 記事全文: Qwen3.8-27B: Benchmarks, Features & Performance — https://www.five.reviews/ai-tools/qwen3-8-27b-benchmarks-features-performance/
Qwen3.8-27B represents a significant shift in what open-weight AI can deliver at local scale. Released by Alibaba’s Qwen team on August 14, 2026, this 27-billion-parameter dense model ships under Apache 2.0 with native m
- X Xトレンド: Soranji — https://trends24.in/japan/
Soranji
- Web記事 記事全文: ConceptCountry/qwen-concept-27b · Hugging Face — https://huggingface.co/ConceptCountry/qwen-concept-27b
Qwen3.8-27B with nine down-projections rewritten by weight-space programming. No gradient steps, no training data: the edit is derived from the model’s own activations and compiled into nine weight matrices.
The model th - Web記事 記事全文: Qwen (Qwen) – Models – Hugging Face — https://huggingface.co/Qwen/models
Text Generation • 2.4T • Updated • 9.46k • 267
AI & ML interests
None defined yet.
Recent Activity
Papers
SpecOPD: Branch-Parallel On-Policy Distillation for Speculative Decoding
Co-Design Bench: Multimodal Colla - Web記事 記事全文: ConceptCountry/qwen-concept-27b · Hugging Face – foorilla.com — https://foorilla.com/media/items/conceptcountryqwen-concept-27b-hugging-face-681069/
…
…
Legend
Display
[N] = Source has items published within the past 30 days
Filters / settings
[QI] = Item search
[QS] = Source search
[T] = Timespan
[CR:…km] = City radius in kilometres
[O] = Order by - Web記事 Web検索: 10 Hugging Face Models Worth Knowing in 2026 – KDnuggets — https://www.kdnuggets.com/10-hugging-face-models-worth-knowing-in-2026
10 Hugging Face Models Worth Knowing in 2026 – KDnuggets
- Web記事 Web検索: Qwen3.8 27B: Benchmarks, Specs, and How to Run It (2026) — https://unifically.com/blogs/qwen-3.8-27b
Qwen3.8 27B: Benchmarks, Specs, and How to Run It (2026)
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。



RECENT COMMENTS