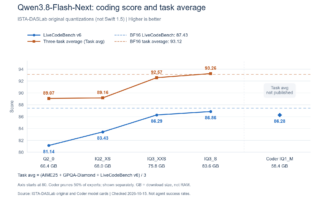
Qwen3.8-27Bの重み9か所を書き換えた実験モデルです。GPQA Diamondで+4.3、LiveCodeBench v6で+13.0、思考トークンは27〜54%減ったと報告されています。対照実験と量子化の限界が要点です。
Qwen3.8-27Bの重み9か所を書き換えた実験モデルです。GPQA Diamondで+4.3、LiveCodeBench v6で+13.0、思考トークンは27〜54%減ったと報告されています。対照実験と量子化の限界が要点です。
AlibabaのAIモデルQwen4は、7B〜72BのオープンウェイトとMaxの二本立てが漏れたとされます。匿名モデルや推論設定の公開準備も進み、ローカルでは小さいモデルが候補です。量子化やVRAMの情報は未確認です。
AlibabaのQwen4を巡り、仮名モデルQoduckやFlash-Earlyの試行が相次いでいます。推論設定や100万トークン対応は確認されましたが、ローカル実行の可否はまだ見えていません。ハッカー的な仮名運用が、実運用の判断を難しくしています。
StrataでQwenの小型から大型まで試した結果、VRAMを超える構成でprefillとdecodeが伸びる分岐点が示されました。RTX 3060では35B以上のMoEで最大約2倍、RTX 5060 Tiでは軽い量子化が65.55トークン/秒です。
Qwen4-Max の公式スペックは未発表ですが、Qwen Code の PR で qwen4 ID が確認されました。Flash-Next の推論設定や 100 万トークンが先行し、公開の気配があります。ローカル実行は 27B 向けに準備がうかがえますが、実測値は未確認です。
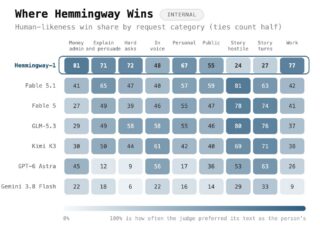
Hemmingway-1.5はQwen 27Bの文章特化モデルで、AI検知器を90%通過するとされています。人間は86%、前世代は7%で、書き味と検知回避が焦点です。ローカル実行や独自ベンチの注意点もわかります。
AIモデルQwenの重みの中に仮想マシンを置く実験がDoom動作に発展しました。Qwen-7Bの2048トークンからQwen4の100万トークンへ、文脈長の伸びと実用課題が浮かびます。重み計算と長文推論の両面で、次の展開に注目が集まります。今後の追跡も必要です。
aiの話題として、Qwenの重みに32bit RISC-V CPUを埋めたQwenputerが注目されています。算術ベンチの正答率は48.6%から100%に上がり、推論の内部実行が報告されました。教育用実装やベンチ資料も並んでいます。
Qwen 3.8 Flash Next(125B MoE)を8GBのGPUで動かす検証が相次いで報告されています。全体の約3割を占めるn-gram参照テーブルをシステムRAMに置く構成で、decode毎秒30〜36トークンを達成。量子化やMTPなど速度と品質のトレードオフも実測で見えてきました。
AlibabaがQwen 4に先駆けて公開したQwen3.8-Flash-Nextをめぐり、ARC-AGI-3コンペの勝利予報と冗談めいた「データ送信」投稿が同時に話題です。プレビューはMoE+n-gramメモリテーブル設計で、ローカルの目安は現行27BのBF16約54GB〜4ビット16GBです。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS