📌 エグゼクティブサマリー
Qwen3.8 27Bは、agenticな推論で伸びましたが、広い知識では frontier と差が出ます。2x P100で約60tps、Cerebrasで1500tok/sの報告があります。aiのローカル利用では、量子化と推論設定の読み分けが分かれ目です。
60tps。その数字がhackerで目立ちました。2枚のTesla P100で、Qwen 3.8 27Bをq6_k量子化して動かした報告です [1]。投稿はllama.cpp関連のリンク付きでした [1]。2枚の古いGPUでも、量子化とエンジン次第で動く点が面白いところです [1]。OSはLinux Mint、PCはDellだったそうです 。hackerでは、どのシステムで動かしたのかという質問も出ていました [3]。aiの話題では、速さと環境の両方が気になるようです。
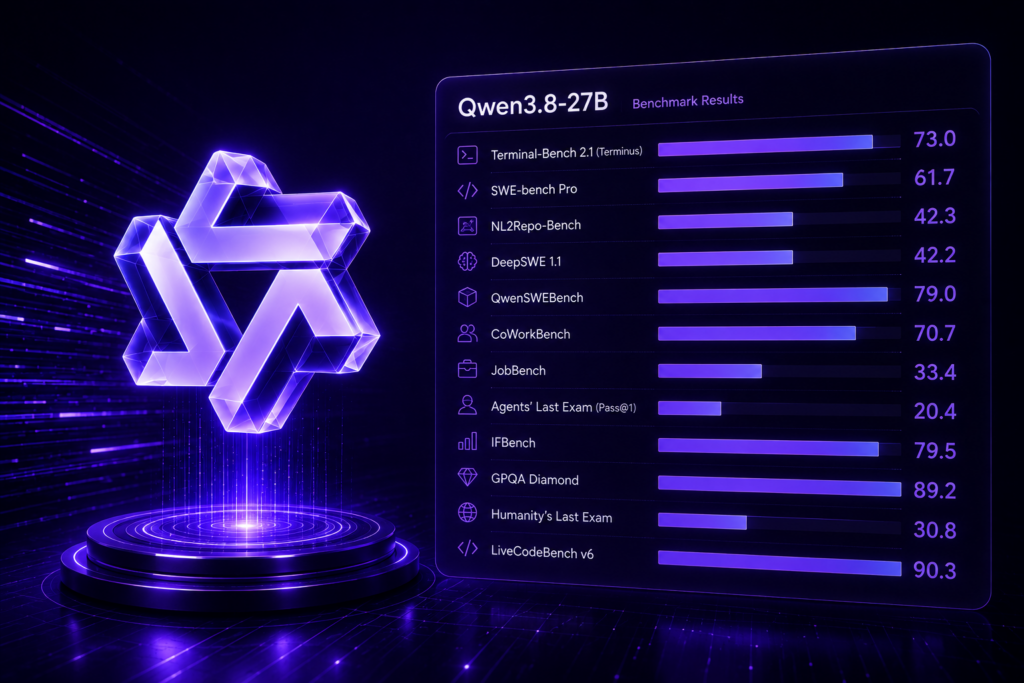
Qwen3.8 27Bは、agenticな推論で強い半面、広い知識では frontier に届きません [2]。公式表では、SWE-bench Proが61.7、Artificial Analysisの知能指数が52でした [2]。前の27Bと比べ、DeepSWE 1.1は13.3から42.2へ、QwenSWEBenchは49.3から79.0へ上がりました [2]。closed-weightのQwen3.7-Plusより、agenticとcodingの行で勝つ一方、Humanity’s Last ExamとGPQA Diamondでは負けます [2]。パラメータをツール使用に上手に変換し、広い知識にはあまり変換していません [2]。この形は、世代を超えて繰り返されています [2]。
視覚言語でも差が出ました。OSWorld-Verifiedは63.9から84.3へ、WebArena-Verifiedは48.8から64.8へ伸びました [2]。browser automationでも、同じ方向の変化です [2]。同じパラメータ数で、この幅は大きいです。computer-useは、open multimodalで弱い部分でした [2]。ここが一段階上がったのは、実務に効く変化です。ただし、いくつかの数値はQwen内部評価です。比較のセットが揃っていない行もあると書かれています [2]。
VentureBeatの指摘も重要です。公式表では、Claude Opus 4.6 MaxにSWE-bench ProとLiveCodeBenchで勝つ行があります [2]。一方、Terminal-Bench、GPQA Diamond、Humanity’s Last ExamではOpusが前に出ます [2]。ベンチマークのカルテを見ると、強みと弱みがはっきりします。速いから万能、という話にはなりません。どの行を見るかで、評価は変わります。内部評価と独立評価を混ぜると、誤解が生まれます [2]。
独立評価では、推論の設定を分けて測るバージョンの動きが注目されました [2]。Artificial Analysisは、各reasoning settingを別entryとして評価しました [2]。BenchLMは2026年10月の速度表を出し、Qubridは公式と独立評価を分けています [6]。どの推論モードで測ったかが、結果を大きく変えます。flashのような速さを語るときも、設定を分けて読む必要があります。速度表と知能指数は、同じ物差しではありません [6]。
ローカル実行では、量子化の落とし穴が残ります。BF16は55GB、Q4_K_Mは17GBで、Terminal-Bench 2.1ではフルモデルに並んだそうです [4]。1bitではGPQA Diamondがほぼランダムになり、長い推論で悪化しました [4]。F16のKVキャッシュは、32kトークンで約2.3GBです [4]。Unslothの量子化は、2・4・8bitがv2、1bitがv3です [4]。前のQwen3.6 27Bでは、12GBでSVGのペリカン生成が良く、16GBまで知識を保ったそうです [4]。KVキャッシュをF16にすると、コンテキストが長くなるほど重くなります [4]。
この検証には、Modal GPUで約3000ドルかかったと書かれています [4]。llama.cppは8月16日のビルドが必要でした [4]。検索結果にも同じ記事のタイトルが並び、4bitが持ちこたえ1bitが崩れるという見出しが目立ちます 。Redditでは、量子化すると賢くなくなるという不満も出ています [4]。ただし、KL divergenceやtop-1だけでは、タスクの劣化は測れません [4]。あるトークンの違いが、論理の崩れになることもあります [4]。ベンチマークの選び方で、結論が変わります [4]。
速度の話も増えました。Cerebrasでは1500 tok/sの報告がありますが、記事は「まず読むべき」と注意を呼びます [5]。Tesla V100 32GBでは131kコンテキストで動く実測も出ました [5]。P100では、オフロードを前提にしないと厳しいようです [6]。速さの数字は、環境と条件を分けて読む必要があります。GPUの世代やVRAMで、できることが変わります。Cerebrasの速さは、ローカルP100の60tpsとは、別の話です [1][5]。
結局、Qwen3.8 27Bは、ツールを使う推論に強いモデルです。hackerではflashのような速さが語られましたが、実務では推論設定と量子化の選び方が分かれ目になります [2][4]。aiのローカル利用は、数字の速さより、用途と環境の相性で決まりそうです。ベンチマークのカルテを、自分のタスクに置き換えて読むのが良さそうです。hackerの数字と、公式の数字を、同じ目線で比べない方が良さそうです [1][2]。
引用ソース
- [1] Hacker News Hacker News: 2x Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps — https://github.com/Kmic-68/llama.cpp
2x Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps
- [2] Web記事 記事全文: Qwen3.8-27B Benchmarks: Official and Independent Results — https://qubrid.com/blog/qwen38-27b-benchmarks-official-and-independent-results
Qwen3.8-27B scores 52 on the Artificial Analysis Intelligence Index at maximum reasoning effort and 61.7 on SWE-bench Pro per Qwen’s own evaluation. It leads its comparison set on agentic coding and computer-use benchmar
- [3] HNコメント HNコメント: Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps — https://news.ycombinator.com/item?id=50146283
Interesting. What system were running the cards on?
- [4] Web記事 記事全文: Benchmarking Qwen3.8 27B quantizations: 4-bit holds up, 1-bit collapses — https://quesma.com/blog/qwen38-27b-quantizations-benchmarked/
How much GPU RAM do you actually need to run Qwen3.8 27B without sacrificing quality?
The full BF16 model weighs 55 GB, putting it beyond most consumer hardware.
Yet the 17 GB Q4_K_M matches the full model on a popular a - [5] Web記事 Web検索: Cerebras Qwen 3.8 27B: 1,500 tok/s, But Read This First – explainx.ai — https://www.explainx.ai/blog/cerebras-qwen3-8-27b-1500-tokens-per-second-2026
Cerebras Qwen 3.8 27B: 1,500 tok/s, But Read This First – explainx.ai
- [6] Web記事 Web検索: Qwen3.8-27B Benchmarks & Speed (October 2026) | BenchLM.ai — https://benchlm.ai/models/qwen3-8-27b
Qwen3.8-27B Benchmarks & Speed (October 2026) | BenchLM.ai
- [7] Web記事 Web検索: Tesla V100 32GB Runs Qwen3.8-27B: 131k Context, Measured — https://miyagadget.page/en/blog/2026/09/04/tesla-v100-32gb-qwen38-27b-benchmark-en/
Tesla V100 32GB Runs Qwen3.8-27B: 131k Context, Measured
- [8] Web記事 Web検索: Qwen 3.5 27B on Tesla P100 16GB? ONLY WITH HEAVY OFFLOAD — https://willitrunai.com/can-run/qwen-3.5-27b-on-tesla-p100-16gb
Qwen 3.5 27B on Tesla P100 16GB? ONLY WITH HEAVY OFFLOAD
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS