「60tps」という数字が、hackerで目立ちました。Tesla P100を2枚使い、Qwen3.8 27Bを6bit系の量子化で動かした報告です [1]。量子化は、重みを圧縮してメモリを節約する仕組みです。投稿にはllama.cpp関連のリンクが添えられていました [1]。古いGPU 2枚でも、量子化とエンジン次第で動く点が面白いところです [1]。環境はLinux Mint、PCはDellだったそうです。どのシステムで動かしたのか、という質問も出ていました [3]。
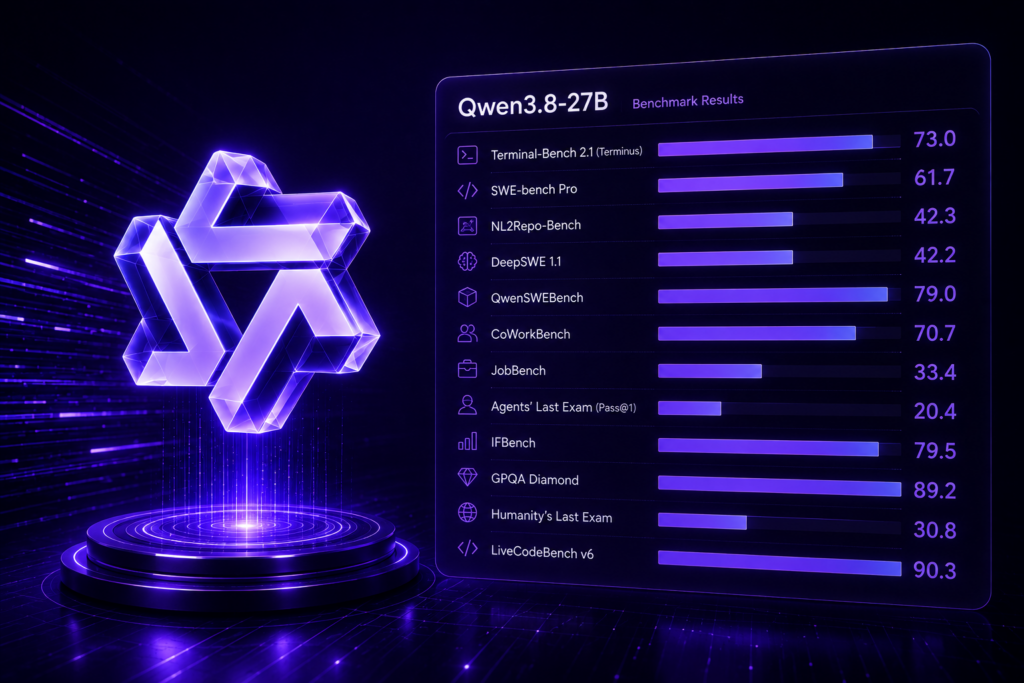
Qwen3.8 27Bは、agenticな推論で強くなりました。ツールを使いながら課題を進める推論です。一方、広い知識では、最上位クラスのモデル(frontier)に届きません [2]。公式表では、コーディング試験のSWE-bench Proが61.7、Artificial Analysisの知能指数が52です [2]。前の27Bと比べ、DeepSWE 1.1は13.3から42.2へ、QwenSWEBenchは49.3から79.0へ上がりました [2]。重みを公開していないQwen3.7-Plusとは、agenticとコーディングの行で勝ちます。広い知識を問うHumanity’s Last ExamとGPQA Diamondでは負けます [2]。パラメータはツール使用に上手く変換され、広い知識にはあまり変換されていません [2]。この形は、世代を超えて繰り返されています [2]。
視覚言語でも差が出ました。OSWorld-Verifiedは63.9から84.3へ、WebArena-Verifiedは48.8から64.8へ伸びています [2]。ブラウザ操作の自動化でも、同じ方向の変化です [2]。同じパラメータ数で、この幅は大きいです。公開モデルでは、PC操作(computer-use)が弱い部分でした [2]。ここが一段階上がったのは、実務に効く変化です。ただし、いくつかの数値はQwen内部評価です。比較のセットが揃っていない行もあると書かれています [2]。
VentureBeatの指摘も重要です。公式表では、Claude Opus 4.6 MaxにSWE-bench ProとLiveCodeBenchで勝つ行があります [2]。一方、Terminal-Bench、GPQA Diamond、Humanity’s Last ExamではOpusが前に出ます [2]。ベンチマークのカルテを見ると、強みと弱みがはっきりします。速いから万能、という話にはなりません。内部評価と独立評価を混ぜると、誤解が生まれます [2]。独立評価では、推論の設定を分けて測る動きが注目されました [2]。Artificial Analysisは、推論設定ごとに別の項目として評価しました [2]。BenchLMは2026年10月の速度表を出し、Qubridは公式と独立評価を分けています [6]。どの推論モードで測ったかが、結果を大きく変えます。速度表と知能指数は、同じ物差しではありません [6]。
ローカル実行では、量子化の落とし穴が残ります。圧縮しないBF16では55GBです。4bit系に圧縮するQ4_K_Mでは17GBになりました。それでもTerminal-Bench 2.1では、フルモデルに並んだそうです [4]。1bitにすると、GPQA Diamondがほぼランダムになり、長い推論で悪化しました [4]。KVキャッシュは、会話の履歴を保持して再計算を減らす仕組みです。これを16bit精度のままにすると、32kトークンで約2.3GBです [4]。コンテキストが長くなるほど、重くなります [4]。Unslothの量子化は、2・4・8bitがv2、1bitがv3です [4]。前のQwen3.6 27Bでは、12GBでSVGのペリカン生成が良く、16GBまで知識を保ったそうです [4]。
この検証には、Modal GPUで約3000ドルかかったと書かれています [4]。llama.cppは8月16日のビルドが必要でした [4]。検索結果には「4bitが持ちこたえ、1bitが崩れる」という見出しが並びます。Redditでは、量子化すると賢くなくなるという不満も出ています [4]。KLダイバージェンス(出力のずれを測る指標)やtop-1(1位の一致率)。この種の指標だけでは、タスクの劣化は測れません [4]。あるトークンの違いが、論理の崩れになることもあります [4]。ベンチマークの選び方で、結論が変わります [4]。
速度の話も増えました。Cerebrasでは1500 tok/sの報告がありますが、記事は「まず読むべき」と注意を呼びます [5]。Tesla V100 32GBでは、131kコンテキストで動く実測も出ました [5]。P100では、モデルの一部をCPUに逃がすオフロードを前提にしないと厳しいようです [6]。速さの数字は、環境と条件を分けて読む必要があります。GPUの世代やVRAMで、できることが変わります。Cerebrasの速さと、ローカルP100の60tpsは、別の話です [1][5]。
結局、Qwen3.8 27Bは、ツールを使う推論に強いモデルです。hackerではflashのような速さも語られましたが、実務では推論設定と量子化の選び方が分かれ目になります [2][4]。ローカル利用は、数字の速さより、用途と環境の相性で決まりそうです。ベンチマークのカルテを、自分のタスクに置き換えて読むのが良さそうです。hackerの数字と公式の数字を、同じ目線で比べない方が良いでしょう [1][2]。
引用ソース
- Hacker News Hacker News: 2x Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps — https://github.com/Kmic-68/llama.cpp
2x Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps
- Web記事 記事全文: Qwen3.8-27B Benchmarks: Official and Independent Results — https://qubrid.com/blog/qwen38-27b-benchmarks-official-and-independent-results
Qwen3.8-27B scores 52 on the Artificial Analysis Intelligence Index at maximum reasoning effort and 61.7 on SWE-bench Pro per Qwen’s own evaluation. It leads its comparison set on agentic coding and computer-use benchmar
- HNコメント HNコメント: Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps — https://news.ycombinator.com/item?id=50146283
Interesting. What system were running the cards on?
- Web記事 記事全文: Benchmarking Qwen3.8 27B quantizations: 4-bit holds up, 1-bit collapses — https://quesma.com/blog/qwen38-27b-quantizations-benchmarked/
How much GPU RAM do you actually need to run Qwen3.8 27B without sacrificing quality?
The full BF16 model weighs 55 GB, putting it beyond most consumer hardware.
Yet the 17 GB Q4_K_M matches the full model on a popular a - Web記事 Web検索: Cerebras Qwen 3.8 27B: 1,500 tok/s, But Read This First – explainx.ai — https://www.explainx.ai/blog/cerebras-qwen3-8-27b-1500-tokens-per-second-2026
Cerebras Qwen 3.8 27B: 1,500 tok/s, But Read This First – explainx.ai
- Web記事 Web検索: Qwen3.8-27B Benchmarks & Speed (October 2026) | BenchLM.ai — https://benchlm.ai/models/qwen3-8-27b
Qwen3.8-27B Benchmarks & Speed (October 2026) | BenchLM.ai
- Web記事 Web検索: Tesla V100 32GB Runs Qwen3.8-27B: 131k Context, Measured — https://miyagadget.page/en/blog/2026/09/04/tesla-v100-32gb-qwen38-27b-benchmark-en/
Tesla V100 32GB Runs Qwen3.8-27B: 131k Context, Measured
- Web記事 Web検索: Qwen 3.5 27B on Tesla P100 16GB? ONLY WITH HEAVY OFFLOAD — https://willitrunai.com/can-run/qwen-3.5-27b-on-tesla-p100-16gb
Qwen 3.5 27B on Tesla P100 16GB? ONLY WITH HEAVY OFFLOAD
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。



RECENT COMMENTS