AlibabaのQwen4を巡り、1.2T MoEやSWE-bench 78.6%といった漏洩情報が広がっています。hacker界隈で注目される評価ですが、ローカル実行に必要な量子化版や実測TPSは未確定です。
AlibabaのQwen4を巡り、1.2T MoEやSWE-bench 78.6%といった漏洩情報が広がっています。hacker界隈で注目される評価ですが、ローカル実行に必要な量子化版や実測TPSは未確定です。
UnslothがQwen3.8-Flash-NextのGGUFをV3.1に更新し、15%高い精度をうたう。26.2Bトークンのベンチやengram容量、ローカル実行のRAM目安が話題です。XトレンドではChatGPTImages2.6やAI暴走も上がります。
Intelligence Index v5は60%を非公開評価にし、open-weightとの差を12点に広げました。Intel関連のAIベンチマーク記事も話題ですが、素材に具体的な比較数値はありません。更新と検証可能性の課題がわかります。
llama.cppの高速化フォークik_llama.cpp関連の動きが相次いでいます。MoE最適化を進めるフォークは6GBのRTX 2060で生成45〜48トークン/秒、28Kコンテキストでも37トークン/秒を報告。フォークが先行した機能や利用上の注意点、本体統合を見送る理由まで整理します。
Recursiveが初のモデルFlintを公開。40BのMoEで1トークンあたり2.5Bだけ動かし、50B未満のMoEとしてコーディング系ベンチマークで上位になりました。M4 Proで125トークン/秒超の推論が可能な一方、denseの強豪には及ばない数値も見えます。
MacBookで毎秒125トークンの推論が話題のFlint 40Bの続報です。トークンごとに2.5Bだけ計算するMoE構造という速さの仕組みと、自動研究システムが4カ月未満で開発した実像を整理します。4ビット量子化でも16ビットと0.7ポイント以内の差に収めた点も要点です。
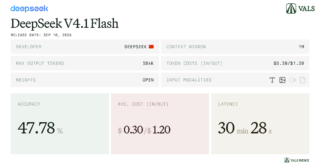
Vals AIの多段サイバー攻撃タスクで、DeepSeek V4.1 Flash 1017がGPT 6 Solを上回りました。総合スコア57.86%で公開モデル1位、1テスト0.30ドルと安く速い点も目立ちます。ただし単発タスクの結果であり、最初の返答までの遅さには注意が必要です。
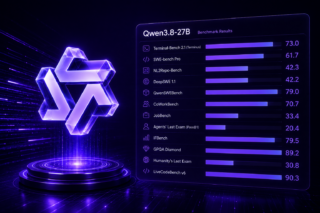
Qwen3.8 27Bはツールを使う推論に強く、広い知識では最上位モデルに届きません。ローカルでは2枚のP100で約60tps、Cerebrasでは1500 tok/sの報告があります。量子化と推論設定の読み分けが、ローカル利用の分かれ目です。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS