24GBのGPUが1枚あれば、クラウド最上位モデルと同じ正答率が出る――そんな実測報告が相次ぎ、話題になっています。以前取り上げたRTX 3090のGPUアンロック実測では、BF16テンソル演算が82から155 TFLOPSに向上していました。今回はその後の展開です。新しい27Bモデル「Qwen3.8 27B」をこの1枚で動かし、品質と速度を確かめた報告が複数公開されています[2][3]。
まず品質から見ていきます。Redditのある投稿者は、韓国語のPDFを対象にRAGをローカルで運用してきました。RAGとは、検索で集めた資料をもとに回答させる仕組みです。これまでの評価は「答えを見た感じOK」という主観だけでした。そこで正答と出典ページが既知の韓国語RAGベンチマーク(300問・64 PDF)を導入し、全モデルに同じ上位5ページと同じプロンプトを渡して測り直したといいます[1]。
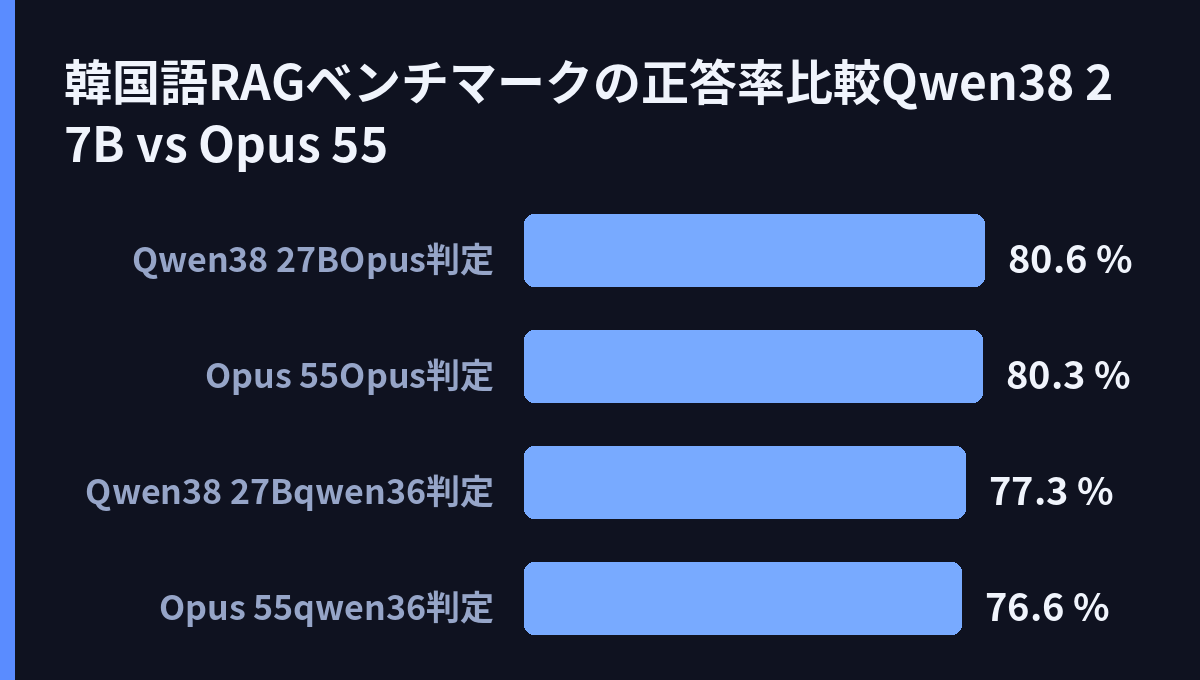
結果は接戦でした。思考モード(回答前に推論ステップを展開する機能)をオンにしたQwen3.8 27Bは77.3%。クラウドのOpus 5.5は76.6%です。対応のある2つの正答率を比べるMcNemar検定ではp=0.82で、統計的には引き分けでした。判定役が同じQwen系だと甘くなる可能性を疑い、Opus 5.5に判定し直させても80.6%対80.3%。やはり同じ結論です[1]。
速度はどうでしょうか。RTX 3090が1枚だけの環境で、Qwen3.8 27Bと前世代のQwen 3.6 27Bを同じ量子化ファイルで比較した記事があります。測定順をA-B-B-Aで入れ替え、熱や経時変化が比較に紛れ込まないよう工夫しました。8月14日時点では他に3090での27B実測が見つからなかったほど、まだ新しいファイルです[2]。使用したのはRTX 3090 24GBにCore i7-8086K、RAM 64GBという構成です[2]。結果として生成速度はほぼ同じで、目立った違いはVRAM使用量の254MiBだったといいます。記事は当初ここまででしたが、読者の要望に応えてHumanEval(コード生成の定番ベンチマーク)の計測も後日追加しています[2]。
より徹底した測定もあります。GitHubで公開されたのは、1枚のカードで14時間かけたベンチマークです。4ビット量子化(重みを圧縮してメモリを節約する仕組み)で動かし、答えが検証できる問題だけを測りました。正解は事前に参照実装で計算しておき、モデルの回答と照合します。間違えた過程も報告書に残す徹底ぶりです[3]。このモデルはSSM(時系列情報を圧縮しながら記憶する仕組み)とアテンションを組み合わせた構造です。27Bを24GBに収めたまま、131072トークンのコンテキストで動作しています。電力制限を段階的に変える測定も含めています[3]。
ただ、つまずきの記録も役に立ちます。同じ測定では、Ampere世代(3090の世代)のカードで画像入力が毎回クラッシュする問題が見つかりました。環境変数で演算精度をfp32(単精度浮動小数点)に固定すると解消し、性能への影響は測った範囲でゼロだったといいます。ただし文書化されていない挙動です[3]。また、Redditの検証では思考モードをオフにすると正答率が約6ポイント下がりました。設定次第で実力が変わることも示しています[1]。
さらに意外だったのは、Opus 5.5の誤答の内訳です。全体70ミスのうち、テキスト層のないスキャン画像が原因は22、検索が正しいページを取れなかったのは23。モデル自体の失敗は25だけでした。投稿者は「もうモデルではなく、こちらのPDF解析がボトルネックだ」とまとめています[1]。
周辺でも検証が広がっています。24GBで32BクラスのQ4量子化が動くという整理[5]や、24GBに何が収まるかをまとめたガイド[5]、実測の設定・速度・消費電力を扱う記事[5]、コーディング環境OpenCodeでのセットアップとベンチマークの記録[5]、コンテキスト拡張や対応モデルを整理したベンチマーク記事[4]も公開されました。[5]は3090を中古で選ぶ24GBカードの筆頭に挙げます。2020年発売のカードに27Bが載り、クラウド最上位と張り合える場面が出てきました。いま残る課題はモデルの外側、資料の前処理と検索にあるようです。1枚の古いカードでここまで来た事実は、ローカル推論の現在地をよく示しています。
引用ソース
- Reddit Reddit r/LocalLLaMA: qwen3.8 27B on my 3090 basically tied Opus 5.5 on a Korean RAG benchmark, which I did not expect — https://www.reddit.com/r/LocalLLaMA/comments/1xe4v74/qwen38_27b_on_my_3090_basically_tied_opus_55_on_a/
qwen3.8 27B on my 3090 basically tied Opus 5.5 on a Korean RAG benchmark, which I did not expect
- Web記事 記事全文: Qwen 3.8 27B vs 3.6 on RTX 3090: Speed and Quality Tested — https://insiderllm.com/guides/qwen-3-8-27b-vs-3-6-27b-rtx-3090/
📚 More on this topic: DFlash vs MTP on RTX 3090 · Qwen 3.6 27B with MTP: 60 tok/s · Qwen 3.6 Complete Guide · Best Qwen Models Ranked · The 35B MoE on a 3090
The Qwen3.8-27B weights went up on Hugging Face on August 5, t - Web記事 記事全文: GitHub – jonidimo/qwen38-3090-benchmark: Qwen3.8-27B on One RTX 3090: … — https://github.com/jonidimo/qwen38-3090-benchmark
14 hours of measurements on a single consumer card. Every answer was computed by a reference implementation before the model was asked. Every wrong turn is kept in section 13 rather than quietly edited out.
If Qwen3.8-27 - Web記事 Web検索: RTX 3090 Local LLM Benchmarks, Context Scaling & Supported Models 2026 … — https://www.hardware-corner.net/gpu-llm-benchmarks/rtx-3090/
RTX 3090 Local LLM Benchmarks, Context Scaling & Supported Models 2026 …
- Web記事 Web検索: RTX 3090 and Local LLMs: What Fits in 24GB VRAM, from Model Size to … — https://www.hardware-corner.net/guides/rtx-3090-local-llms-24gb-vram/
RTX 3090 and Local LLMs: What Fits in 24GB VRAM, from Model Size to …
- Web記事 Web検索: Qwen3.8-27B on a 24 GB RTX 3090: measured settings, speeds and energy — https://chinkeong.github.io/qwen-27b/
Qwen3.8-27B on a 24 GB RTX 3090: measured settings, speeds and energy
- Web記事 Web検索: RTX 3090 24GB for Local LLMs: Runs 32B Q4, Best Used 24GB Card — https://modelfit.io/gpu/rtx-3090/
RTX 3090 24GB for Local LLMs: Runs 32B Q4, Best Used 24GB Card
- Web記事 Web検索: Qwen3.8-27B on RTX 3090: OpenCode Setup & Benchmarks | DevLog — https://zjshen14.github.io/en/blog/local-qwen-opencode-3090/
Qwen3.8-27B on RTX 3090: OpenCode Setup & Benchmarks | DevLog
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS