Claude Opus 5.5がProgramBenchで18.5%を解きました。AnthropicのベンチではTerminal-Bench 4.0で66.4%を記録し、推論やエージェント性能も伸びています。aiニュースとして、速度・価格・比較の要点をまとめます。
Claude Opus 5.5がProgramBenchで18.5%を解きました。AnthropicのベンチではTerminal-Bench 4.0で66.4%を記録し、推論やエージェント性能も伸びています。aiニュースとして、速度・価格・比較の要点をまとめます。
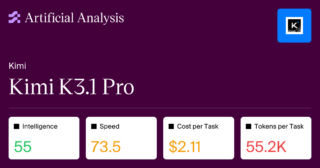
Moonshot AIのKimi K3.1 Proは、独立評価のIntelligence Indexで55の4位。Opus 5.5に3ポイント及ばず、入力2ドル/出力10ドルの価格が武器です。一方ローカル実行派からは「DeepSeek 4.1 Flashで十分」との声もあり、11月4日のオープンウェイト公開が注目されます。
RTX 3090でのQwen3.8 27B実測が相次いでいます。韓国語RAGベンチマークでは77.3%対76.6%でクラウド最上位のOpus 5.5と引き分け、生成速度は前世代とほぼ同等でした。誤答の多くはPDF解析や検索に由来し、ボトルネックはモデルの外側にあることが見えてきます。
ローカルAIの潮流が具体化しています。4Bの小型モデルが12回のツール呼び出しでBlender操作やRustコード解析をこなし、macOS 27に端末内オフラインLLMが組み込まれる報告も。一方でHugging Faceからのモデル消失や安全性への問いも残り、基盤の未成熟さが見えてきます。
オープンウェイトモデルKimi K3がClaudeに迫っています。14のベンチマークはFable 5が8勝、K3が6勝の接戦で、コーディングの公開スコアはOpus 5が70.8対58.9と優位です。K3は単価約3分の1で攻め、Claude側はキャッシュ価格を75%下げて対抗しました。
Claude公式ドキュメントが更新され、標準はOpus 5.5、難しい推論や長時間のエージェント作業はFable 5.1という使い分け指針が示されました。モデル能力や系列をAPIで取得でき、推論のON/OFF制御も細分化されています。比較記事は増えたものの、素材に具体的な数値はありませんでした。
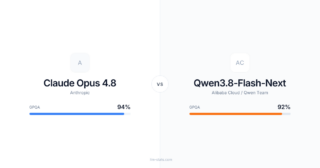
ローカルで動くモデルは、最上位のAPIモデルにどこまで迫れるのか。Redditのr/LocalLLaMAに投稿された検証が、その一つの答えです[1]。同じコーディングタスクを両者に解かせています。費用は0.32ドル対17.78ドル。約55倍の差です。それでいて完成度は69%対87%。この数字を順に読 […]

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS