763Bの巨大モデルを12GBのGPU1枚で動かす――先日話題になったDeepSeek-V4.1-Flash-1017の量子化版です。その「なぜ動くのか」を支える技術の中身が、開発元の説明でくっきり見えてきました[1][2]。公開したのはオーストリアの研究チームISTA-DASLab。量子化(重みを圧縮してメモリを節約する仕組み)ツールGPTQを生み出し、その手法は今や業界の標準になっています[3]。前回は公開の概要をお伝えしたので、今回は圧縮の中身に踏み込みます。

対象モデルは、1層に384個のエキスパート(専門に特化した小さなネットワーク)を持ち、1トークンあたり6個だけを稼働させるMoEです。全体で763.2Bのパラメータを持ち、コンテキストは100万トークンに及びます[1]。元の重み自体がFP8・FP4という軽い形式で公開されています[1]。そこからさらに圧縮を進めたのが、今回のGGUF(ローカル推論で広く使われる重みファイル形式)です[2]。
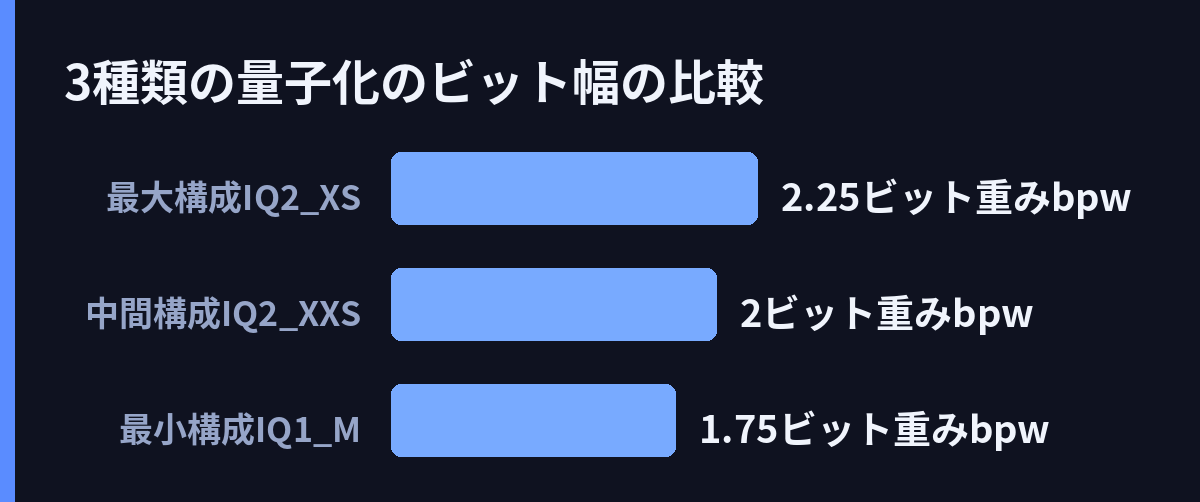
公開されたのは3種類の量子化で、重み1つあたりのビット数(bpw)は1.75、2.00、2.25です[1]。一番小さい構成はIQ1_Mという型で、重み1つが2ビット未満という攻めた圧縮です。3構成のバックボーン部分は120.7〜155.2GBに収まり、4分割のファイルで提供されます[1][2]。bpwの数値は、本体の551.9Bパラメータに対する平均値です[2]。出来上がるファイルは標準的なGGUFなので、対応する実行環境でそのまま使えます[2]。
圧縮の中核は2つの手法です。まずGSQ(Gumbel-Softmax Quantization)は、各重みをどの値に丸めるかを最適化の対象として扱います。「どの丸め先にするか」という離散的な選択を、Gumbel-Softmaxという確率的な手法で最適化できる形に変えます。そして較正データ(調整に使う少量のサンプル)から学習して、丸め方を決めます。近い値に置き換えるだけの普通の丸めより、精度が出やすい方法です[3]。しかも結果はGGUF実行環境がそのまま読める形式なので、互換性も保たれます。
もうひとつのRCOは、各テンソル(重みのひとかたまり)にどの精度を割り当てるかを決める手法です。サイズの予算内で、割り当ての組み合わせを探索します[2][3]。均一な量子化では全テンソルに同じ型を適用しますが、今回はテンソルごとに別の型を割り当てる「非均一」な構成です[2]。割り当ては、テンソルごとの感度(精度を落としたときの傷み具合)に応じて決まります[2]。パラメータの大半をエキスパートが占めるため、探索の自由度も主にエキスパート側に注がれます。ただしGGUFの制約で、設定は層単位まで。エキスパート1個ずつには指定できません[2]。
この配分がMoEでは特に効いてきます。attention(注意計算)や共有層など、役割の違うテンソルが混在するためです[3]。そしてもうひとつの工夫が、ファイルの分離です。モデル内部には巨大な参照テーブルEngramがあります(2つで196.6Bパラメータ)。これは本体とは別のファイル110.6GBに、4.50 bpwの型で保存されています[1][2]。中身はどの構成でも同一なので、ダウンロードは1回で済みます。テーブルはトークンごとに1行ずつ読むため、ディスク上のままメモリマップ(必要な部分だけを直接読む方式)で使えます[1]。
ただし「12GBのGPUで動く」は、GPU側の話です。エキスパートの重みは、使わない分もすべて保存しておく必要があります。そのため実運用では、システムRAM、ディスク容量、メモリ帯域が効いてきます。さらに専用推論エンジンStrataとの組み合わせが前提になります[3]。想定は、12GBのGPUとそれよりずっと大きなシステムメモリを組み合わせるハイブリッド推論です[3]。AlphaSignalは「大容量RAMを持つワークステーションでのローカル推論に向く」とまとめています[3]。公開情報には、この構成での実測速度(TPS)や消費電力の数値は見つかりませんでした。1.75ビットという極端な低ビットでの品質も、実測のベンチマーク数値では確認できていません。
GPTQで量子化の標準を作った研究室が、巨大MoEの圧縮でも先陣を切る形です。全部を均一に圧縮するのではなく、重要な部分にビットを集める考え方は、今後のローカル推論の常識になっていくかもしれません。なお、このモデルは各種のベンチマーク・価格比較サイトにも専用ページが立っており[4][4][4][4]、注目の高さがうかがえます。
引用ソース
- Reddit Reddit r/LocalLLaMA: [Release] ISTA GSQ-RCO GGUFs for DeepSeek-V4.1-Flash-1017 — https://www.reddit.com/r/LocalLLaMA/comments/1xe2wg8/release_ista_gsqrco_ggufs_for_deepseekv41flash1017/
[Release] ISTA GSQ-RCO GGUFs for DeepSeek-V4.1-Flash-1017
- Web記事 記事全文: DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF – Hugging Face — https://huggingface.co/ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF
Non-uniform GGUF quantizations of a 763B-parameter, 384-expert MoE, produced with GSQ and RCO.
This repository provides GGUF quantizations of DeepSeek-V4.1-Flash-1017 at three sizes: IQ1_M (1.75 bits per weight), IQ2_XXS - Web記事 記事全文: ISTA-DASLab Squeezes DeepSeek’s 763B Model onto a 12 GB GPU – AlphaSignal — https://alphasignal.ai/news/ista-daslab-squeezes-deepseek-s-763b-model-onto-a-12-gb-gpu
– ISTA-DASLab released GSQ-RCO GGUF quants of DeepSeek-V4.1-Flash-1017, a 763B 384-expert MoE.
– Three sizes available: IQ1_M (1.75 bpw), IQ2_XXS (2.00) and IQ2_XS (2.25).
– Runs on a single 12GB GPU when paired with the - Web記事 Web検索: DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF: Text-to-Text model — overview … — https://www.aimodels.fyi/models/huggingFace/deepseek-v4.1-flash-1017-gsq-rco-gguf-ista-daslab
DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF: Text-to-Text model — overview …
- Web記事 Web検索: DeepSeek V4.1 Flash 1017 (max) – Intelligence, Performance & Price … — https://artificialanalysis.ai/models/deepseek-v4-1-flash-1017
DeepSeek V4.1 Flash 1017 (max) – Intelligence, Performance & Price …
- Web記事 Web検索: DeepSeek V4.1 Flash 1017 Benchmark Scores & Evals | BenchmarkList — https://benchmarklist.com/models/deepseek-deepseek-v4.1-flash-1017/
DeepSeek V4.1 Flash 1017 Benchmark Scores & Evals | BenchmarkList
- Web記事 Web検索: DeepSeek-V4.1-Flash-1017 Benchmarks, Pricing & Context Window — https://llm-stats.com/models/deepseek-v4.1-flash-1017
DeepSeek-V4.1-Flash-1017 Benchmarks, Pricing & Context Window
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS