6GBのRTX 2060で、毎秒45トークン。MoEモデルのローカル推論に挑むフォークの更新報告が、Redditに投稿されました[1]。MoE(専門家混合)は、複数の「エキスパート」と呼ばれる小さなネットワークを切り替えながら計算する方式のモデルです。投稿者はllama.cppの高速化フォーク「ik_llama.cpp」に改良を加えた版で、動作報告と合わせて意見を求めています[1]。
そもそもik_llama.cppは、2024年6月にllama.cppから分かれたフォーク(独自改良版)です[2]。本体との同期は同年8月が最後で、以降は独自の進化を続けてきました[2]。名前の通りCPUでの推論速度が強みで、量子化(重みを圧縮してメモリを節約する仕組み)の型も独自に追加しています[2]。例えばMLA。アテンション(モデルが文中のどこを見るかを決める仕組み)の情報を圧縮する技術です[2]。複数GPUで計算を分けるテンソル並列なども、このフォークが先行していました[2]。
今回の投稿は、その流れを汲むIceFog72氏のフォーク更新です[1]。氏はMoEモデルの「エキスパートレジデンシー」最適化を続けています。これは各エキスパートの重みを、GPUのVRAMとシステムメモリ(RAM)のどちらに置くかを詰める手法です。前回投稿の続編で、アイデアは同じでも実装を一部作り直したといいます[1]。その結果、6GB VRAMのRTX 2060で、別エンジンのStrataに匹敵する速度が出たとのことです[1]。
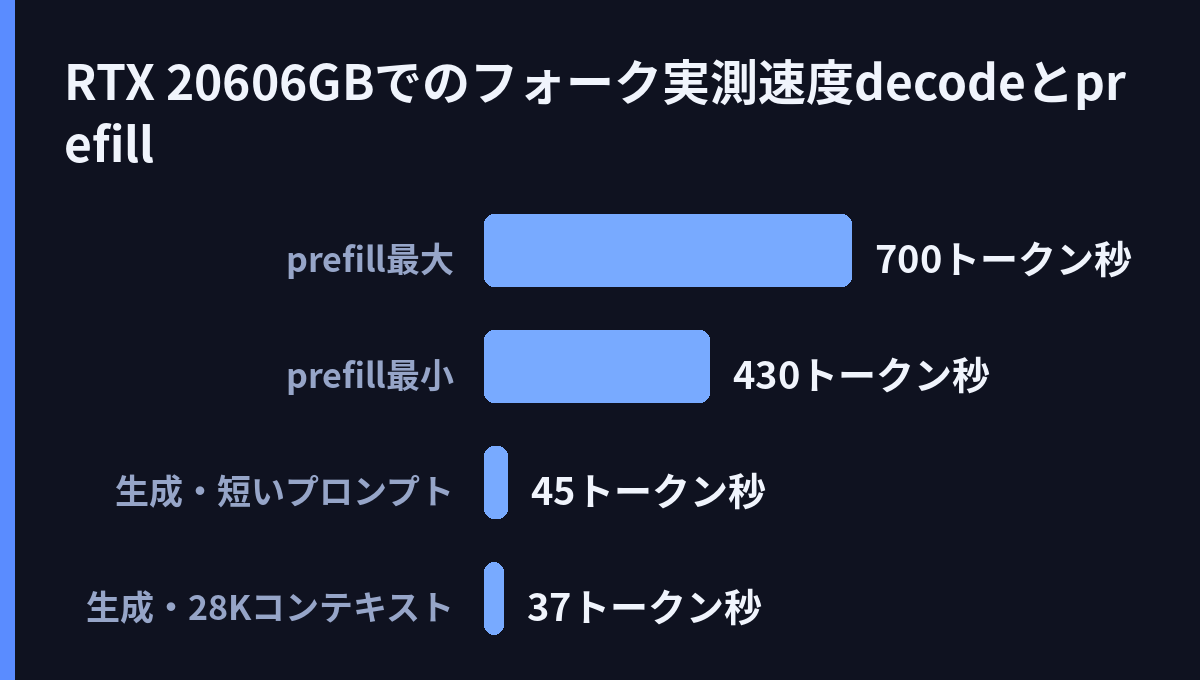
実測では、decode(トークンを1つずつ生成する段階)の速度が、短いプロンプトで毎秒45〜48トークンでした[1]。コンテキスト(モデルが一度に覚えていられる会話の領域)を28Kまで伸ばすと、毎秒37トークンになります[1]。28Kは長めの資料や会話を扱える水準です。prefill(プロンプト全体を一括処理する段階)は毎秒430〜700トークンに達します[1]。なお、テストしたモデル名は投稿本文に明記されていません。
フォーク側には性能を測る道具も揃っています。スループットを測るllama-benchをはじめ、KVキャッシュ(会話履歴を一時保持する領域)をなぞりながら測るsweep-benchなどです[3]。sweep-benchは平均を取らずに値をそのまま見るため、コンテキストを長くするにつれて速度がどう変わるかが分かります[3]。行列演算を直接測る専用ツールもあり、量子化やFlash Attention(計算をまとめて高速化する仕組み)の効果確認に使われています[3]。
ただし、扱うには条件がつきます。RAMに残した重みをGPU向きの並びに組み替えるオプション(-rtr)は、代表的な量子化タイプの一部にCUDA実装がありません[2]。そのため計算がCPUに残り、prefillがかえって遅くなることがあると開発元は注意喚起しています[2]。完全に動くのはCPU(AVX2以上、ARM_NEON以上)とCUDA(Turing世代以降)だけです。ROCmやVulkan、Metalの不具合は基本的に修正されないとも明言されています[2]。報告のRTX 2060はTuring世代で、この条件に収まります。特定の配布モデル(_XL付き)が動かない可能性への注意もあります[2]。
もう一つ興味深いのは、投稿者の姿勢です。この改良をllama.cpp本体へ統合するつもりはないと言います[1]。RTX 2060の1枚でしか十分な試験ができておらず、コードの整理も必要なためです[1]。一方、フォークをめぐる外側の動きは活発です。70BモデルとRTX GPUで本体と比較したベンチマーク記事もあります[4]。フォークの経緯と性能競争をまとめた解説も出ています[5]。GitHubの議論では、本体との最新のCPU性能比較が共有されました[5]。開発拠点をCodebergの「illama」へ移す動きもあるようです[5]。
フォークで生まれた改良が本体に流れ、個人のフォークがさらに新機軸を試す。ik_llama.cppをめぐる今回の報告は、その流れの最新の動きです。1枚の古いカードだけの実測で、汎用性の検証はこれからです。それでも、6GBのVRAMで28Kコンテキストを毎秒37トークンで動かせるという数字は、ローカル推論の環境選びの幅を広げる一つの目安になりそうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: Just update of ik_llama.cpp fork and seek of feedback — https://www.reddit.com/r/LocalLLaMA/comments/1xed7a7/just_update_of_ik_llamacpp_fork_and_seek_of/
Just update of ik_llama.cpp fork and seek of feedback
- Web記事 記事全文: ik_llama.cpp: llama.cpp fork with better CPU performance – GitHub — https://github.com/ikawrakow/ik_llama.cpp/
This repository started as a fork of llama.cpp in June of 2024 and was last synced with upstream in August of 2024. Compared to mainline llama.cpp, it offers additional SOTA quantization types and, in many cases, better
- Web記事 記事全文: Performance Benchmarking | ikawrakow/ik_llama.cpp | DeepWiki — https://deepwiki.com/ikawrakow/ik_llama.cpp/6.2-performance-benchmarking
This page documents the performance benchmarking tools and methodologies available in ik_llama.cpp. It covers llama-bench for high-level throughput measurements, sweep-bench for systematic parameter analysis, and special
- Web記事 Web検索: I Benchmarked Llama.cpp vs. ik_llama.cpp on a 70B Model with an RTX … — https://www.hardware-corner.net/guides/llama-cpp-vs-ik_llama-cpp/
I Benchmarked Llama.cpp vs. ik_llama.cpp on a 70B Model with an RTX …
- Web記事 Web検索: ikawrakow/illama: New home for ik_llama.cpp – testing – under … — https://codeberg.org/ikawrakow/illama
ikawrakow/illama: New home for ik_llama.cpp – testing – under …
- Web記事 Web検索: llama.cpp vs ik_llama.cpp: The Fork, Drama and Performance Race — https://ramgpt.org/articles/llama-cpp-vs-ik-llama-cpp-fork-drama-performance/
llama.cpp vs ik_llama.cpp: The Fork, Drama and Performance Race
- Web記事 Web検索: Latest CPU performance comparison with llama.cpp – GitHub — https://github.com/ikawrakow/ik_llama.cpp/discussions/164
Latest CPU performance comparison with llama.cpp – GitHub
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS