[2026-11-13 更新] Abliterated Strataは、Flash-Next系の拒否を削ったモデルをStrataで動かすためのパック化と互換性が中心です。83 GiBの統合GGUFや103〜127トークン/秒の報告がある一方、エンジンが認識しない例や評価方法の分岐も見えます。
[2026-11-13 更新] Abliterated Strataは、Flash-Next系の拒否を削ったモデルをStrataで動かすためのパック化と互換性が中心です。83 GiBの統合GGUFや103〜127トークン/秒の報告がある一方、エンジンが認識しない例や評価方法の分岐も見えます。
Xing4.0-29B-A4BのMoEモデルがGGUFで注目されています。総パラメータ29Bのうち4Bだけ動く設計と、中間量子化のサイズ・精度の差が要点です。ローカル推論で量子化を選ぶ視点を追います。
UnslothがQwen3.8-Flash-NextのDynamic V3.1 GGUFを公開し、GSQ-RCO比で10〜15%の精度向上を主張。26Bトークン超の検証や量子化切替が話題で、ローカル実行の目安も追います。
llama.cppの量子化では、7BモデルでQ4_K_Mが3.80GB、perplexity増加+0.0535と旧型より有利です。速度は環境依存で、ビルド番号やコンテキスト長を揃えた再現ベンチマークが鍵です。Hacker Newsの動向から、ローカルAI推論の落とし穴が見えます。
Mistral Large 4 Le Chonkがオープンウェイトで公開されました。総パラメータ1.05T、アクティブ52BのMoEで、推論やコーディング、防御セキュリティを強化しています。ローカル実行の実測値は素材にありません。
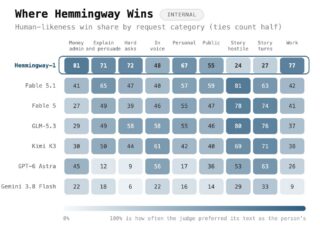
Hemmingway-1.5はQwen 27Bの文章特化モデルで、AI検知器を90%通過するとされています。人間は86%、前世代は7%で、書き味と検知回避が焦点です。ローカル実行や独自ベンチの注意点もわかります。
llama.cppはローカル推論の基準として、M1 Maxでの5エンジン比較や量子化の品質・サイズ評価で注目されている。JVM単一JARの高速主張やObsidian連携も話題だが、条件違いのため単純な優劣は難しい。
llama.cppの話題は、速度より内部構造と量子化の解説へ向かっています。32bitの重みを4bitへ圧縮する仕組みや、GGMLと推論コンテキストの役割が整理されました。単一JARで速いという投稿や周辺トレンドもあり、直接比較の数値は素材にありません。
LFM3-Omni-2B-GGUFが、テキスト・画像・音声・動画を入力し、音声でも答えるローカル推論で話題です。Redditではポーランド語の音声認識と合成が動く2Bモデルとして注目され、llama.cppの制約も共有されています。
オープンソースMoEモデルdots.llm1(総142B・活性化14B)の推論環境が整理され、Docker・vLLM・SGLangの3ルートが案内されました。性能はQwen2.5-72B相当ですが、メモリは総パラメータ基準で個人には重く、手元では3Bのdots.mocrをGGUFで動かす道も見えてきました。
2026.11.13
AIチャットは性能差より監視と推論設計が分かれ目
2026.11.12
AIエージェントは業務の入口で試されている
2026.11.12
Fireworks AIが2回目の侵害を通知、推論基盤の被害が拡大
RECENT COMMENTS