ローカルでAIを動かすなら、まずllama.cpp——この定番に挑む異色のツールが、Hacker Newsに投稿されました[1]。その名はqxotic.ai。Javaの実行環境(JVM)上で動く推論エンジンで、依存ライブラリを一切使わない単一のJARファイル1つで配布されます。うたい文句は「llama.cppより速いローカル推論」です[1]。
JARとは、Javaのプログラムを1つのファイルにまとめた形式です。JVM(Javaプログラムを動かす土台)さえ入っていれば、OSの違いをほぼ気にせず起動できます。C++製のllama.cppでは、環境に合わせたビルドやセットアップが発生しがちです。その手間をゼロにできる可能性が注目を集めたようです。業務システムでJavaは今も広く使われており、既存のシステムへの組み込みやすさは大きな利点になりそうです。ただし現時点で投稿は1ポイント、コメントは0件です。コミュニティによる検証は、まだ始まっていません[1]。
注目される背景には、ローカルLLMを取り巻く環境の変化があります。GitHubで公開されている2026年版のガイド[2]は、かつて趣味の実験だったローカルLLMが、開発者の標準的な道具になったと説明しています。データを外部に送らないため、HIPAAやGDPRへの対応にも役立ちます。コストの試算も具体的です。クラウドAPIは100万トークンで30ドル。一方、1600ドルのRTX 4090を買えば、約5300万トークンで元が取れる計算になります。頻繁に使う開発者なら、2〜6か月で損益分岐に達するとしています[2]。トークン間の遅延も数十ミリ秒で、クラウドのような往復分の待ち時間がありません。ネットがなくても同じように動きます[2]。
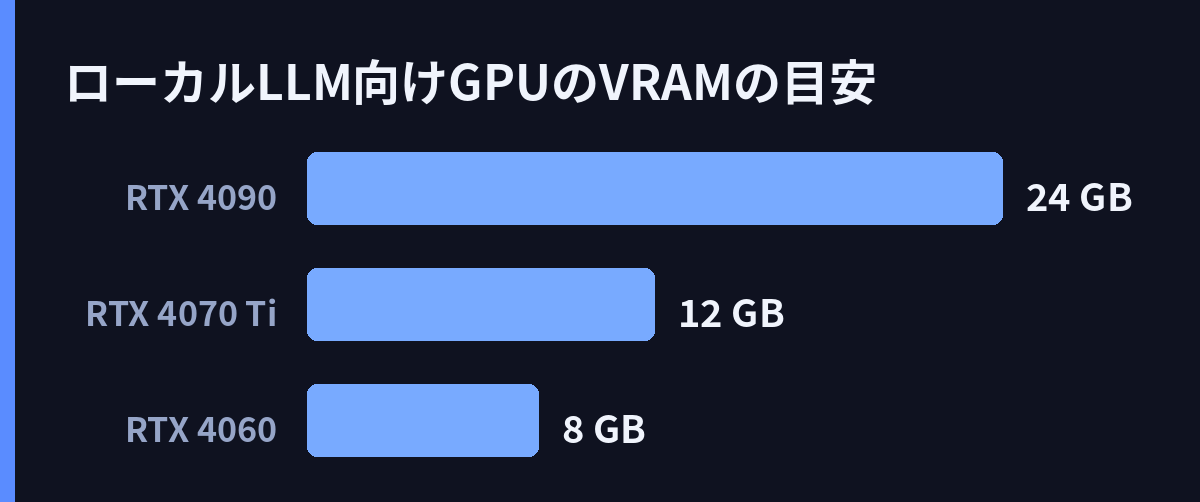
必要な機材の目安も示されています[2]。VRAM(動画メモリ)が最大の制約で、RTX 4060の8GBなら7Bモデル、RTX 4070 Tiの12GBなら14B、RTX 4090の24GBなら30Bが快適に動くとしています。8GBでも14Bなら、一部の処理をCPUに逃がす方法で動かせます。メモリ(RAM)は最低32GB、本格運用なら64GB以上が目安です。ユニファイドメモリ搭載のMac(M2/M3/M4 Max)も選択肢です。導入のハードルも下がりました。アプリのJanやOpen WebUIを使えば、ターミナル操作なしでモデル(重みは4〜5GB程度)をダウンロードし、すぐ会話を始められます[3]。無料のモデルも豊富で、Llama 3.2(3B・速度重視)、Mistral 7B(バランス型)、Phi-3 Mini(低メモリ向け)などが定番です[3]。
推論エンジン選びを助ける情報も増えています。vLLMとllama.cppを比べた検証記事[6]や、vLLM・SGLang・TGI・llama.cppを並べた比較[7]、最適化の観点でベンチマークした記事[8]などが公開されています。再現可能な形でベンチマークを公開する試みもあります[4]。これらは既存の定番エンジン同士を比べたもので、JVM製の新顔はまだ対象になっていないようです。なお「1ファイルで配布する」という発想自体は新しいものではありません。mozilla-aiのllamafileは、LLMを単一ファイルで配布・実行できる仕組みとして知られています[5]。
しかし、ここには注意点があります。「llama.cppより速い」を支える具体的な数値は、今回の素材には見つかりませんでした。Hacker Newsでも議論はまだ動いておらず[1]、比較記事[6][7][8]の中でJVM製ツールがどこに位置するかを示すデータもありません。さらに「速さ」には複数の意味があります。ローカル実行は、最初のトークンが出るまでの時間ではクラウドに劣る一方、生成の持続速度は有利だという指摘もあります[2]。モデルの大きさや量子化(重みを圧縮してメモリを節約する仕組み)、ハードウェアでも結果は変わります。どの条件でどの指標が速いのかは、まだわかりません。
それでも、この試みの方向性は魅力的です。依存ゼロのJARは、Javaで作られた企業システムにAI推論をそのまま組み込める可能性を示します。llamafileが「1ファイルで配布」の壁を下げてきた流れ[5]の延長にあり、ローカル推論のセットアップの手間を、また一つ減らすかもしれません。速度の主張が実測で裏づけられるか。そこが次の注目点です。
引用ソース
- Hacker News Hacker News: Local inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://qxotic.ai/
Local inferencing in one JVM JAR, dependency free, faster than llama.cpp
- Web記事 記事全文: Awesome Local LLM Setup 2026 – GitHub — https://github.com/UnknownGamer11/awesome-local-llm-2026
The complete guide to running LLMs locally: privacy-first, cost-effective, and production-ready. Updated April 2026.
Why this guide exists: Running local LLMs has evolved from hobbyist experiment to core developer toolki - Web記事 記事全文: How to Run AI Locally in 2026 (Offline, Private, Free) | HookFlow — https://hookflow.ai/guides/run-ai-locally
Quick Definition
Running AI locally means executing a large language model (LLM) on your own computer, with no data sent to external servers. The model weights are downloaded once to your machine and run entirely on your - Web記事 Web検索: GitHub – winderai/llm-inference-benchmark: A reproducible benchmark of … — https://github.com/winderai/llm-inference-benchmark
GitHub – winderai/llm-inference-benchmark: A reproducible benchmark of …
- Web記事 Web検索: GitHub – mozilla-ai/llamafile: Distribute and run LLMs with a single … — https://github.com/mozilla-ai/llamafile
GitHub – mozilla-ai/llamafile: Distribute and run LLMs with a single …
- Web記事 Web検索: vLLM vs llama.cpp (2026): What Official Docs and Public Benchmarks … — https://markaicode.com/benchmarks/vllm-vs-llamacpp-performance/
vLLM vs llama.cpp (2026): What Official Docs and Public Benchmarks …
- Web記事 Web検索: Best LLM Inference Engines 2026: vLLM vs SGLang vs TGI vs llama.cpp — https://deploybase.ai/articles/best-llm-inference-engine
Best LLM Inference Engines 2026: vLLM vs SGLang vs TGI vs llama.cpp
- Web記事 Web検索: LLM Inference Optimization: vLLM, TGI, and llama.cpp Benchmarked — https://tools.zgba.com/blog/llm-inference-optimization
LLM Inference Optimization: vLLM, TGI, and llama.cpp Benchmarked
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS