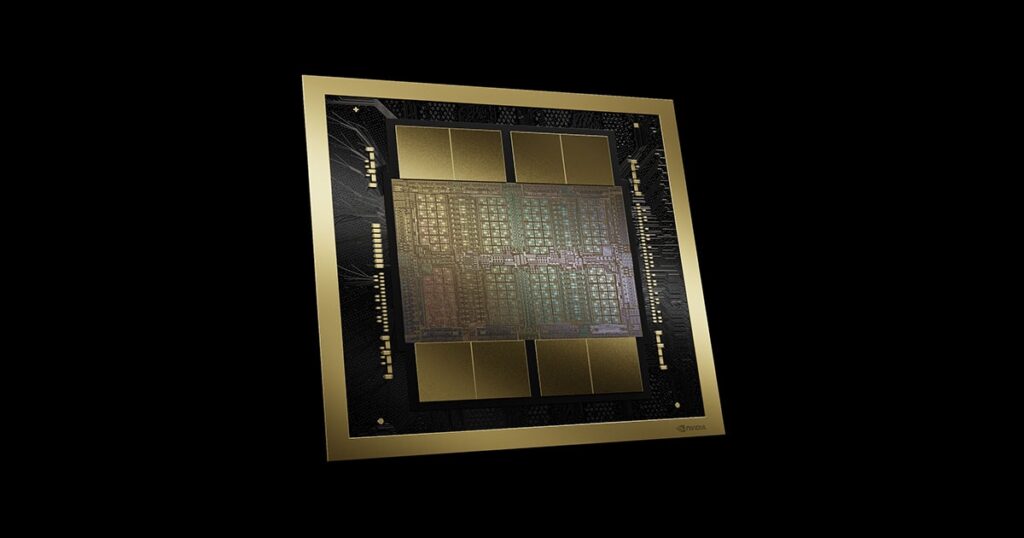
GPU1個のなかで2080億個のトランジスタが動く時代が来ました。前回の記事では、NVIDIAの小型モデル「Nemotron 3.5 Bolt E4B」を追いました。4GBのメモリで品質を約40%上げ、出力を約80%減らしたという実測です。今回は視点をデータセンター側に移します。土台となるGPU「Blackwell(ブラックウェル)」の技術の中身を見ます。あわせて、NVIDIAの過去最高決算も整理します。
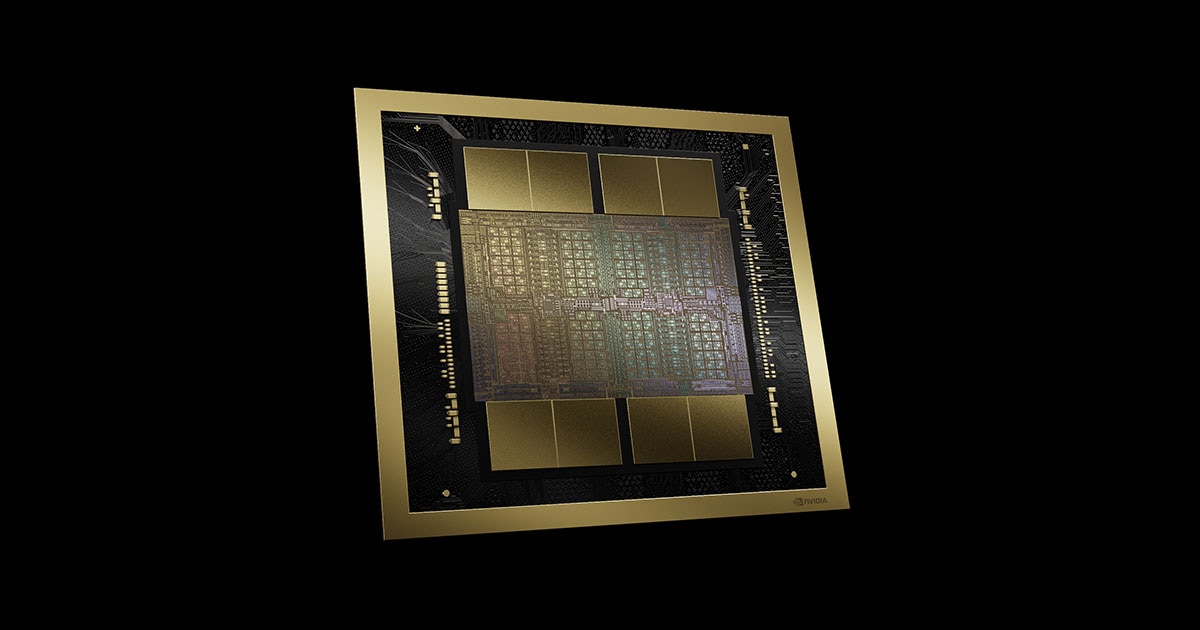
NVIDIAの公式ページ[2]によると、BlackwellアーキテクチャのGPUは2080億個のトランジスタを、TSMCの4NPプロセスという専用に調整した製造技術で作っています。トランジスタ数が多すぎるためです。製造装置が扱える1枚のチップサイズの限界を超えています。そこで2つのダイ(チップの元になる小片)を10TB/sの配線でつなぎ、1個のGPUとして動かす構成になりました[2]。10TB/sは、1秒間に10テラバイトのデータを動かせる非常に速い帯域です。
推論と学習の両方を加速する心臓部となるのが、Transformer Engineの第2世代です。大規模言語モデル(LLM)やMoE(複数の小さなモデルが分担して答える仕組み)の学習と推論を速くします[2]。TensorRT-LLMやNeMoといったNVIDIA製ソフトウェアと組み合わせた効果です[2]。Tensor Coreには、コミュニティが定めたmicroscaling形式という新しい精度も加わりました。より大きい精度からの置き換えがしやすく、高い精度を保てるとしています[2]。NVIDIAはこのアーキテクチャを、世代を重ねた技術の上に立つ「次の章」と説明しています[2]。
注目はFP4対応です。FP4は数値を4ビットの浮動小数点で表す形式で、メモリに載せられるモデルの規模と性能を2倍にできるとしています[2]。これを支えるのが、細かい粒度でスケールを調整するmicro-tensor scalingという技術です[2]。性能と精度の両立を狙った工夫のようです。
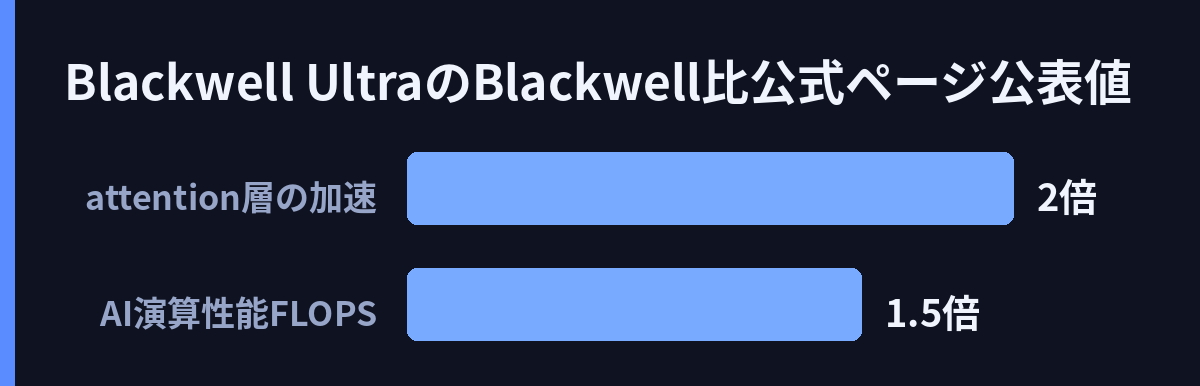
上位バージョンのBlackwell Ultraとの違いも数字で示されています。通常のBlackwell比で、attention層(文脈のどこを見るかを計算する部分)の加速は2倍、AI演算性能(FLOPS、1秒あたりの演算回数)は1.5倍です[2]。セキュリティも進んでいます。BlackwellはConfidential Computingに対応します。データやAIモデルをハードウェアで守る機能です。さらに、入出力も保護領域で扱うTEE-I/Oという仕組みに業界で初めて対応しました[2]。NVLink経由の保護も提供しています[2]。機密計算を有効にしてもスループットはほぼ落ちないとしています[2]。
このBlackwellが、決算の数字を押し上げています。2026年度第4四半期の売上高は681億ドルで、AI需要によって過去最高を更新しました[3]。Blackwellの好調によりAI半導体需要が続いているというまとめもあります[3]。AI半導体で売上高が73%増となり、記録を更新したという報道もあります[3]。
しかし、素材には読み取れない部分もあります。ゲーミング向け「RTX Blackwell」の公式PDF[1]は、今回の取得では内容が判読できませんでした。技術資料[3]も検索結果のタイトルしか確認できません。消費者向けGPUの詳細な比較は、素材からは書けませんでした。決算記事も見出し中心のため、データセンター部門とゲーミング部門の内訳はわかりません。また、2倍・1.5倍はBlackwell同士の比であって、前世代との比較数値は素材に見つかりませんでした。
一方で、規模の対比は興味深いところです。NVIDIAはBlackwellを「AIファクトリー」のエンジンと説明しています[2][3]。AIファクトリーとは、AIの学習や推論を大規模に回すデータセンターのことです。すでに量産が始まったと伝えます[2]。その規模を裏付けるのが681億ドルの売上[3]です。一方、以前取り上げたBolt E4Bの実測は、重みを圧縮してメモリを節約する量子化で約4GBに収め、エッジで動く話でした。巨大なGPUと小さなモデルという両極が、同じNVIDIAのエコシステムで動き始めているようです。FP4のような省メモリ技術が進めば、この両極の距離はもう少し縮まるかもしれません。次に見たいのは、公表された性能が実際の推論速度(TPS)としてどんな数字に出るかです。素材には実測TPSがなかったため、今後のベンチマーク報告を待ちたいところです。
引用ソース
- Web記事 記事全文: PDF Nvidia Rtx Blackwell Gpu Architecture — https://images.nvidia.com/aem-dam/Solutions/geforce/blackwell/nvidia-rtx-blackwell-gpu-architecture.pdf
M#��=��O$�a��w$�4�����”cMv�/Ϋ��2 ��h��7:.fd�xgL�F2��o�o�/��=T/c�*� �h�Ik���w�����g$5��4�U\�Q�|��{-�”M�������r����T9����8�ٶ&� N”es�6�d}?<�x���’��Q�������U��Ş�0� }CS�VV��=U�*-ZZ�ȹ��P�N0Ѥ k��^m��
- Web記事 記事全文: NVIDIA Blackwell: GPU Architecture for Generative AI & HPC | NVIDIA — https://www.nvidia.com/en-in/data-center/technologies/blackwell-architecture/
The engine behind AI factories for the age of AI reasoning—now in full production.
Explore the groundbreaking advancements the NVIDIA Blackwell architecture brings to generative AI and accelerated computing. Building upo - Web記事 Web検索: The Engine Behind AI Factories | NVIDIA Blackwell Architecture — https://www.nvidia.com/en-us/data-center/technologies/blackwell-architecture/
The Engine Behind AI Factories | NVIDIA Blackwell Architecture
- Web記事 Web検索: 【速報】NVIDIA 2026年度Q4決算まとめ ── 売上高681億ドル、AI需要で過去最高を更新 – Qiita — https://qiita.com/kotaro_ai_lab/items/ab7638c6cc5c3540755a
【速報】NVIDIA 2026年度Q4決算まとめ ── 売上高681億ドル、AI需要で過去最高を更新 – Qiita
- Web記事 Web検索: NVIDIA過去最高益、Blackwell好調でAI半導体需要続く | research.nicoxz.com — https://research.nicoxz.com/articles/nvidia-record-earnings-blackwell-ai-gpu
NVIDIA過去最高益、Blackwell好調でAI半導体需要続く | research.nicoxz.com
- Web記事 Web検索: PDF NVIDIA Blackwell Architecture Technical Brief — https://dam-cdn.nvd.orangelogic.com/AssetLink/gl2l4l4812s5fw0p614s6i8bv6mi3vx5.pdf
PDF NVIDIA Blackwell Architecture Technical Brief
- Web記事 Web検索: エヌビディア決算、AI半導体で売上高73%増の記録更新 | research.nicoxz.com — https://research.nicoxz.com/articles/nvidia-q4-earnings-ai-revenue-record
エヌビディア決算、AI半導体で売上高73%増の記録更新 | research.nicoxz.com
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS