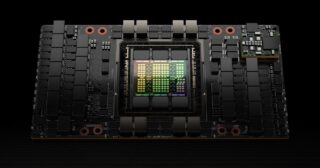
BlackwellがMLPerf Training v5.1で全項目最速となり、B200のmicrobenchmarkではメモリ遅延が58%減りました。AIの推論セッションでは、データのやり取りと次バージョンのFP4の精度が焦点になります。
BlackwellがMLPerf Training v5.1で全項目最速となり、B200のmicrobenchmarkではメモリ遅延が58%減りました。AIの推論セッションでは、データのやり取りと次バージョンのFP4の精度が焦点になります。
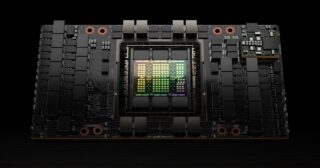
NVIDIAのBlackwellを巡り、MLPerfで全項目最速と報告されました。さらに論文ではB200がH200比で学習スループットが1.85倍、エネルギー効率が32%向上したと実測されています。AIの推論と学習で、FP4と省エネの差が焦点です。
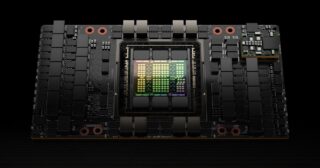
NVIDIAのBlackwellがMLPerf Training v5.1で全項目で最速を発表しました。H200比ではResNet-50が1.85倍、GPT-1.3Bが1.55倍、電力効率は32%改善しました。FP4と接続仕様からAI推論と学習の変化を解説します。
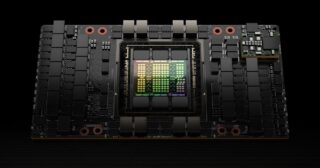
B200は実測でH100より最大57%速く、自前運用なら最大10倍安いと報告されました。推論はモデルやソフトウェアの成熟に左右され、FP4はNVFP4が前提です。仕様・価格・電力の落とし穴を追います。
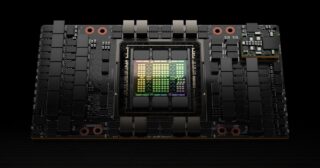
BlackwellがAI学習ベンチマークMLPerf Training v5.1で7モデル全項目の最速学習を掲げました。FP4/NVFP4とB200の実測から、学習速度と電力効率の差が見えます。推論を含む評価の中心が接続から学習へ動いています。
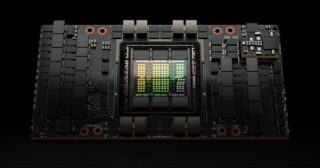
公式資料と製品解説を踏まえ、NVIDIAの話題はH100からBlackwellへ移り、推論と接続が中心です。H100は推論が最大30倍、BlackwellはH100比で推論が約5倍とされます。電力、価格、入手方法など運用条件の違いが読み取れます。
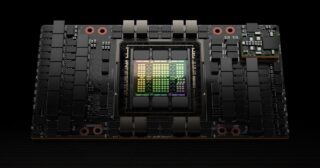
2026年のNVIDIAでは、H100が現役の主役として残り、H100 NVLのような中間構成が注目されます。Blackwell UltraはFP4だけでなく、2ダイ接続や検証、TEE-I/Oで差を見せます。前回とは別の角度で追跡します。
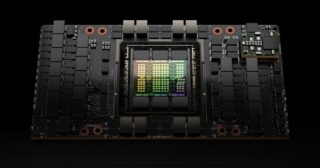
NVIDIAのBlackwellは208Bトランジスタと10TB/sのダイ間接続を掲げ、FP4推論を強調します。H100は推論30倍や900GB/s接続で現役です。検索結果には両世代の検証資料も並び、世代差の読みどころが整理できます。
H100の現役性とBlackwellの実測差が話題です。2026年時点でH100は主力で、SXM5とPCIeの差、FP8推論、B200がH200比で混合精度1.56倍、省電力42%、キャッシュミス時遅延58%減という検証から、世代より構成が重要だと読み解きます。
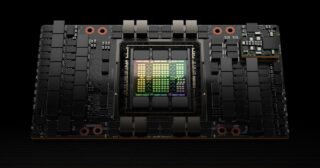
H100はLLMと推論を最大30倍高速化し、GPT-3 175B学習を4倍速くするとされます。Grace Hopperは10倍を掲げますが、BlackwellのMLPerf席巻には具体的な数値がありません。データセンターの動向を追います。
2026.11.13
AIチャットは性能差より監視と推論設計が分かれ目
2026.11.12
AIエージェントは業務の入口で試されている
2026.11.12
Fireworks AIが2回目の侵害を通知、推論基盤の被害が拡大
RECENT COMMENTS