もう何年も前のグラボが、いまだ現役で主役を続けています。
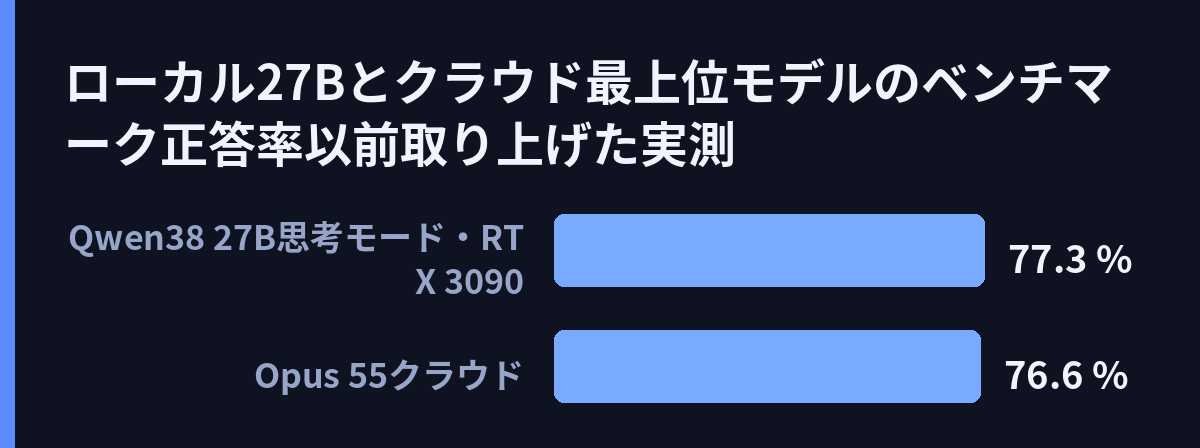
RTX 3090は、24GBのVRAM(グラボ専用のメモリ)を備えたNVIDIAのGPUです。ローカルAI(クラウドに頼らず自分のPCでAIを動かすこと)の世界では、発売から時間が経っても選ばれ続けています。以前取り上げた実測では、Qwen3.8 27Bがベンチマークで77.3%を記録しました。思考モード(回答前に推論ステップを展開する機能)をオンにした状態です。クラウド最上位のOpus 5.5が76.6%ですから、引けを取りません。その確認から少し時間が経ち、今度は「24GBで何をどう動かすか」を実践レベルでまとめる動きが広がっています。
中心にあるのは、GitHubで公開された「llm_on_rtx_3090」というガイドです[2][3]。著者は「実戦で検証済み」と銘打っています。環境はIntel Xeon W-2235、RAM 128GB、そしてRTX 3090です。Ubuntu 24.04の新規インストールから出発し、手順ごとに文書化しました。Ollama(ローカルでLLMを動かす定番ツール)での推論まで到達します。さらにDocker(環境を丸ごと包んで動かす仕組み)での展開も扱います。記録したモデルは1.7Bから35Bまでの59種類に上ります。セットアップ用スクリプトが機種を自動判別するなど、再現性を重視した作りです。クラウド費用もAPIの利用制限もなく、プライバシーを完全に保てるのが売りです。
実測の数字も具体的です。32BモデルをCPUに逃さず、GPUだけで完結して動かしました。推論中のGPU使用率は80〜97%に達しています。速度はモデルのサイズに応じて毎秒17〜90トークン(1秒に生成できる単語のかけらの数)です。画像生成モデルのStable Diffusion(SDXLとFLUX)を、同じGPUでOllamaと並行して動かす構成まで載せています。モデル用と作業用でストレージを分ける工夫や、ベンチマーク一式の同梱も特徴です。2026年7月の更新では、Gemma 4、OpenAIのGPT-OSS、Devstral、Mistral Small 3.1/3.2、Qwen 3.5/3.6の11モデルが追加されました。古いカードに新しいバージョンのモデルが次々と載っていく形です。
用途の面でも、広がりを示す声があります。Redditに「3090と32GB RAMで動く、リバースエンジニアリングを拒否しない小さいモデルを探している」という投稿が上がりました[1]。リバースエンジニアリングとは、完成したソフトの中身を解析して仕組みを調べる作業です。投稿者は、クラウドモデルでは「通報されてアカウントを停止される」おそれさえあると書いています。大きめのGLM 5.3は、自分の環境では大きすぎて動かないといいます。監視を避けたい需要と、限られたVRAMの両立が課題です。一方、YouTubeでは「ローカルAIのリバースエンジニアリングが怖いほど得意になった」と題し、Qwen 27Bを検証する動画も公開されました[7]。ハッキングやセキュリティ調査の現場ほど、解析対象を外に送らずローカル推論で済ませたいはずです。
しかし、24GBの壁が消えたわけではありません。ガイド自身が、別のAI向けマシンGX10との比較を載せています[2][3]。GX10はARM(スマホ向けの省電力CPU設計)搭載のマシンです。帯域(データを運ぶ速さ)を犠牲にする代わりに、容量を確保します。3090では保持できない70B〜120Bのモデルを動かせるのが強みです。32Bで頭打ちか、120Bまで届くか。この差は大きいです。周辺を見ても、24GBという階層を扱う記事が相次いでいます。SpheronはVRAMの量別に、セルフホスト向きのモデルを整理しました[6]。IntuitionLabsは24GB GPU向けのモデルと最適化を解説し[8]、localllm.inは24GB VRAM向けの性能分析を出しています。推論エンジン自身のコードをリバースエンジニアリングして最適化したという報告[4]や、決まった処理とLLMを組み合わせたソフト開発のスタックを3090で組んだという資料[5]も見られます。
RTX 3090の価値の源泉は、性能の新しさではありません。24GBというVRAMの容量と、積み上がった実運用のノウハウです。新しいモデルが24GBに収まる形で登場する限り、このカードは使い続けられます。ベンチマークでクラウドに並び、実運用のガイドも整い、用途はソフトの解析まで広がりました。一方で、100B超のモデルはより大容量のマシンの領域です。ローカル推論の「使える大きさ」が、実測ベースで少しずつはっきりしてきたといえます。
引用ソース
- Reddit Reddit r/LocalLLaMA: Small model good for reverse engineering that can run on a 3090 and 32GB RAM. — https://www.reddit.com/r/LocalLLaMA/comments/1xeipmm/small_model_good_for_reverse_engineering_that_can/
Small model good for reverse engineering that can run on a 3090 and 32GB RAM.
- Web記事 記事全文: Local LLM & Image Generation on RTX 3090 – GitHub — https://github.com/keturk/llm_on_rtx_3090
Battle-tested guide for local AI inference on Ubuntu 24.04 with NVIDIA GPU acceleration. From fresh OS install to running 32B parameter models at 97% GPU utilization — plus Stable Diffusion image generation on the same c
- Web記事 記事全文: llm_on_rtx_3090/README.md at main – GitHub — https://github.com/keturk/llm_on_rtx_3090/blob/main/README.md
Battle-tested guide for local AI inference on Ubuntu 24.04 with NVIDIA GPU acceleration. From fresh OS install to running 32B parameter models at 97% GPU utilization — plus Stable Diffusion image generation on the same c
- Web記事 Web検索: Author optimizes local LLM inference engine by reverse-engineering its … — https://pulseaugur.com/cluster/303088-author-optimizes-local-llm-inference-engine-by-reverse-engineering-its-code
Author optimizes local LLM inference engine by reverse-engineering its …
- Web記事 Web検索: 3090 Local AI Stack – Deterministic + LLM-augmented software generation — https://gist.github.com/jmanhype/225be66f82afb2f4b00d8a44a553f70a
3090 Local AI Stack – Deterministic + LLM-augmented software generation
- Web記事 Web検索: Best Open-Source LLMs to Self-Host in 2026: VRAM Tier Guide | Spheron — https://www.spheron.network/blog/best-open-source-llms-self-host-2026-vram-guide/
Best Open-Source LLMs to Self-Host in 2026: VRAM Tier Guide | Spheron
- Web記事 Web検索: Local AI Is Getting Scary Good at Reverse Engineering (Qwen 27B … — https://www.youtube.com/watch?v=mK8PMBLmPG0
Local AI Is Getting Scary Good at Reverse Engineering (Qwen 27B …
- Web記事 Web検索: Local LLM Deployment on 24GB GPUs: Models & Optimizations — https://intuitionlabs.ai/articles/local-llm-deployment-24gb-gpu-optimization
Local LLM Deployment on 24GB GPUs: Models & Optimizations
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS