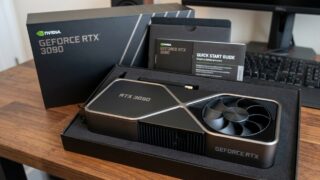
2026年時点のRTX 3090は、24GBのGDDR6Xと936GB/sの帯域幅を武器に、ローカルAIの推論や4Kゲームで注目されています。350Wや3スロットの制約は残りますが、flashのようなAIを含む中古市場での選び方が見えてきます。
2026年時点のRTX 3090は、24GBのGDDR6Xと936GB/sの帯域幅を武器に、ローカルAIの推論や4Kゲームで注目されています。350Wや3スロットの制約は残りますが、flashのようなAIを含む中古市場での選び方が見えてきます。
Qwen3.8-27Bの量子化で、8bit KVキャッシュはほぼ品質を落とさずメモリを半分にできるという実測が話題です。4bit重みはタスクによって持ちこたえ、1bitは崩れるという報告もあります。AI推論の速度とVRAMの落としどころを続報で整理します。
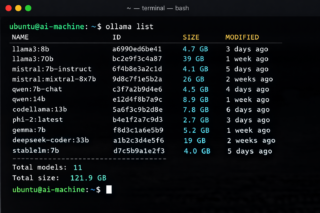
ローカルAI環境で推論レベルをNoneにすると速いものの、品質への不安は残りました。Redditではagentic tasksでmedium以上を使う声があり、hacker的な設定遊びより評価が大事だと分かりました。ローカルLLMの速度とコストも関係します。
Alibaba の Qwen4 は、本体完成前に設計図を公開する動きが目立ちます。125B MoE でアクティブ 6B、51B を DDR4 に退避し、ローカルで 21 tokens/sec とされています。推論設定と公開予定を整理します。
RTX 3090は24GBのVRAMと帯域で、2026年もローカルAI推論の中心です。14Bで52.1 tok/s、2枚で8エージェント250Kコンテキストなど具体的な報告があります。Flashモデルや画像生成の構成と限界がわかります。
Qwen3.8-27Bのローカル実行で、量子化の精度とVRAMの差が注目されています。KLD平均0.0002で重み18.8GiBという報告や、8bit浮動小数点版より39%低い検証などが出ました。圧縮の進み方と、重みの中に計算機を埋める実験の広がりもわかります。
Strata追跡では、Redditの実使用感と公式ベンチ・コスト計算が注目されています。RTX 4090でWrite 109.3 tok/s、Read 4000 tok/s、回収433日など具体的な数字が並び、計測ガイドも整備されました。
Qwen 3.8 Flash Next(125B MoE)を8GBのGPUで動かす検証が相次いで報告されています。全体の約3割を占めるn-gram参照テーブルをシステムRAMに置く構成で、decode毎秒30〜36トークンを達成。量子化やMTPなど速度と品質のトレードオフも実測で見えてきました。
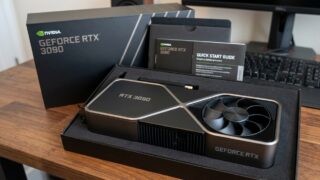
2020年に1499ドルで発売されたRTX 3090が、2026年も購入ガイドやベンチマーク検証の対象になり続けています。CUDAコア10,496個、24GB GDDR6Xという構成の詳細に加え、PassMarkで1万7000件超の実測サンプルが集積。ゲーム性能では割高だった発売時の評価と、大容量メモリを軸とする現在の位置づけを整理します。
巨大MoEモデルのエキスパートをディスクから直接読み込む推論方式が、llama.cpp周辺で具体化してきました。ルーターとattentionの計算の隙間を先読みに使い、概ね2倍の速度向上が報告されています。実装や検証記事も出そろい、24GBでの96K主張の裏付けも問われ始めました。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS