RAMに入りきらない巨大MoEモデルを、スマホやノートPCでそのまま動かす——。この発想が、個人の実験から「道具と解説が揃う」段階へ進んできました。Hacker Newsの「Show HN」(個人プロジェクトの発表枠)に投稿されたBigMoeOnEdgeは、llama.cppの上に被せる形の拡張ソフトです。大きなMoEモデルをスマホやノートでストリーミングしながら動かせるようにする、というのが売りです[1]。MoEのモデルは「エキスパート」と呼ばれる部分ネットワークを多数備え、トークンごとにその一部だけを計算に使います。この構造を逆手に取り、必要な部分だけを端末に流し込もうというのが、一連の試みの核心です。
BigMoeOnEdgeを取り上げたデータサイエンス系ニュースは、「RAMより大きいMoEモデルをスマホでストリーミングする」と紹介しました[7]。名称と説明から、使う重みをストレージから都度読み込む方式だと想像できます。ただし公開情報はまだ少なく、仕組みの詳細や実測値は確認できていません。そもそも端末側の壁は厚く、以前取り上げた解説は、16GBや24GBのマシンでは重みの「置き場所」が最大の壁になると指摘していました。巨大MoEの総サイズは数百Bに及ぶことがあり、スマホのRAMにそのまま収まるはずがありません。だからこそ「流し込む」発想に意味があるわけです。
同じllama.cppの上に築く別実装も登場しています。GitHubの「llama.moe」は、MoEモデル向けの軽量推論フレームワークで、dynamic expert offloading(使うエキスパートだけを動的に読み替える方式)を特徴とします[2]。ビルドにはCUDA(GPU計算のための環境)が必要で、ビルドや実行用のスクリプトも用意されています[2]。使い方はllama-serverと同じで、コマンドを「zilong」に置き換えるだけで済むと説明されています[2]。llama.cppに慣れたユーザーが設定を変えずに移行できる点は、実用面で大きいと思われます。
解説資料も揃ってきました。HuggingFaceのブログには、MoEをCPUで処理しつつGPUで加速する、ローカル実行の実践ガイドが投稿されています[4]。大規模MoEモデルの推論性能を最適化する手順をまとめたガイドも公開されています[5]。さらに、llama.cppのMoEオフロードを解説する記事もあります。オフロードとは、使わない重みをGPUの外に置く技法のことです。この記事では、「エキスパートをCPU側に何層分置くか」を指定するフラグ(–n-cpu-moe)の意味と、ストリーミングの挙動が丁寧に説明されています[5]。技が道具になり、道具の解説書が追いかける、という順番です。
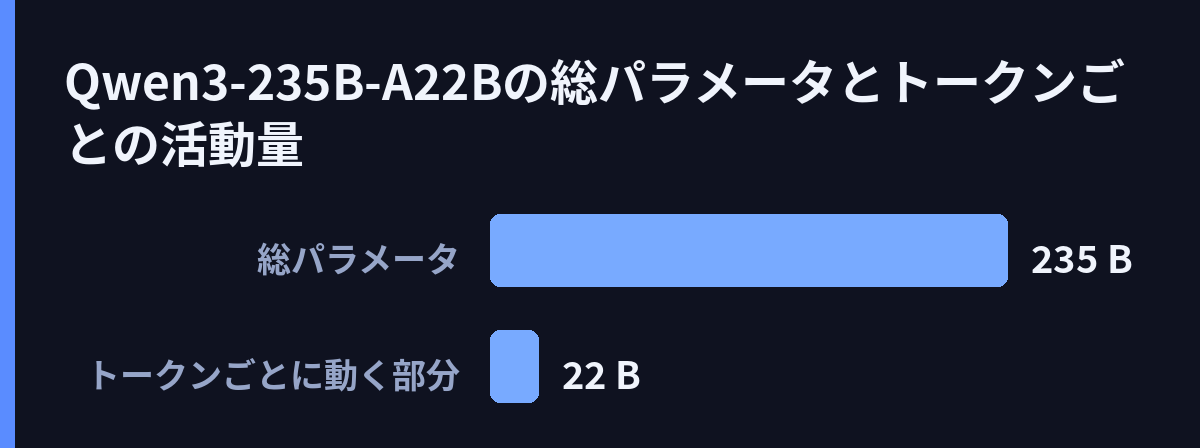
なぜこれらの工夫で巨大モデルが動くのか。以前取り上げた解説では、Qwen3-235B-A22Bは総パラメータが235Bでも、トークンごとに動くのは約22Bだと説明されていました。16GBの消費者向けGPUでも動くとされたのは、この「使う部分が小さい」構造のおかげです。一度に動くのは総量の1割程度なので、残りのエキスパートをCPU側やストレージに置いても、速度の低下を抑えられるわけです。今回の道具たちも、同じ理屈をより扱いやすく整えたものと言えそうです。
しかし、新しい道具たちにはまだ実績の数字がありません。BigMoeOnEdgeのHN投稿は、現時点で1ポイント・コメント0件です[1]。ツールカタログの掲載でも、料金プランは未確認で、レビューはまだ1件もありません[3]。機能の欄には「AIアシスタント」「ワークフロー自動化」といった一般的なタグが並ぶだけで、実態はまだ掴めません[3]。素材にも、これらの実装の実測速度(TPS)を示す数値は見つかりませんでした。参考までに、以前取り上げたik_llama.cppフォークの実測では、6GBのRTX 2060で、decode(トークンを1つずつ生成する段階)の速度が毎秒45〜48トークンでした。新しい道具が同じ土俵でどれだけ出せるかは、今後の検証待ちです。
アイデア(エキスパートを必要なときだけ読む)はほぼ固まり、段階は「誰でも使える形への整備」と「数値での検証」へ進んでいます。llama-serverと同じ使い方の実装[2]や、手順をまとめたガイド[4][5]は前者の動きです。実測値が出そろえば、スマホやノートでどこまで実用になるかが見えてくるはずです。巨大モデルをクラウドに預けず、端末内で完結させる選択肢は、また一つ現実的になってきたようです。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: GitHub – jklincn/llama.moe: Optimized inference of MoE models based on … — https://github.com/jklincn/llama.moe
A lightweight inference framework for Mixture-of-Experts (MoE) models, built on top of llama.cpp with dynamic expert offloading.
sudo apt update
sudo apt install build-essential cmake ccache libcurl4-openssl-dev ninja-bu - Web記事 記事全文: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://www.toolcenter.ai/en/tools/a-layer-on-top-llama-cpp-enabling-big-moe-streamin
Pricing
Detailed plans have not been confirmed in our catalog. Check the official website for current limits and billing terms.
Visit Website
Prices and limits may change. Confirm the currency, billing period, seat minim - Web記事 Web検索: Performant local mixture-of-experts CPU inference with GPU acceleration … — https://huggingface.co/blog/Doctor-Shotgun/llamacpp-moe-offload-guide
Performant local mixture-of-experts CPU inference with GPU acceleration …
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: llama.cpp’s MoE Expert Offload: –n-cpu-moe and Streaming, Explained — https://www.shawnmayzes.com/ai-engineering/llama-cpp-moe-expert-offload-explained/
llama.cpp’s MoE Expert Offload: –n-cpu-moe and Streaming, Explained
- Web記事 Web検索: BigMoeOnEdge Streams MoE Models Larger Than RAM on Phones — https://letsdatascience.com/news/bigmoeonedge-streams-moe-models-larger-than-ram-on-phones-052a7b6a
BigMoeOnEdge Streams MoE Models Larger Than RAM on Phones
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS