16GBのGPUで235Bの巨大モデルが動く——以前この連載で取り上げたllama.cppのMoEオフロード(重みをGPUの外に置いて動かす技)に、新しい動きが出てきました。Hacker Newsに「BigMoeOnEdge」というラッパーが投稿されたのです。llama.cppの上にもう一枚の層を重ね、スマホやノートPCでも巨大なMoEモデルをストリーミングで動かせるようにする試みです[1]。投稿は作者が自作の道具を紹介する「Show HN」の形式です。
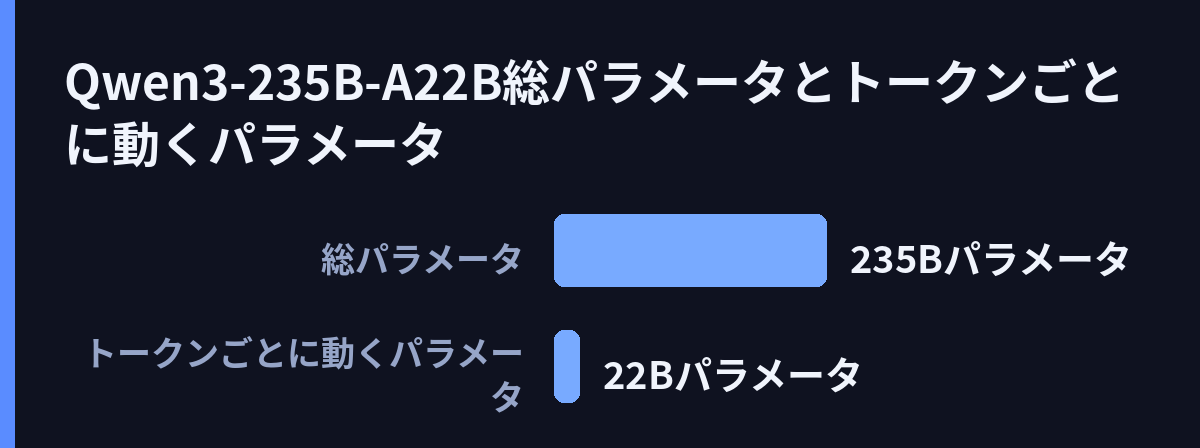
なぜ少ないメモリで済むのか。鍵はMoE(混合エキスパート)という構造にあります。トークンごとに必要な一部の「エキスパート」だけを動かし、残りは休ませる仕組みです。解説記事[2]によると、Qwen3-235B-A22Bは総パラメータが235Bでも、トークンごとに動くのは約22B。名前だけ見るとH100のラックが要るように思えますが、動かすだけなら話は別だといいます[2]。重みの置き場所さえ工夫すれば、VRAMの壁を越えられるというわけです。16GBの消費者向けGPUでも動くと説明されています[2]。ただ、ローカルAIを動かしている人の大半は、こうした設定に触れたことがないといいます[2]。
興味深いのは、定番のやり方では性能を残してしまうという指摘です。GPUに載せる層の数を指定する基本のオプション(-ngl)は、99にすると実質すべてをGPUに載せようとします。denseモデル(全パラメータを毎回動かす通常の構造)ならそれで正解です。しかしMoEでは話が違い、層の中身までは見てくれません。小さなattention(注目処理)のテンソルまでGPUに載ってしまいます。テンソルとは重みのひとかたまりです。計算は軽いのに、VRAMを食う張本人の巨大なエキスパート重みと一緒に、貴重なGPUメモリを占めるといいます[2]。
そこで役立つのが、MoE専用のオプション(–n-cpu-moe)です。例えば前半40層分のエキスパート重みをシステムRAMに移し、それ以外はGPUの速さを保つ、という分担が組めます[2]。さらに細かく詰めたい場合には、正規表現で名前のパターンを指定し、テンソルの配置を個別に決める方法もあります。層ごとの一括指定よりも、多くの部分をGPUに載せられるそうです[2]。適切なテンソルを適切な場所に振り分けることが、そのまま全体のトリックになるといいます[2]。
細かいチューニングも効いてきます。バッチサイズ(一度にまとめて処理する量)の既定値は2048と512で、GPUだけで推論する前提の数値です。CPUとGPUに作業を分けると小さすぎて、受け渡しがボトルネックになりかねません。このためガイドでは、1024以上に引き上げるのが定番のようです[2]。コンテキスト長(モデルが一度に覚えていられる会話の領域)の指定も、併せて調整します[2]。
周辺でも動きが活発です。Hugging Faceには、MoEモデルをCPUとGPUで分担させて速く動かすガイドが公開されています。CPU主体の推論にGPUで補助する構成を、具体的な手順付きで解説したものです[4]。基本のオプションとMoE専用オプションの違いを比べる記事も現れました[4]。大規模MoEの推論性能を環境横断で最適化するガイドも共有されています[4]。研究の側では、エキスパートのオフロードを混合精度(重要な部分とそうでない部分で精度を変える手法)で高速化するHOBBITという研究もあります[4]。
しかし、今回の目玉であるはずのラッパー自体は、まだ火がついていません。Hacker Newsでの投稿は1ポイント・コメント0件です[1]。ツール紹介サイトにも掲載されていますが、料金は未確認でレビューもなく、AIアシスタントや自然言語インターフェースといった機能紹介にとどまっています[3]。スマホやノートPCでの実測値は、素材からは見つかりませんでした。中身はllama.cppのオフロード技術を包んだものと思われますが、実力の裏付けはこれからのようです。
以前取り上げた実測では、8GBのGPUで35Bモデルが動きました。その後16GBで235Bまで届き、今回はその仕組みが解説され、ラッパーや研究まで裾野が広がった形です。以前お伝えした通り、エッジ側では重みの「置き場所」が最大の壁です。その壁の越え方が、選択肢として増えてきた段階です。あとはラッパー側に実測の数字が出そろうか。そこが次の注目点と思われます。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide … — https://aliteq.com/llama-cpp-moe-offloading-run-bigger-models-less-vram
Qwen3-235B-A22B sounds like a model that needs a rack of H100s. It doesn’t — not to run it, anyway. It has 235 billion total parameters, but only about 22 billion of them activate for any given token, because it’s a mixt
- Web記事 記事全文: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://www.toolcenter.ai/en/tools/a-layer-on-top-llama-cpp-enabling-big-moe-streamin
Pricing
Detailed plans have not been confirmed in our catalog. Check the official website for current limits and billing terms.
Visit Website
Prices and limits may change. Confirm the currency, billing period, seat minim - Web記事 Web検索: Performant local mixture-of-experts CPU inference with GPU acceleration … — https://huggingface.co/blog/Doctor-Shotgun/llamacpp-moe-offload-guide
Performant local mixture-of-experts CPU inference with GPU acceleration …
- Web記事 Web検索: Standard -ngl vs –cpu-moe: Offloading Mixture of Experts in llama.cpp … — https://www.whichllmmodel.com/blog/ngl-vs-cpu-moe-offload-for-moe-models
Standard -ngl vs –cpu-moe: Offloading Mixture of Experts in llama.cpp …
- Web記事 Web検索: HOBBIT: A Mixed Precision Expert Offloading System for Fast MoE Inference — https://arxiv.org/html/2411.01433v2
HOBBIT: A Mixed Precision Expert Offloading System for Fast MoE Inference
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS