「GPUは計算が速すぎて、メモリとのデータの往復がボトルネックになる」——NVIDIAの公式ブログは、GPUプログラミングでよくある問題をこう説明しています[2]。その解決策として注目されているのがカーネル融合です。GPU上で動く小さな処理単位(カーネル)を1つにまとめ、中間結果をメモリに書き出さずに済ませる最適化のことです。

ブログでは、配列の絶対値を取って合計するという単純な処理が例に挙げられています。素朴な実装では2つのカーネルが中間バッファを介してやり取りするため遅く、融合すれば中間結果をレジスタに留められてメモリ転送が減ります[2]。なお、連続するカーネル起動をまとめて発行するCUDA Graphsは別の層の仕組みで、カーネル本体の融合とは補完関係です[2]。
このたび、オープンソースの推論エンジンllama.cppに、FFN(モデル内部で特徴を変換する層)のgate/up行列積とGLUを1つのCUDAカーネルにまとめるPRが投稿され、話題になっています[1]。GLUは、2つの計算経路の一方がもう一方の通過量を調整するゲート機構です。SwiGLUのようなゲート付きFFNは現代のLLMで標準的な構造になっており[4]、ここが速くなれば推論全体に効きます。PRは「gate/upの行を交互に並べる」方式で、量子化(重みを圧縮してメモリを節約する仕組み)向けの行列計算とゲート処理を1つのパスで処理します[1]。
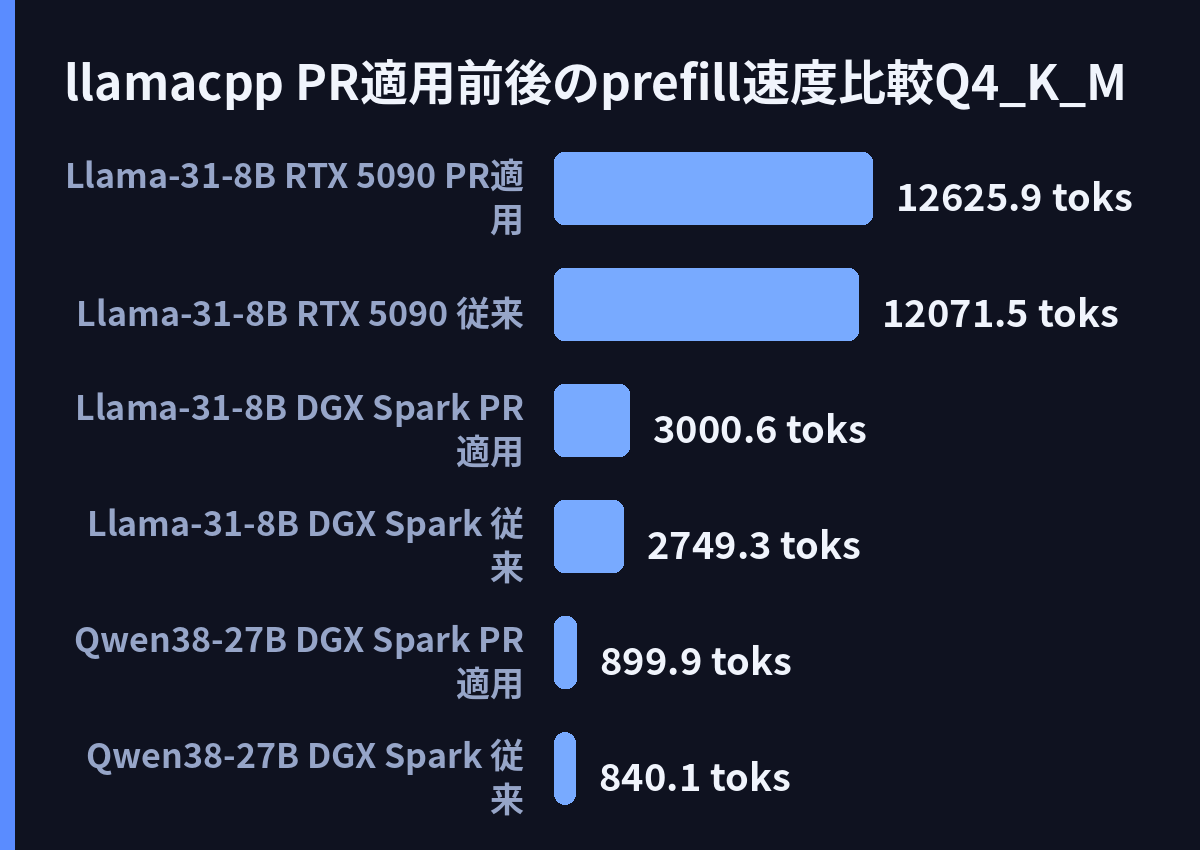
実測値がこのPRの魅力です。DGX Spark(GB10)でのベンチマークでは、Qwen3.8-27BのQ4_K_Mが840.1から899.9 tok/s(1秒間に処理できるトークン数)へと+7.1%。Llama-3.1-8BのQ4_K_Mは2749.3から3000.6 tok/sへ+9.1%で、量子化の型によっては+10.7%に達します[1]。測定はprefill(プロンプト全体を一括処理する段階)の速度です。一方、RTX 5090では同じLlama-3.1-8Bが12071.5から12625.9 tok/s(+4.6%)など、伸びは+1.9%〜+4.6%にとどまりました[1]。同じ最適化でも、環境によって効果の大きさが変わるようです。同方向の解説記事もすでに公開されており、gate・up・SwiGLUを1つのCUDAパスにまとめるprefill融合が取り上げられています[4]。NVIDIA自身も、cuDNN frontendのリポジトリでcutedsl_fusion_kernelsという融合カーネルのベンチマーク集を公開しています[4]。有名な成功例がFlashAttention-2で、メモリ往復を減らすアテンション実装として論文でもカーネル融合の事例として詳しく解説されています[4]。
しかし、融合が常に成功するわけではありません。NVIDIAのフォーラムには、Tesla V100 32GBで独自の推論エンジンを開発する独立研究者の興味深い報告があります[3]。ffn_downという層の単体最適化では、処理時間を約153ミリ秒から137ミリ秒へ短縮できました。ところがこの変更を入れると、gate-up-SiLU(ゲート2つの行列計算と活性化関数を1カーネルにまとめた融合)が無効化され、gate/up部分が約206ミリ秒から318ミリ秒へと逆に悪化します。全体のTPOT(1トークン生成にかかる時間)も11.96ミリ秒から12.19ミリ秒へ遅くなり、この最適化パスは取りやめとなりました[3]。

同じ報告に、地味ながら確実な改善も記録されています。計測ツールNsight Systemsでの調査で、デバイス情報を取得するcudaGetDevicePropertiesがカーネル起動のたびに呼ばれている(36層×32ステップで1152回)ことが判明しました。初期化時に1回だけ取得して静的にキャッシュする修正で、71.34から73.03 tok/sへと速度が上がっています[3]。目立たないオーバーヘッドの積み重ねも、推論速度には無視できないということです。
カーネル融合の本質は、「計算よりメモリ往復が律速になる」というGPUの性質への対処です[2]。今回の素材が示すのは、その効果がハードウェアや量子化の型で変わること[1]、そして単体の高速化が全体を悪化させるトレードオフがあり得ること[3]です。オープンソース推論エンジンの進化は、こうした一つひとつの検証の積み重ねで支えられているようです。
引用ソース
- Reddit Reddit r/LocalLLaMA: CUDA: fuse FFN gate/up matmuls and GLU in MMQ with interleaved gate/up rows by anujj · Pull Request #29948 · ggml-org/llama.cpp — https://www.reddit.com/r/LocalLLaMA/comments/1xey0uw/cuda_fuse_ffn_gateup_matmuls_and_glu_in_mmq_with/
CUDA: fuse FFN gate/up matmuls and GLU in MMQ with interleaved gate/up rows by anujj · Pull Request #29948 · ggml-org/llama.cpp
- Web記事 記事全文: Kernel Fusion in NVIDIA CUDA: Optimizing Memory Traffic and Launch … — https://developer.nvidia.com/blog/kernel-fusion-in-nvidia-cuda-optimizing-memory-traffic-and-launch-overhead/
There are many ways to optimize code for GPUs. In this post, you’ll learn how kernel fusion can improve memory bandwidth and reduce kernel launch overhead, along with multiple ways to apply it in NVIDIA CUDA code.
A comm - Web記事 記事全文: Scenario 1: Custom CUDA Kernel, cuBLAS errors, memory allocation issues … — https://forums.developer.nvidia.com/t/scenario-1-custom-cuda-kernel-cublas-errors-memory-allocation-issues-stream-context-corruption-gate-up-silu-3-in-1-fused-kernel-cublas-status-13/372840
Full Post Body
Environment
– GPU: Tesla V100 32GB (SM70)
– Stack: Custom LLM inference engine xLLM, Q4_K quantized FFN fused CUDA kernels
– Role: Independent Researcher, self-maintained inference framework with 70+ repos - Web記事 Web検索: A Case Study in CUDA Kernel Fusion: Implementing FlashAttention-2 on … — https://arxiv.org/html/2312.11918v1
A Case Study in CUDA Kernel Fusion: Implementing FlashAttention-2 on …
- Web記事 Web検索: SwiGLU and Gated Linear Units: How Bilinear Gating Replaced Standard … — https://www.llms.blog/posts/swiglu-and-gated-linear-units-how-bilinear-gating-replaced-standard-ffns-in-modern-llms
SwiGLU and Gated Linear Units: How Bilinear Gating Replaced Standard …
- Web記事 Web検索: cudnn-frontend/benchmark/cutedsl_fusion_kernels at develop · NVIDIA … — https://github.com/NVIDIA/cudnn-frontend/tree/develop/benchmark/cutedsl_fusion_kernels
cudnn-frontend/benchmark/cutedsl_fusion_kernels at develop · NVIDIA …
- Web記事 Web検索: llama.cpp Q4_K Prefill Fusion: Gate, Up, and SwiGLU in One CUDA Path — https://ramgpt.org/articles/llama-cpp-q4-k-gate-up-swiglu-fusion-prefill/
llama.cpp Q4_K Prefill Fusion: Gate, Up, and SwiGLU in One CUDA Path
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS