JVM(Javaのプログラムを動かす土台)の上で、AIモデルを直接動かす挑戦が、静かに広がっています。その代表格が、「依存関係ゼロのJARファイル1つで、llama.cppより速くローカル推論ができる」というHacker Newsの投稿です[1]。この投稿は以前この連載でも取り上げたもので、スコアは1ポイント、コメントは0件のままです[1]。つまり速さの主張は、まだ誰にも検証されていません。
注目したいのが、同じ「JVMで動かす」路線の純Java実装「llama3.java」です[2]。Llama 3、3.1、3.2の推論を、Javaファイル1つに収めたプロジェクトです[2]。もともとはAndrej Karpathy氏の教育用プロジェクト「llama2.c」をJavaに移植した「llama2.java」の後継です[2]。外部ライブラリに依存せず、GGUF形式(推論用モデルファイルの標準的な形式)の解析も自前でこなします[2]。Llama 3.1の長い文脈への対応や、3.2の埋め込みの共有など、バージョンごとの違いも吸収しています[2]。
中身には、Javaならではの工夫が並んでいます。高速化の要は、JavaのVector API(1回の命令で複数の数値をまとめて計算できる機能)を使った行列計算です[2]。重みは、メモリを節約する量子化と呼ばれる圧縮の仕組みに幅広く対応しています[2]。Q4_0やQ8_0など、圧縮率の異なる複数の形式を選べます[2]。ただし落とし穴もあります。世に出ているQ4_0のモデルは「純粋」なものが少なく、埋め込み部分などの重みがより高精度な形式で保存されていることが多いといいます[2]。llama.cppの量子化ユーティリティを使えば、純粋なQ4_0のファイルを作り直せるようです[2]。
使い勝手の面でも工夫が見えます。GraalVMのNative Image(Javaプログラムを事前にネイティブコードへ変換する機能)に対応しました[2]。さらに、モデルを事前に読み込むAOTプリロードを使えば、最初のトークンが出るまでの待ち時間をほぼゼロにできるといいます[2]。実行にはJava 21以上が必要です[2]。jbangというツールを使えば、ソースファイルをそのままコマンドとして実行できます[2]。2024年にはカンファレンス「Devoxx Belgium」でも発表されています[2]。
エンジンを「使う側」の整備も進んでいます。オープンソースのJavaライブラリ「llm4j」は、OpenAI、HuggingFace、自己ホスト型のLLMを同じ書き方で扱える統一インターフェースを提供します[3]。Pythonのlangchainに着想を得たもので、Springアプリへの組み込みを想定しています[3]。動作要件はJava 8以上と、エンジン側よりずっと緩いのも特徴です[3]。ローカルで動かすエンジンも外部APIも、同じコードの書き方で扱えるようにする狙いのようです[3]。
しかし、ここで視点を変えてみます。llama3.javaの作者は、プロジェクトの目的を「教育的な価値に加え、JVMのコンパイラ最適化、とりわけGraalコンパイラの試験とチューニングに使う」と明言しています[2]。純Java推論は、llama.cppに勝つことそのものより、Javaのコンパイラを鍛える実験場としての意味が大きいようです[2]。一方、2026年のローカル推論エンジンを巡る比較記事では、Ollama、vLLM、llama.cpp、SGLang、TGIといった名前が並びます[4][5][6][6][6]。タイトルから確認できるかぎり、JVM製の名前はこの並びにはありません。素材には、比較の中身となる具体的な数値も見つかりませんでした。
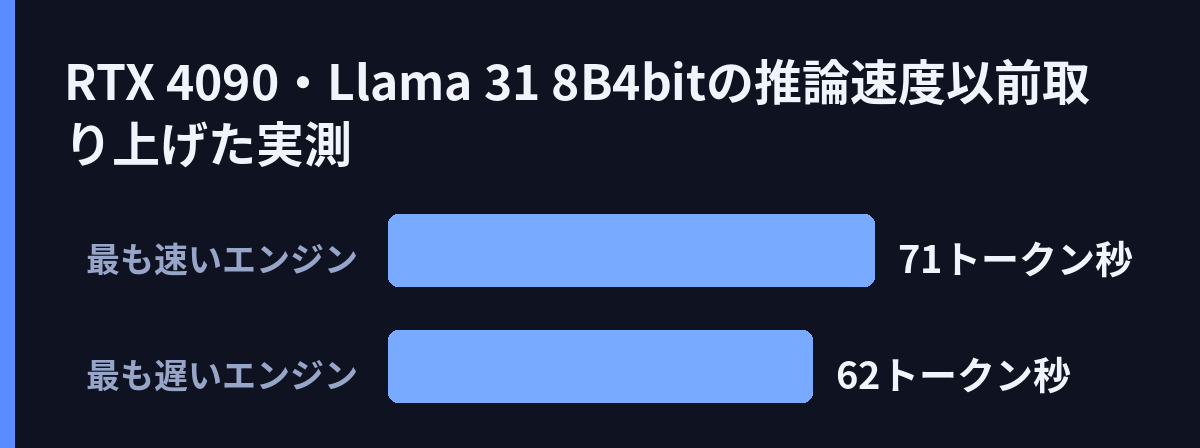
では、超えるべき壁はどのあたりにあるのでしょう。以前この連載で取り上げた実測では、RTX 4090でLlama 3.1 8B(4bit量子化)を動かした場合、主要3エンジンの速度はおよそ62〜71トークン/秒に収まっています。複数リクエストをまとめて処理する継続的バッチ処理では、GPU使用率を85〜92%に保てるという数値でした。JVM陣営が比較記事の名前に連なるには、この水準での実測提示がひとつの目安になりそうです。
速さの主張が検証を待つ間も、Java陣営は二つの方向へ動いています。ひとつは、推論エンジンを通じてJava自身のコンパイラ技術を鍛える方向です。もうひとつは、llm4jのような既存アプリとの接続層を厚くする方向です。エコシステム全体で育てる進め方に、Javaならではの戦略が見えてきます。次に注目したいのは、コメント0件の状態が崩れるかどうか、そして実測の数値が現れるかどうかです。
引用ソース
- Hacker News Hacker News: Local inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://qxotic.ai/
Local inferencing in one JVM JAR, dependency free, faster than llama.cpp
- Web記事 記事全文: GitHub – mukel/llama3.java: Llama 3+ inference in pure Java — https://github.com/mukel/llama3.java
Practical Llama 3, 3.1 and 3.2 inference implemented in a single Java file.
This project is the successor of llama2.java based on llama2.c by Andrej Karpathy and his excellent educational videos.
Besides the educational - Web記事 記事全文: GitHub – yoazmenda/llm4j: Open-source java library for developing … — https://github.com/yoazmenda/llm4j
llm4j is an open-source Java library that provides a unified interface for interacting with various Large Language Models (LLMs) such as OpenAI, HuggingFace, and custom/self-hosted LLMs. Inspired by Python’s langchain, l
- Web記事 Web検索: Local Inference Benchmark (July 2026) — Ollama vs vLLM vs llama.cpp … — https://plugsky.com/local-inference-benchmark
Local Inference Benchmark (July 2026) — Ollama vs vLLM vs llama.cpp …
- Web記事 Web検索: vLLM vs llama.cpp (2026): What Official Docs and Public Benchmarks … — https://markaicode.com/benchmarks/vllm-vs-llamacpp-performance/
vLLM vs llama.cpp (2026): What Official Docs and Public Benchmarks …
- Web記事 Web検索: Best LLM Inference Engines 2026: vLLM vs SGLang vs TGI vs llama.cpp — https://deploybase.ai/articles/best-llm-inference-engine
Best LLM Inference Engines 2026: vLLM vs SGLang vs TGI vs llama.cpp
- Web記事 Web検索: LLM Inference Engines Compared: vLLM, SGLang, Ollama & llama.cpp — https://leetllm.com/blog/llm-inference-engine-comparison-2026
LLM Inference Engines Compared: vLLM, SGLang, Ollama & llama.cpp
- Web記事 Web検索: Local LLM Inference Engines Compared: The Definitive 2026 Guide — https://www.local-llm.net/compare/inference-engines-2026/
Local LLM Inference Engines Compared: The Definitive 2026 Guide
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS