JAR1本でaiを動かす、という話です。Hacker News(hackerニュース)には、依存なしのJARでローカル推論を動かす投稿が上がりました。タイトルは「llama.cppより速い」としています。投稿の注目度はまだ小さく、2ポイント、1コメントです[1]。
投稿者本人のコメントでは、Quixotic AIはJVM向けのAIスタックだと説明されています。CPU上ではllama.cppと競合する性能を挙げています。APIは単純で、部品を単体でも使えると述べています。対応モデルにはGemma 4、Qwen 3.5+、LFM 2.5などが挙げられています。flashのような名称は素材にはありません。全体は2.6MBのfat .jarに収まり、追加依存はないとされています[3]。
この流れを支える仕組みとして、コミュニティが維持するModelJarsというJAR規約も注目されています。WebJarsのように、モデルを通常のJVM依存として扱えるようにするマーカーJAR(目印のJAR)の規約です。大きな重みは外部に置き、小さくライセンスに合うものはJARに同梱できます。同梱した重みも、外部モデルと同じサイズとSHA-256(改ざん検知用の指紋)で検証されます。JARには性能や資格、モデルIDなどのメタデータが入ります[2]。
ModelJarsのベンチマーク記事では、同じモデルファイルとプロンプトで複数エンジンを比較する方針が書かれています。llama.cppやOllamaは比較対象で、ModelJarsの依存ではないと明記されています。CPU実行では、プロセッサ制限、コンテキスト(会話の記憶)、サンプリング(出力の選び方)、ウォームアップ(試走)、試行回数を固定しています[4]。
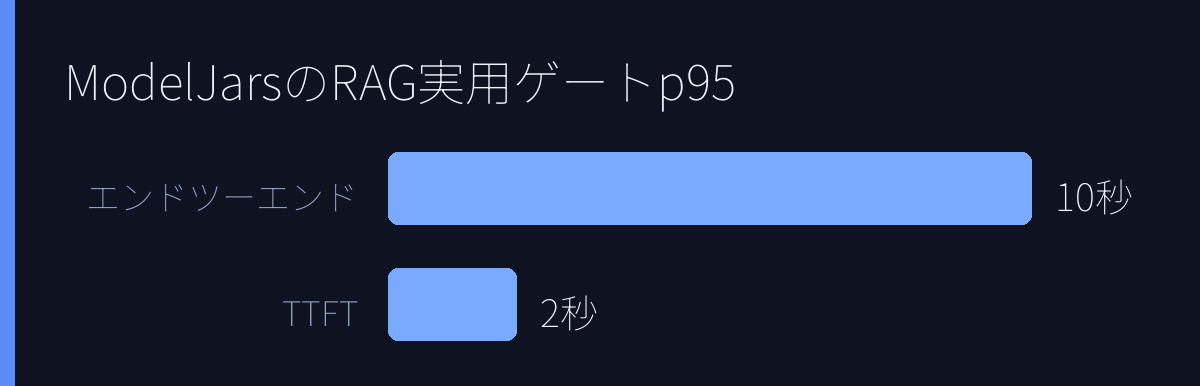
RAG(検索結果を根拠に回答する仕組み)では、実用ゲートが示されています。90%以上の根拠品質、100%の不支持質問への拒否、p95 TTFTの2秒以下、p95エンドツーエンドの10秒以下です。p95は95%のケースまでの値です。TTFTは最初のトークンまでの待ち時間です。Guarded RAGでは、引用と根拠チェックを通る時だけモデル回答を使い、通らなければ検索結果からの抽出か拒否にします。prefill(プロンプト全体を一括処理する段階)とdecode(トークンを1つずつ生成する段階)の速度は、素材に具体的な数値はありません[4]。
アプリ側では、Java 25のベンチマークハーネスを使います。9つの検索ケースの検証セットを1ウォームアップ、3回計測、同時実行数1で比較しています。Javaアプリ内で動くModels、ローカルネイティブサーバー、ホスト型プロバイダ(外部クラウド)を同じJavaアプリから試す設計です。モデルのバイト列、レポート、バックエンド版、ポリシー、ホスト、JVM、指標がメタデータに保存されます[4]。ModelJarsのGitHubリポジトリも検索結果に上がっています。
ただし、タイトルは速さを主張しますが、作者コメントでは競合と表現されています。ModelJarsでも、合格した候補が自動的な推奨とは限りません[4]。JAR1本は便利ですが、モデルの重みは外部に置く前提です[2]。RAGの資格情報では、テスト済みセッション容量(会話で保持できる長さ)を使うと説明されています。明示的な実行時設定が優先されます[2]。
それでも、JVMローカル推論は、JAR依存とメタデータで配布・検証を整える方向です。実運用には、モデルの重み、ライセンス、JVMバージョンの差、RAGの品質ゲートまで見る必要があります。検索結果には、Ollamaやllama.cpp、vLLMの比較記事や2026年ガイドも並び、ローカルaiの選択肢は増えています[6][6][6]。速度を測るinferbenchのようなリポジトリも上がっています[5]。
引用ソース
- Hacker News Hacker News: Local inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://qxotic.ai/
Local inferencing in one JVM JAR, dependency free, faster than llama.cpp
- Web記事 記事全文: GitHub – ModelJars/modeljars: Community-maintained JVM marker JAR … — https://github.com/ModelJars/modeljars
ModelJars is a community-owned marker-JAR convention for local and remote model artifacts. It borrows the useful WebJars idea of using normal JVM dependency coordinates and classpath metadata. Large model weights remain
- HNコメント HNコメント: cal inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://news.ycombinator.com/item?id=50223693
Quixotic AI is a serious attempt to bring an end-to-end AI stack to the JVM. Performance is already competitive with llama.cpp (on CPUs), the APIs are crafted to be simple and easy to use. Every component in the stack ca
- Web記事 記事全文: Inference and RAG benchmarks – modeljars.org — https://modeljars.org/benchmarks/
Local inference
Models compared with native engines
The table contains the qualified artifacts with controlled cross-engine studies. Each row uses identical artifact files, prompts, and generation controls for every engi - Web記事 Web検索: GitHub – JoniMartin27/inferbench: Benchmark local LLM inference speed … — https://github.com/JoniMartin27/inferbench
GitHub – JoniMartin27/inferbench: Benchmark local LLM inference speed …
- Web記事 Web検索: Local AI Runtime Comparison: Ollama vs llama.cpp vs vLLM and more — https://d-central.tech/local-ai-runtime-comparison/
Local AI Runtime Comparison: Ollama vs llama.cpp vs vLLM and more
- Web記事 Web検索: Local LLM Inference Engines Compared: The Definitive 2026 Guide — https://www.local-llm.net/compare/inference-engines-2026/
Local LLM Inference Engines Compared: The Definitive 2026 Guide
- Web記事 Web検索: Benchmarking Local LLMs in 2026: Speed, Quality, Resource Usage — https://dasroot.net/posts/2026/04/benchmarking-local-llms-speed-quality-resource-usage/
Benchmarking Local LLMs in 2026: Speed, Quality, Resource Usage
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS