VRAM(GPUの専用メモリ)に収まらないMoEモデルが、CPUの助けで一気に速くなるようです。Redditでは、tandem.cppがQwen3.8-Flash-NextをRTX 4090と64GB RAMで動かしたと報告されています[1]。速度は97.3 tok/s(1秒あたり97.3トークン)で、llama.cppの29.8 tok/sから3.3倍です[1]。MoEは、専門分野を分担する複数の小さな回路のうち、毎回必要なものだけ動かす仕組みです。
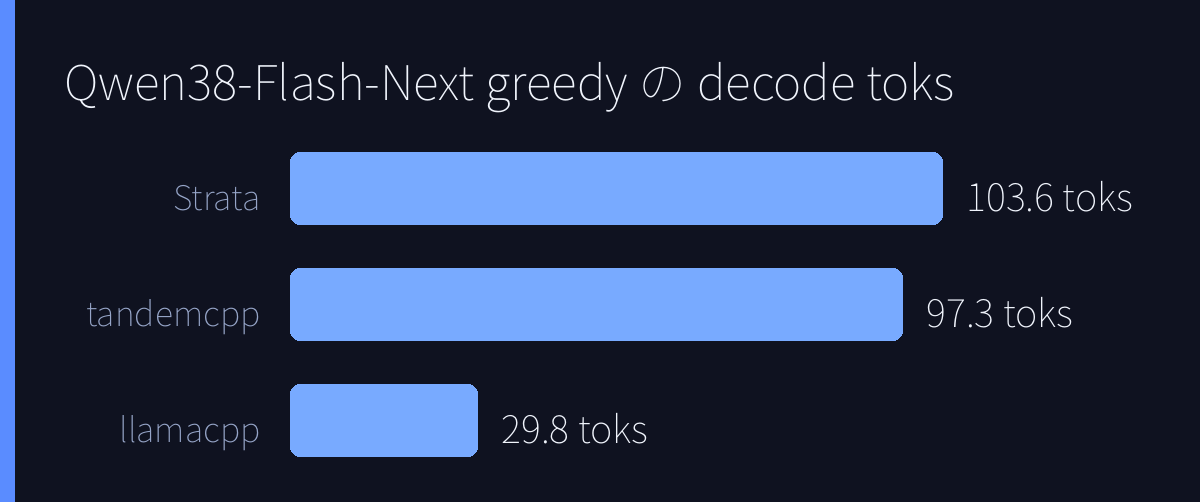
この速さの狙いは、単一ユーザーのdecode(トークンを1つずつ生成する段階)です。tandem.cppはllama.cpp向けの改造で、よく使う専門回路をGPUに置き、残りをCPUで補います[1]。llama.cppが対応するMoEなら使えるとされています[1]。試行環境はi5-12400F、64GB DDR4、RTX 4090 1枚で、量子化は重みを圧縮してメモリを節約する仕組みです[1]。試行ではIQ3_Sが使われており、MTPは次のトークンを先読みする仕組みです[1]。GSM8Kのdecode速度がgreedy設定で比較されています[1]。
Qwen3.8-Flash-Nextは、125B本体に51BのN-gram埋め込みを足したMoEで、1トークンあたり6Bだけ動かします[2][4]。N-gram埋め込みは、直前の語句から表を引いて容量を増やす仕組みで、本体計算と重ねてCPUメモリに置ける点が特徴です[2]。tandem.cppのGPU/CPU分担と相性がよさそうです[1]。公式は2026年8月26日に重みを公開し、Qwen4のアーキテクチャの先行公開としています[2]。公式は学習コストがQwen3.7-Plusの約1/9だと説明し、コーディングや事務作業に強いとしています[2][4]。
一方、Strata(別の推論エンジン)も同じ条件で103.6 tok/sと報告されています[1]。ただしStrataの103.6 tok/sは、すべての専門回路を実際に計算する厳密モードでの値です[1]。Strataの既定は、低ランクの専門回路を飛ばす近似で、127.1 tok/sになる代わりに品質が変わる可能性があります[1]。tandem.cppはQwen3.8向けに調整されており、gpt-oss-120bでも1.85倍、他のMoEで1.4〜2.1倍の伸びも示されています[1]。
Xのトレンドには「AIドット絵バトル」が上がっています[3]。その一方で、ローカル実行の現場では、VRAMとRAMの分担が再び注目されているようです[1]。Strataで12GBや16GBのVRAMを使う実測記事もあり、低VRAMでの試行も進んでいます[5]。prefill(プロンプト全体を一括処理する段階)も報告されており、64k(65536トークン)のプロンプトで1.4〜1.8倍速くなったとされています[1]。
ただ、報告では消費電力の実測値は示されていません。速度が上がっても、近似やCPU分担が品質にどう影響するかは判断できません[1]。詳細な品質比較も示されていません[1]。tandem.cppはllama.cpp本体ではなく独立プロジェクトで、ggml-orgとは無関係です[1]。
結論としては、大型MoEでも量子化とGPU/CPU分担が効き、Qwen3.8-Flash-NextはRTX 4090で実用的なdecode速度に近づいています[1]。公式はHugging Face(モデル配布サイト)で重みを公開しています[2]。今後はStrataやllama.cppとの速度差が注目されます[1]。品質との両立が、ローカル利用の分かれ目になりそうです[1][5]。
引用ソース
- Reddit Reddit r/LocalLLaMA: tandem.cpp: Qwen3.8-Flash-Next at 97 tok/s on a single 4090 + 64 GB RAM, 3.3× llama.cpp, works for any MoE — https://www.reddit.com/r/LocalLLaMA/comments/1xldent/tandemcpp_qwen38flashnext_at_97_toks_on_a_single/
tandem.cpp: Qwen3.8-Flash-Next at 97 tok/s on a single 4090 + 64 GB RAM, 3.3× llama.cpp, works for any MoE
- Web記事 記事全文: Qwen3.8-Flash-Next – GitHub — https://github.com/QwenLM/Qwen3.8-Flash-Next/
Welcome to the GitHub repository of the Qwen3.8-Flash-Next.
In this release we are opening the weights of Qwen3.8-Flash-Next, a multimodal MoE model that also serves as an early preview of the architecture used in Qwen4. - X Xトレンド: AIドット絵バトル — https://trends24.in/japan/
AIドット絵バトル
- Web記事 記事全文: Model Specifications and Benchmarks | QwenLM/Qwen3.8-Flash-Next | DeepWiki — https://deepwiki.com/QwenLM/Qwen3.8-Flash-Next/1.2-model-specifications-and-benchmarks
This page documents the core technical specifications and performance characteristics of Qwen3.8-Flash-Next. It details the model’s scale, its hybrid architectural parameters, and the efficiency gains achieved through it
- Web記事 Web検索: Strataで125BのQwen3.8-Flash-NextをVRAM 12GB・16GBで実測|素のllama.cpp・27B・Claude … — https://ai-hardware-zukan.com/qwen38-flash-next-strata-vram-16gb-benchmark/
Strataで125BのQwen3.8-Flash-NextをVRAM 12GB・16GBで実測|素のllama.cpp・27B・Claude …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS