Flash NextにDFlash2を組み合わせると、llama.cppで平均17%速くなったという報告です。コードやリスト生成で伸びる一方、散文では差が小さい場面もありました。ローカル実行の速度と使いどころがわかります。
Flash NextにDFlash2を組み合わせると、llama.cppで平均17%速くなったという報告です。コードやリスト生成で伸びる一方、散文では差が小さい場面もありました。ローカル実行の速度と使いどころがわかります。
AMD が Radeon GPU と GDDR6 メモリの価格を 11 月に引き上げる可能性があるとの報告です。GDDR6 は Q3 に約 8〜10% 上昇し、RX 9070 XT は 1000 ドル近くだとの指摘もあります。買い替えへの影響を整理します。
vLLM v0.32.0では、FP8や4bitのKVキャッシュでメモリを減らし、最大31%の出力スループット向上が報告されました。nightlyのPLE disk offloadやQwen3.8-Flashの補助GPU offloadも話題です。
Quixotic AIが、依存なしの2.6MBのJARでローカルLLM推論を可能にしたと報告しました。CPUではllama.cppと競合する性能を掲げ、JVM単一構成の現実性を示します。一方、実測比較の不足やベンチ環境の整備が課題です。
JVM 向けに 2.6 MB の JAR だけでローカル推論を試す試みが Hacker News に投稿されました。作者は CPU で llama.cpp と競合する性能や Gemma 4 対応を主張しますが、具体的な比較数値は素材にありません。ローカル推論ベンチの文脈で、どこまで独立検証が必要かが見えます。
依存なしのJARでローカル推論を動かすAIスタックがHacker Newsで話題です。作者はCPUでllama.cppと競合する性能と2.6MBのJARを挙げています。ModelJarsではRAG実用ゲートにp95の2秒と10秒が示されています。
ThreadShelfは、複数AIの会話を書き出し、ローカルで検索・継続できるアーカイブです。MCPサーバーは9ツールを備え、Obsidian連携は既定で読み取り専用です。Hacker Newsでの反応や設計から、ローカルAI運用の課題と境界が見えます。
AI推論のFlash Nextで、DFlash2へのアップグレードが話題です。Apple Siliconでの実測では平均17%の速度向上が報告されました。用途や設定で差が出るため、ローカル環境での検証が重要です。
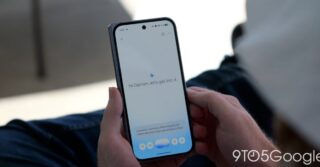
Google は Gemini Spark を Task モードに改名し、背景作業をチャット画面から始められるようにしました。ただし、使えるのは AI Pro と AI Ultra のみで、無料や Plus は対象外です。推論のコストや速度の数値は素材にありません。
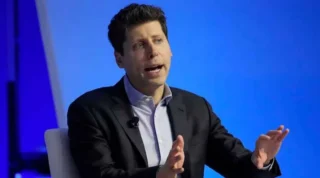
OpenAIのSam Altman氏は、AI安全への懸念を理由に2026年のIPOを見送ると述べました。非公開のS-1提出後に時期をずらし、2027年は未確定です。安全と資金調達の優先順位が変わったことが読み取れます。
2026.11.01
続・NVIDIA:H100の30倍とBlackwellの検証
2026.11.01
続・ChatGPT Pro:Dots枠と自動反映
2026.11.01
続・GPT追跡、監視と価値観で変わるAI選び
RECENT COMMENTS